
Grunnleggende AI
Overvåket vs uovervåket læring

 Legg til Unite.AI blant dine foretrukne kilder på Google
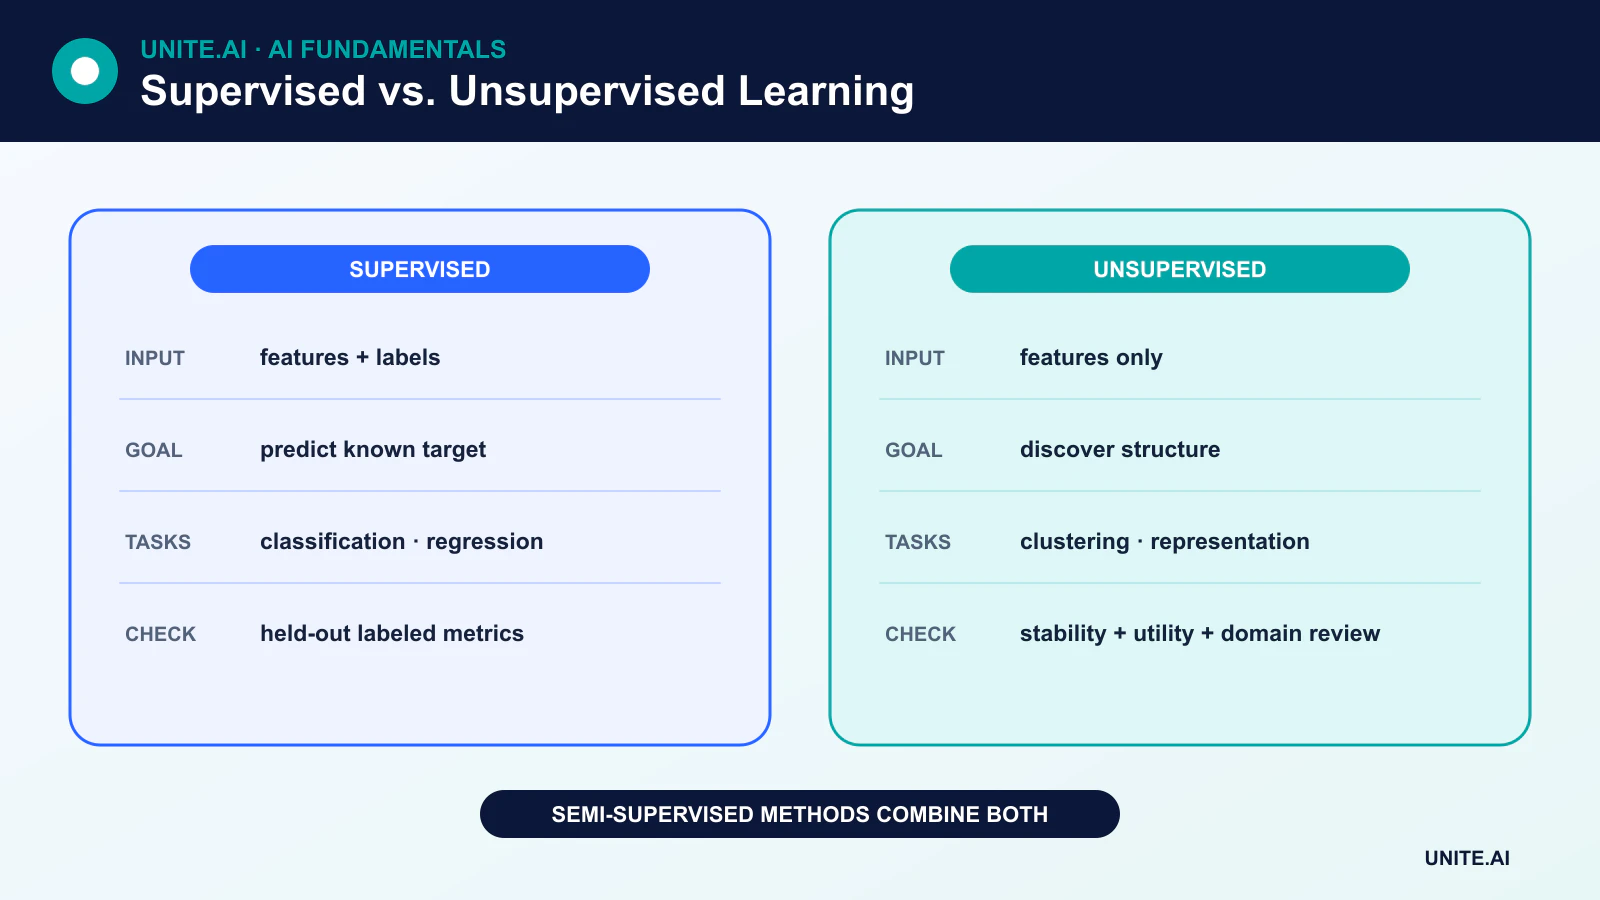
Overvåket læring lærer fra eksempler paret med målrettede svar. Uovervåket læring leter etter struktur i data uten mål‑etiketter. Forskjellen er ikke hvilken tilnærming som er mer intelligent eller nøyaktig; det er typen læringssignal som er tilgjengelig og spørsmålet systemet er designet for å besvare.
Dette er to store paradigmer innen maskinlæring, men moderne systemer bruker også semi‑overvåket, selv‑overvåket og forsterkningslæring.
Viktige punkter
- Overvåket læring forutsier et kjent mål; uovervåket læring oppdager mønstre eller representasjoner.
- Klassifisering og regresjon er overvåkede oppgaver; klynging, tetthetsestimering og mange dimensjonsreduksjonsmetoder er uovervåkede.
- Uovervåkede resultater er ikke automatisk virkelige klasser og kan være vanskeligere å evaluere.
- Beregningskostnad og nøyaktighet avhenger av algoritmen, data, oppgave og evaluering – ikke kun paradigmet.
Hvordan overvåket læring fungerer
Et overvåket datasett inneholder funksjoner X og et mål y. Trening justerer en modell slik at dens forutsigelser nærmer seg målene. Evaluering bruker hold‑out merkede eksempler for å estimere hvor godt den generaliserer.
Klassifisering
Klassifisering forutsier en kategori: spam eller ikke‑spam, ett dokumentemne blant flere, eller ett eller flere objekter i et bilde. Relevante måleverdier inkluderer presisjon, tilbakekalling, F1, kalibrering og kostnadssensitive mål. Nøyaktighet kan være misvisende når en klasse er sjelden; en forvirringsmatrise viser hvilke klasser som forveksles.
Regresjon
Regresjon forutsier en kontinuerlig verdi, som etterspørsel, varighet eller temperatur. Lineær regresjon kan bruke én eller mange funksjoner; den er ikke begrenset til å beskrive et forhold mellom to variabler. Regresjonsmål inkluderer gjennomsnittlig absolutt feil, rot‑gjennomsnittlig kvadratfeil og oppgavespesifikke kostnader.
Vanlige overvåkede algoritmer
Overvåkede metoder inkluderer lineære og logistiske modeller, beslutningstrær, random forests, gradientboosting, støttevektormaskiner, K‑nærmeste naboer og nevrale nettverk.
Logistisk regresjon gir en score eller sannsynlighet som kan konverteres til en klasse ved hjelp av en valgt terskel. Et blad i et beslutningstre inneholder en forutsigelse basert på en region i funksjonsrommet, ikke nødvendigvis én treningsobservasjon. KNN forutsier fra nærliggende merkede treningseksempler og krever fortsatt et solid design for trening/validering/test.
Hvordan uovervåket læring fungerer
Uovervåket læring mottar funksjoner uten en mål‑kolonne. Målet defineres indirekte – for eksempel å minimere avstand innen klynger, rekonstruere et input, estimere datatettleik, eller beholde så mye varians som mulig i færre dimensjoner.
Klynging
K‑means tilordner punkter til et valgt antall klynger og oppdaterer klynge‑sentrene for å redusere kvadrert avstand innen klyngen. Algoritmen oppdager geometriske grupper under en bestemt avstand og funksjonsrepresentasjon. Disse gruppene tilsvarer ikke automatisk meningsfulle kundetyper, diagnoser eller andre domenespesifikke etiketter.
Dimensjonsreduksjon
Dimensjonsreduksjon representerer data med færre variabler. Hovedkomponentanalyse finner ortogonale retninger som beholder så mye varians som mulig under en lineær projeksjon. Andre metoder bevarer ulike strukturbegreper og kan gi svært ulike visualiseringer.
Avvik og tetthetsestimering
Uovervåkede metoder kan estimere hvor data er tett og flagge uvanlige observasjoner. En avviks‑score beviser ikke svindel, feil eller ondsinnet oppførsel; den identifiserer en avvik under den valgte representasjonen og modellen.
Hvordan uovervåket læring evalueres
Det finnes ingen universell forståelse av uovervåket «nøyaktighet». En praktikant kan bruke interne måleverdier som silhuett‑score, sammenligne stabilitet på tvers av prøver, teste nytte i en etterfølgende oppgave, eller spørre domenespesialister om den oppdagede strukturen er meningsfull. Hvis sannhets‑etiketter finnes for evaluering, kan eksterne klyngingsmål brukes uten å gjøre treningsprosessen til overvåket læring.
Utover den todelte sammenligningen
Semi‑overvåket læring
Semi‑overvåket læring kombinerer et mindre merket datasett med et større umerket sett. Pseudo‑merking, konsistensregularisering og graf‑baserte metoder er eksempler. Det umerkede datasettet må fortsatt ligne målfordelingen tilstrekkelig for å være nyttig.
Selv‑overvåket læring
Selv‑overvåket læring utleder mål fra selve inputen, som å forutsi maskerte token eller matche transformerede visninger. Det er et grunnlag for moderne språk-, bilde- og multimodale modeller, inkludert transformere.
Forsterkningslæring
Forsterkningslæring optimaliserer beslutninger gjennom belønninger generert av interaksjon. Den skiller seg fra både merket forutsigelse og statisk mønstergjenkjenning.
Velge riktig tilnærming
Begynn med beslutningen eller innsikten systemet må levere. Hvis pålitelige mål finnes og forutsigelse er målet, er overvåket læring naturlig. Hvis målet er utforskning, representasjon eller gruppering, kan en uovervåket metode passe. Når etiketter er knappe, kan selv‑overvåket eller semi‑overvåket forhåndstrening etterfulgt av overvåket evaluering være mer effektiv.
I alle tilfeller kan datalekkasjer, skjev prøvetaking, svake proxy‑variabler og distribusjonsendringer dominere valg av algoritme. En teknisk korrekt modell trent på feil mål kan fortsatt mislykkes.
Læringssignaler, mål og representative metoder
Overvåket læring bruker eksempler paret med mål‑etiketter eller verdier og optimaliserer prediksjonsfeil. Klassifisering, regresjon, rangering og strukturert prediksjon varierer i output og tap. Uovervåket læring søker struktur uten mål‑etiketter gjennom klynging, tetthetsestimering, dimensjonsreduksjon, representasjonslæring eller generativ modellering. Selv‑overvåket læring lager forutsigelsesmål fra selve dataene, mens semi‑overvåket læring kombinerer et lite merket sett med større umerkede data. Disse kategoriene beskriver læringssignalet; samme nevrale arkitektur kan trenes under flere paradigmer.
Etiketter gjør et mål eksplisitt, men introduserer annotasjonskostnad, støy, policy‑antakelser og tidsforsinkelse. Umerkede data er lettere å samle inn, men forteller ikke en algoritme hvilken oppdaget struktur som er nyttig. En klynge kan reflektere belysning, dokumentlengde eller innhentingskilde i stedet for en meningsfull kategori. Definer evaluering uavhengig: overvåkede modeller bruker hold‑out merkede resultater, mens uovervåkede modeller trenger stabilitet, rekonstruksjon, sannsynlighet, gjenfinning, nytte i etterfølgende oppgaver eller ekspertvalidering. Visuell separasjon alene er ikke bevis på en gyldig struktur.
Velge et paradigme og forebygge vanlige feil
Bruk overvåket læring når et stabilt mål og representative etiketter finnes. Bruk uovervåket utforskning for å oppsummere, oppdage nyheter, komprimere eller generere hypoteser, men behandle resultater som foreløpige. Selv‑overvåket forhåndstrening er verdifull når rådata er rikelig og etterfølgende oppgaver deler representasjoner. Semi‑overvåkede metoder hjelper kun når antakelser om umerkede data og klassestruktur holder. Sammenlign med enkle basislinjer og ta hensyn til total kostnad for innsamling, merking, gjennomgang, beregning og feil i stedet for å anta at umerkede automatisk er billig.
Forebygg lekkasje ved å skille relaterte enheter før du utleder etiketter, augmentasjoner eller pseudo‑etiketter. Overvåk klassebalanse, annotasjons‑enighet, klynge‑stabilitet, kollaps og drift. Pseudo‑etiketter kan forsterke tidlige feil; klynging kan kode sensitive attributter; en forhåndstrent representasjon kan overføre kilde‑bias. Menneskelig gjennomgang bør fokusere på grensetilfeller og konsekvenser. I produksjon bør du dokumentere hvordan læringssignalet ble opprettet og når det blir foreldet. Paradigmet bestemmer hvor tilsyn kommer inn i systemet, ikke om menneskelige valg og verdier er tilstede.
Arbeidseksempel: oppdage og merke støttetemaer
Et selskap bruker først uovervåkede innebygginger og klynging for å utforske temaer i anonymiserte supportmeldinger. Analytikere inspiserer representative og grensende eksempler og oppdager at noen klynger reflekterer meldingslengde og kanal i stedet for problemer. De utvikler en overvåket taksonomi med en ukjent klasse, annotasjonsveiledning og målt enighet. En klassifikator evalueres deretter på senere tidsperioder, språk og produkter mot nøkkelord‑ og nærmeste‑nabos‑basislinjer.
Umerkede nye meldinger støtter oppdagelse av driftsendringer, men trener ikke klassifikatoren automatisk på nytt. Gjennomgangere merker utvalgte usikre og fremvoksende tilfeller via aktiv læring, med kvalitetskontroller og et lukket evalueringssett. Overvåkning sporer temafrekvens, tillit, uenighet og rutingsresultater. Når et nytt produkt lanseres, oppdateres taksonomien og kapasiteten til etterfølgende team samtidig. Arbeidsflyten bruker uovervåkede metoder for hypotese‑generering og overvåket bevis for operasjonell ruting.
Implementeringsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, input, output, avhengigheter, eier og konsekvensen av hver viktig feil. Etabler en reproduserbar basislinje og et versjonert evalueringssett før justering. Test vanlige tilfeller, grensetilstander, feilformatert eller manglende input, distribusjonsendring, avhengighets‑nedbrudd, misbruk, og grupper eller miljøer som mest sannsynlig er underbetjent. Mål oppgavens kvalitet sammen med kalibrering eller usikkerhet, latens, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig vurderer kan reprodusere resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåkning med bevisst injiserte feil. Operasjonell telemetri bør avdekke input‑kvalitet, output‑adferd, modell‑ eller regelversjon, avhengighets‑helse, menneskelige overstyringer og bekreftede resultater uten å samle unødvendige sensitive data. Definer varslings‑terskler og en ansvarlig for respons, og gjennomgå virkelige bevis etter utrulling i stedet for å anta at offline‑ytelse vedvarer. Revurder når datakilder, brukere, modeller, leverandører, policyer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelseslæring, sletting‑ og lagringsprosedyrer, samt et klart punkt hvor det skal deaktiveres eller erstattes.
Primære referanser












