
Grunnleggende AI
Hva er forsterkningslæring?

 Legg til Unite.AI blant dine foretrukne kilder på Google
Forsterkningslæring (RL) er et maskinlæringsrammeverk der en agent lærer hvordan den skal handle ved å samhandle med et miljø. Etter hver handling endres miljøet og kan returnere en belønning. Agentens mål er å lære en policy som maksimerer forventet kumulativ belønning, ikke bare belønningen fra neste trekk.
RL brukes når beslutninger utvikler seg over tid og en handling påvirker hva som skjer videre. Det er konseptuelt forskjellig fra overvåket læring, hvor et datasett gir et mål‑svar for hvert treningseksempel.
Nøkkelpunkter
- Et RL‑problem inneholder en agent, et miljø, tilstander, handlinger, belønninger og en policy.
- Positiv og negativ forsterkning øker begge atferd; straff reduserer atferd.
- Agenten må balansere utforskning av ukjente handlinger med utnyttelse av handlinger som allerede er kjent å fungere.
- Verdibasert, policy‑basert, actor‑critic, modellbasert og offline‑metoder løser ulike RL‑innstillinger.
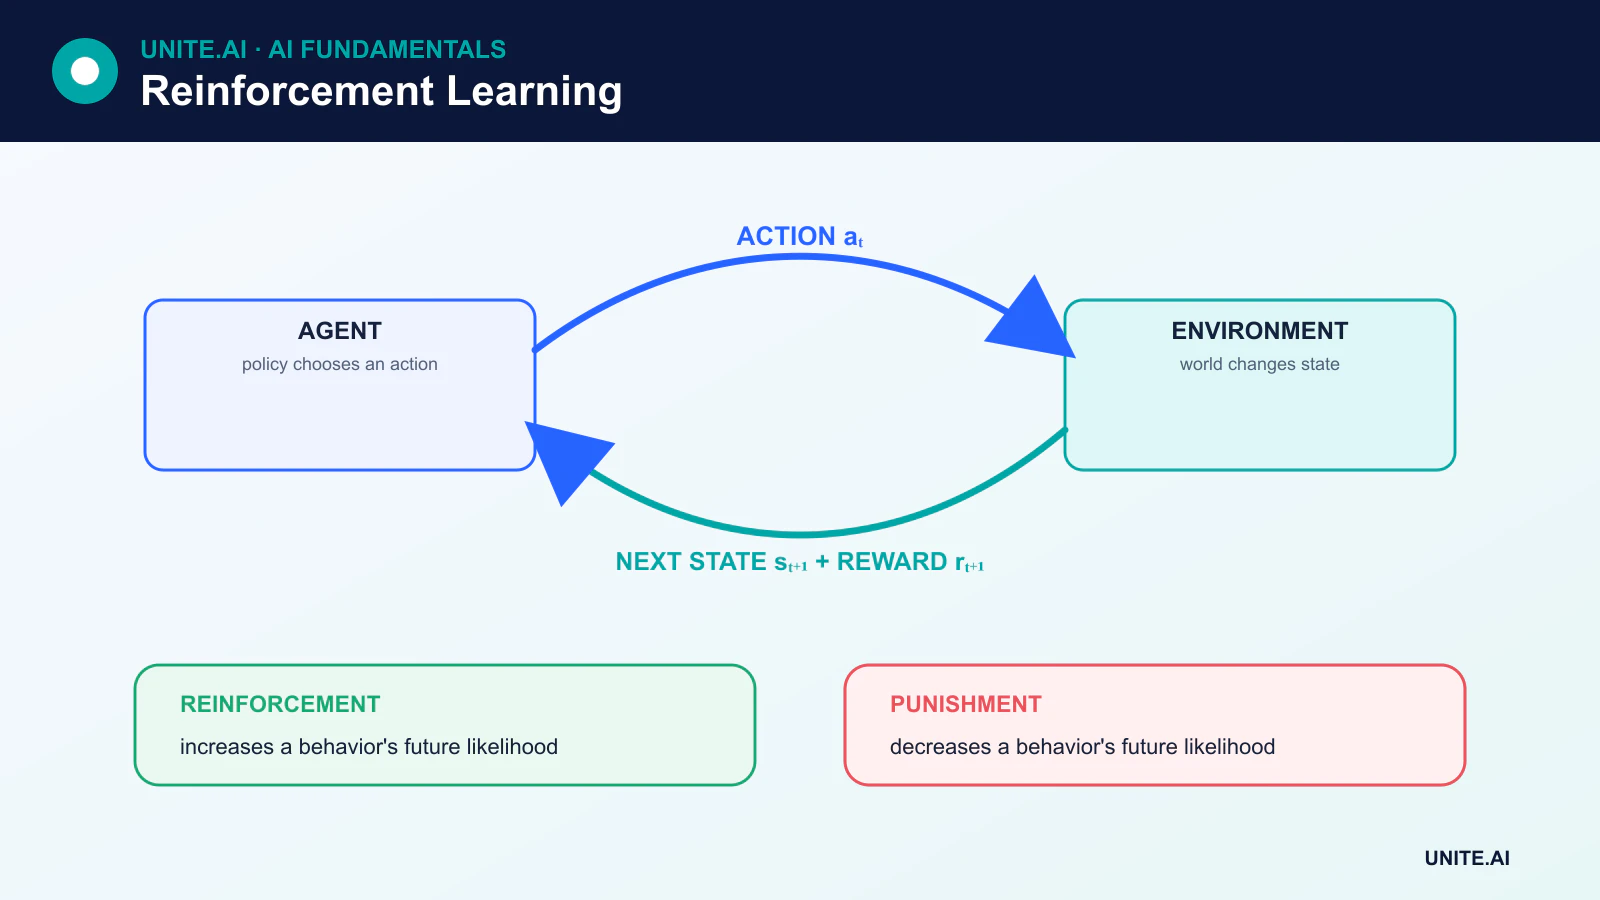
Komponentene i forsterkningslæring
Mange RL‑problemer modelleres som en Markov beslutningsprosess (MDP). En MDP inkluderer:
- Tilstand: informasjon som beskriver den nåværende situasjonen.
- Handling: et valg tilgjengelig for agenten.
- Overgang: hvordan tilstanden endres etter en handling.
- Belønning: umiddelbar tilbakemelding generert av en overgang.
- Policy: agentens strategi for å velge handlinger.
- Diskonteringsfaktor: hvor sterkt fremtidige belønninger teller i forhold til umiddelbare belønninger.
En tilstand trenger ikke å avsløre alt om verden. Når viktig informasjon er skjult, kan problemet være delvis observerbart, og agenten kan trenge en hukommelse eller en tro‑tilstand.
Forsterkning er ikke det samme som straff
Terminologien kommer fra atferdspsykologi. Positiv forsterkning legger til en konsekvens som gjør at en atferd blir mer sannsynlig. Negativ forsterkning fjerner en ubehagelig tilstand og gjør også at en atferd blir mer sannsynlig. En straff som er ment å gjøre en handling mindre sannsynlig, er straff, ikke negativ forsterkning.
Innen maskinlæring snakker praktikere oftere direkte om positive belønninger, negative belønninger, kostnader og straffer. Det sentrale spørsmålet er hvordan disse signalene former avkastningen agenten prøver å maksimere.
Avkastning, verdi og kreditt‑tildeling
En belønning beskriver én overgang. Avkastningen kombinerer belønninger over tid, vanligvis med diskontering av belønninger som kommer lenger frem i fremtiden. En tilstands‑verdifunksjon estimerer forventet avkastning fra en tilstand, mens en handlings‑verdifunksjon estimerer forventet avkastning etter å ha tatt en bestemt handling i den tilstanden.
Dette skaper kreditt‑tildelings‑problemet: hvis et nyttig resultat kommer mye senere, hvilke tidligere handlinger fortjener kreditt? RL‑algoritmer varierer i hvordan de estimerer dette forholdet.
Monte Carlo‑ og tidsdifferanse‑læring
Monte Carlo‑metoder lærer fra komplette innsamlede avkastninger, vanligvis etter at en episode er avsluttet. Tidsdifferanse‑metoder (TD) oppdaterer en estimering før det endelige resultatet ved å kombinere den observerte belønningen med en estimering av hva som kommer neste. TD‑læring bootstrapper derfor fra sine nåværende verdi‑estimater.
Ingen av familiene er universelt bedre. Monte Carlo‑mål er upartiske under den innsamlede policyen, men kan ha høy varians og kreve fullføring av episode. TD‑metoder kan lære online og fra pågående oppgaver, men deres bootstrap‑mål introduserer bias.
Utforskning versus utnyttelse
Utforskning samler informasjon ved å prøve handlinger hvis verdi er usikker. Utnyttelse velger handlingen som for øyeblikket antas å gi best avkastning. En agent som aldri utforsker kan ende opp med en dårlig strategi; en agent som aldri utnytter, får ikke nytte av det den har lært.
Enkle strategier inkluderer epsilon‑greedy‑handlingsvalg, tillitsbasert utforskning, entropi‑bonuser og metoder med indre belønning. I sikkerhetskritiske settinger kan ubegrenset utforskning være uakseptabel, så simulering, begrensninger, offline‑data eller menneskelig tilsyn blir viktig.
Hovedtilnærminger innen forsterkningslæring
Verdibaserte metoder
Q‑learning og beslektede algoritmer lærer handlingsverdier og avleder en policy ved å velge handlinger med høy verdi. Dyp forsterkningslæring bruker nevrale nettverk til å tilnærme verdifunksjoner eller policyer når tilstandsrom er for store for en tabell.
Policy‑gradient‑metoder
Policy‑gradient‑metoder justerer direkte en parametrisk policy for å forbedre forventet avkastning. De er nyttige for kontinuerlige handlinger og stokastiske policyer, men kan ha høy‑varians gradient‑estimater.
Actor‑critic‑metoder
En actor velger handlinger mens en critic estimerer verdi og gir et læringssignal. Dette kombinerer direkte policy‑optimalisering med verdi‑estimering.
Modellbasert og modellfri RL
Modellbaserte systemer lærer eller bruker en modell av overganger og belønninger slik at de kan planlegge. Modellfrie systemer lærer verdier eller policyer uten å eksplisitt modellere miljøet. Modellbaserte metoder kan bruke erfaring effektivt, men feil i den lærte modellen kan villede planleggingen.
Offline‑forsterkningslæring
Offline‑RL lærer fra et fast datasett i stedet for å samle nye interaksjoner under trening. Det kan redusere kostnadene eller risikoen ved utforskning, men agenten må unngå å overvurdere handlinger som er dårlig representert i dataene.
RLHF og menneskelige preferanser
Forsterkningslæring fra menneskelig tilbakemelding (RLHF) bruker preferansedata til å trene et belønningssignal eller direkte optimalisere en policy. Det har blitt brukt til å tilpasse språkmodell‑atferd med menneskelige vurderinger. Preferanseoptimalisering er ingen garanti for sannhet eller sikkerhet: resultatene avhenger av hvem som leverte tilbakemeldingen, hva de ble bedt om å vurdere, og hvordan målet ble designet.
Begrensninger
RL kan kreve enorme mengder interaksjoner, oppføre seg ustabilt under trening, og utnytte utilsiktede snarveier i en belønningsfunksjon. Evaluering er vanskelig fordi resultater kan variere med tilfeldige frø og miljødetaljer. God praksis inkluderer flere kjørsler, transparente baselines, begrensede mål, testing utenfor distribusjon, og overvåking for belønnings‑hacking.
Utforming av et RL‑problem: tilstand, handling, belønning og horisont
Forsterkningslæring modellerer sekvensielle beslutninger. Miljøet produserer en observasjon, agenten velger en handling under en policy, og en overgang gir en belønning og neste observasjon. En Markov beslutningsprosess antar at tilstanden inneholder informasjon som trengs for å forutsi fremtidige overganger og belønninger; delvis observerbarhet krever hukommelse, tro‑tilstand eller rekursive representasjoner. Diskontering styrer vekten av forsinkede utfall, mens episodiske og pågående oppgaver krever ulike avkastningsdefinisjoner. Dårlig design av tilstand eller handling kan gjøre et løsbart mål uinnlærbart.
Belønningsdesign spesifiserer atferd indirekte og er en stor kilde til feil. En proxy kan utnyttes: en agent belønnet for hastighet kan ignorere sikkerhet, mens en agent som kun belønnes ved oppgavefullføring kan få for lite læringssignal. Legg til begrensninger og avslutningsregler basert på reelle krav, test belønningssensitivitet, og inspiser trajektorier for utilsiktede strategier. Utforskningsmetoder balanserer innsamling av informasjon med utnyttelse av nåværende kunnskap. Off‑policy‑data kan forbedre prøve‑effektiviteten, men mismatch mellom atferd‑ og mål‑policy krever algoritmer designet for dette.
Evaluering, simulering og sikker utrulling
Verdibaserte metoder estimerer forventet avkastning for tilstander eller handlinger; policy‑gradient‑metoder optimaliserer en parametrisk policy; actor‑critic‑metoder lærer begge. Modellbasert RL lærer eller bruker overgangsdynamikk for å planlegge. Den passende familien avhenger av handlingstype, data, simulators nøyaktighet, horisont og stabilitetskrav. Sammenlign med heuristiske, overvåkede og kontroll‑teori baselines. Evaluer gjennomsnittlig og verst‑case avkastning, brudd på begrensninger, prøve‑effektivitet, robusthet mot miljøendringer, og varians på tvers av frø i stedet for å velge en kjøring med den beste læringskurven.
Online‑utforskning kan være uakseptabelt innen helsevesen, finans, robotikk og infrastruktur. Tren i simulering eller på loggede data der det er mulig, kvantifiser gapet mellom simulator og virkelighet, og bruk off‑policy‑evaluering nøye fordi usette handlinger mangler støtte. Utrulling bør begrense handlinger, frekvens, ressurser og driftsområde; inkludere menneskelig godkjenning for konsekvensfulle valg; og tilby en sikker kontroller eller nedstengning. Overvåk belønning sammen med faktiske resultater fordi en agent kan forbedre sin poengsum mens den skader det tiltenkte målet. Revalider etter endringer i miljø, policy eller belønning.
Arbeidseksempel: energistyring med forsterkningslæring
En bygningoperatør modellerer temperatur, belegg, vær, utstyrsstatus og strømpris, med handlinger begrenset til sikre setpunktjusteringer. Belønningen kombinerer komfort, energi, etterspørselsgebyrer og utstyrsbegrensninger, men faktiske komfortbrudd evalueres separat slik at belønningsoptimalisering ikke kan skjule skade. Historisk kontroll og modell‑prediktiv kontroll gir baselines. Trening bruker en kalibrert simulator med randomisert vær, sensorsstøy og utstyrs‑effektivitet.
Før påvirkning av bygningen kjører policyen mot levende observasjoner uten å handle. Ingeniører inspiserer trajektorier, begrensningsmarginer og atferd under helligdager, hetebølger, strømbrudd og manglende sensorer. Utrulling begrenser handlingsfrekvens og -område og beholder den eksisterende sikkerhetskontrolleren. Et menneske kan overstyre når som helst. Overvåking sammenligner energi og komfort med matchende perioder, registrerer intervensjoner, og ruller tilbake dersom brudd, uventet sykling eller modell‑mismatch overskrider definerte terskler.
Implementeringsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, innganger, utganger, avhengigheter, eier, og konsekvensen av hver viktig feil. Etabler en reproduserbar baseline og et versjonert evalueringssett før tuning. Test vanlige tilfeller, grensebetingelser, feilformatert eller manglende input, distribusjons‑skifte, avhengighets‑nedbrudd, misbruk, og gruppene eller miljøene som mest sannsynlig blir underbetjent. Mål oppgavens kvalitet sammen med kalibrering eller usikkerhet, latency, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig reviewer kan reprodusere resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåkning med bevisst injiserte feil. Operasjonell telemetri bør avdekke input‑kvalitet, output‑atferd, modell‑ eller regelversjon, avhengighets‑helse, menneskelige overstyringer, og bekreftede resultater uten å samle unødvendige sensitive data. Definer varslings‑terskler og en ansvarlig for respons, og gjennomgå virkelige bevis etter utrulling i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, policyer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelses‑læring, slettings‑ og oppbevarings‑prosedyrer, og et tydelig punkt hvor det skal deaktiveres eller erstattes.
Primære referanser












