
Grunnleggende AI
Hva er et generativt adversarial nettverk (GAN)?

 Legg til Unite.AI blant dine foretrukne kilder på Google
Et generativt adversarial nettverk (GAN) trener to nevrale nettverk i konkurranse. En generator konverterer tilfeldig eller betinget input til syntetiske prøver. En diskriminator prøver å skille genererte prøver fra ekte treningseksempler. Tilbakemeldingen fra hvert nettverk endrer det andre nettverkets læringsproblem.
GAN-er kan lage skarpe bilder og kontrollerbare syntetiske data, men adversarial trening er vanskelig å stabilisere. Visuell realisme er ikke bevis på mangfold, faktuell gyldighet eller tillatelse til å bruke treningsdataene.
Viktige punkter
- Generatoren produserer prøver; diskriminatoren lærer et beslutningssignal om ekte vs. generert.
- Trening søker en likevekt, men endrede motstandere kan forårsake ustabilitet, oscillasjon eller modekollaps.
- Betingede GAN-er kontrollerer generering med etiketter, tekst eller annen kontekst.
- Evaluering bør teste nøyaktighet, dekning, memorering og etterfølgende risiko – ikke kun bildekvalitet.
Det adversarielle spillet
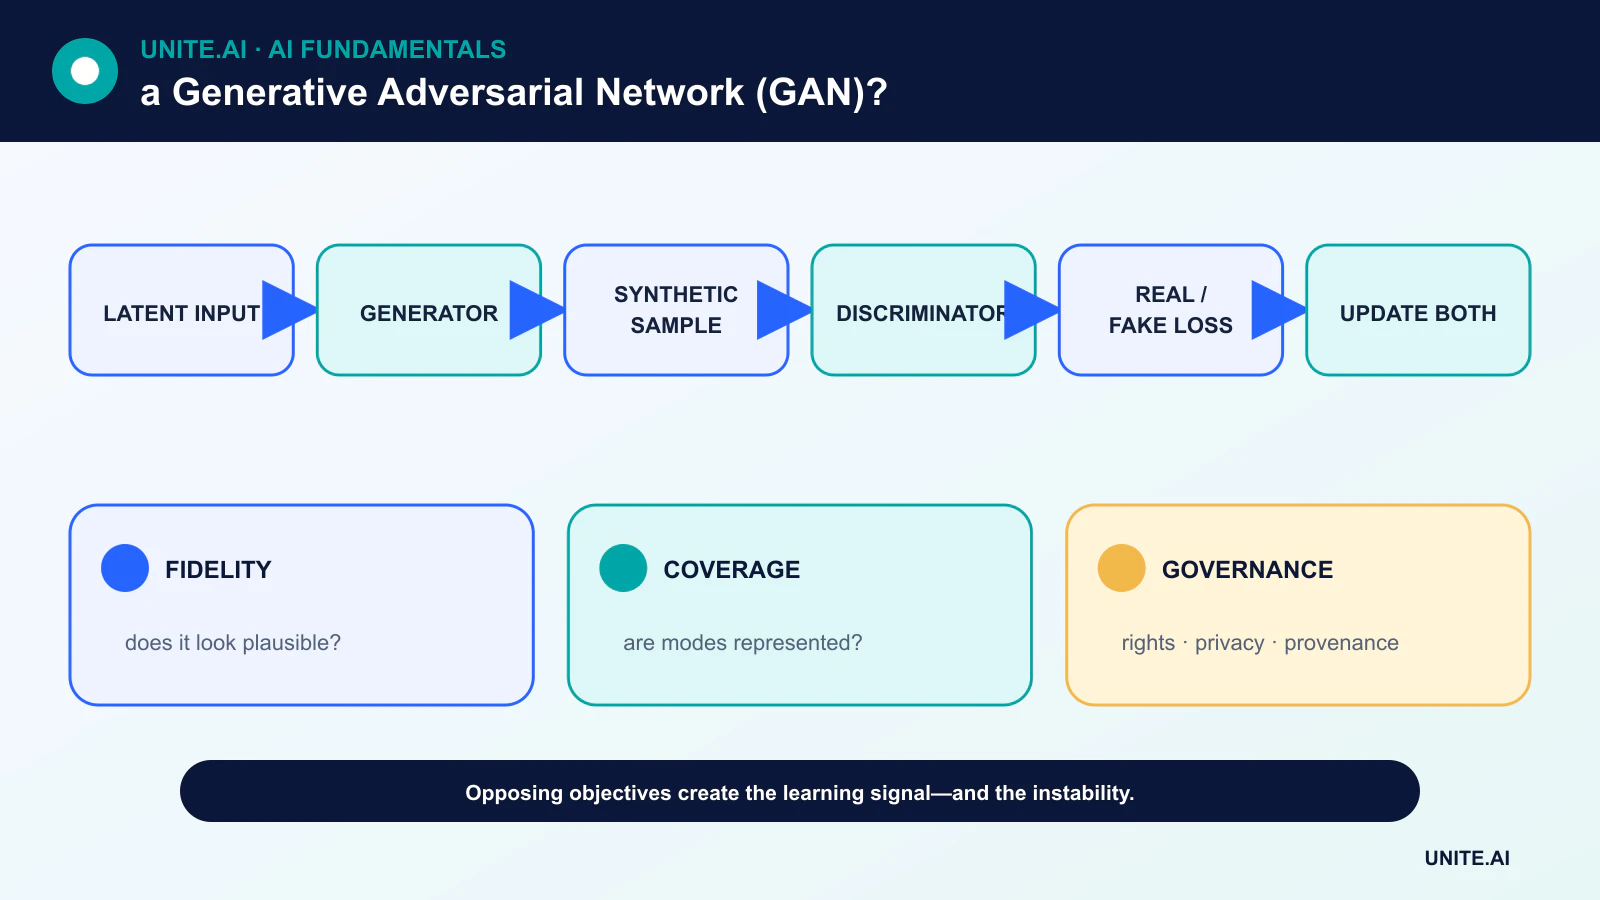
Den opprinnelige formuleringen er et to‑spiller minimax‑spill. Diskriminatoren blir bedre til å skille ekte data fra genererte data, mens generatoren blir bedre til å lage prøver som diskriminatoren klassifiserer som ekte. Begge trenes med tilbakepropagering.
Hvis diskriminatoren blir for nøyaktig, kan tilbakemeldingen til generatoren bli lite nyttig. Hvis den er for svak, kan generatoren utnytte enkle snarveier. Treningen veksler derfor oppdateringer og balanserer nøye kapasitet, tap og optimaliseringsinnstillinger.
Modekollaps og treningsstabilitet
Modekollaps oppstår når mange latente innganger gir lignende utganger, slik at prøvene virker plausible men kun dekker en del av datadistribusjonen. Andre feil inkluderer oscillasjon, eksploderende gradienter og sensitivitet for tilfeldig initialisering.
Wasserstein‑mål, gradientstraff, spektral normalisering, arkitekturendringer og justerte oppdateringsforhold kan forbedre stabiliteten. De fjerner ikke behovet for å inspisere mangfold og gjenta eksperimenter med flere frø.
Betinget generering og latent kontroll
En betinget GAN gir generatoren og diskriminatoren en etikett eller annen kontekst, slik at målrettede klasser eller attributter kan genereres. Stilbaserte arkitekturer separerer aspekter av latent kontroll på ulike oppløsninger og har produsert svært realistiske bilder.
Latente retninger kan korrelere med menneskelige konsepter, men redigering av én attributt kan endre andre fordi treningsdataene inneholder korrelerte trekk. Påstander om kontrollbarhet bør testes på tvers av ulike identiteter og kontekster.
Evaluering, personvern og proveniens
Målinger som Fréchet Inception Distance sammenligner funksjonsfordelinger, men de arver antakelser fra funksjonsmodellen og kan overse memorering eller feil i undergrupper. Nærmeste‑nabomanalyse, presisjon/rekall‑lignende dekningstester og menneskelig gjennomgang gir komplementær evidens.
En GAN kan memorere sjeldne eksempler, reprodusere skjevheter eller generere villedende media. Team bør dokumentere datasett, rettigheter, filtrering, vannmerke‑ eller proveniensmekanismer og misbrukskontroller. Syntetiske data er ikke automatisk anonyme.
GAN-er, VAE-er og diffusionsmodeller
Variasjonelle autoenkodere optimaliserer et sannsynlighetsbasert latent mål og bytter ofte skarphet i prøver mot et strukturert latent rom. Diffusjonsmodeller lærer å reversere en støyingsprosess og har blitt et vanlig grunnlag for bildeskaping.
GAN-er er fortsatt nyttige når rask én‑pass‑sampling, spesifikke bilde‑til‑bilde‑kartlegginger eller kompakt distribusjon er viktig. Den rette metoden avhenger av kvalitet, mangfold, latens, treningsstabilitet og styring – ikke av hvilken arkitektur som er nyest.
Adversarielle mål og treningsdynamikk
Et generativt adversarial nettverk trener en generator til å produsere prøver og en diskriminator til å skille genererte fra ekte data. I det opprinnelige minimax‑spillet estimerer diskriminatoren et signal relatert til tetthetsforhold, og generatoren prøver å lure den. Treningen veksler oppdateringer, slik at hvert nettverk lærer mot en bevegelig motstander i stedet for et fast tap. Hvis diskriminatoren blir for sterk, kan generatorgradientene bli lite nyttige; hvis den er for svak, stagnere kvaliteten på de genererte prøvene. Tapverdien alene korresponderer ikke direkte med prøvekvaliteten.
Modekollaps oppstår når generatoren produserer begrenset variasjon som lurer diskriminatoren. Oscillasjon, sensitivitet for hyperparametere og ustabil normalisering er også vanlig. Wasserstein‑mål, gradientstraff, spektral normalisering, funksjonsmatching, minibatch‑statistikk og nøye balanserte oppdateringsplaner adresserer ulike feilmekanismer. Betingede GAN-er bruker etiketter, tekst eller bilder for å styre utdata; stilbaserte arkitekturer separerer latente påvirkninger. Kvaliteten og dekningen av datasettet forblir grunnleggende fordi generatoren gjenskaper og rekombinerer distribusjonen den ser.
Evaluering og ansvarlig bruk
Evaluer nøyaktighet og mangfold separat. Fréchet Inception Distance sammenligner funksjonsfordelinger, men avhenger av prøvestørrelse, funksjonsmodell, forhåndsbehandling og domene; Inception Score utelater sammenligning med ekte data. Presisjon og recall for generative modeller, nærmeste‑nabomanalyse, memoreringstester og menneskelig oppgavevurdering gir ytterligere bevis. For vitenskapelig eller medisinsk syntese, bruk domenespesifikke målinger og etterfølgende validering. Hold et reservert ekte sett og sammenlign med diffusjons‑ eller autoregressive baselines ved likt beregningsbudsjett og oppløsning.
GAN-er kan forsterke data, oversette domener, super‑oppløse bilder, syntetisere media og støtte simulering, men syntetiske data kan forsterke skjevheter eller lekke treningseksempler. Verifiser lisensiering, samtykke, identitet og proveniens. Beskytt mot ikke‑samtykkende etterligning og villedende bruk, merk eller signer utdata der det er hensiktsmessig, og behold generasjonsmetadata. Et fotorealistisk bilde er ikke dokumentarisk bevis; usikkerhet og syntetisk opprinnelse må forbli synlige når resultatene påvirker beslutninger.
Distribusjon og reproduserbarhet
Registrer generator, diskriminator, optimizer, datasett, tilfeldig frø, truncation og sampling‑innstillinger. Kvantisering eller eksport kan endre normalisering og utdata, så valider server‑artefakten. Overvåk prompt‑ eller betingelsesfordeling, sikkerhetsfiltre, utdata‑mangfold, latens og rapporter. Bruk hastighetsbegrensninger og identitetssikringer i offentlige systemer. GAN‑trening er et koblet optimaliseringseksperiment: utvalgte demonstrasjonsbilder kan ikke fastslå robusthet, dekning eller fravær av memorering, og en modell bør evalueres på hele distribusjonen av tiltenkte generasjonsoppgaver.
Arbeidseksempel: syntetiske defektbilder med en GAN
En produsent trener en betinget GAN for å lage sjeldne overflatedefektbilder. Den verifiserer at treningsbildene har rettigheter og skiller produksjonslotter før trening og evaluering. Genererte prøver kontrolleres for nærmeste‑nabomemorering, defektsgeometri, bakgrunnsartefakter, mangfold og faglig plausibilitet. En klassifikator trent med syntetisk augmentering evalueres kun på uavhengige ekte defekter, i forhold til samme klassifikator med konvensjonell augmentering.
Syntetiske data aksepteres kun hvis reell tilbakekalling forbedres uten å øke falske avvisninger eller undergruppefeil. Generasjonsinnstillinger og proveniens forblir knyttet til hvert bilde, og syntetiske filer går aldri inn i testsettet eller bevisarkivet som ekte inspeksjoner. Operatører kan ikke bruke generatoren til å fabrikere revisjonsjournaler. Teamet sammenligner diffusjonsalternativer og kostnaden ved å samle flere ekte eksempler, og erkjenner at realistisk utseende ikke er bevis på at GAN-en har fanget den fysiske feilprosessen.
Implementeringsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, inn‑ og utdata, avhengigheter, eier og konsekvensen av hver viktig feil. Etabler en reproduserbar basislinje og et versjonert evalueringssett før justering. Test vanlige tilfeller, grensetilstander, feilformet eller manglende input, distribusjonsendring, avhengighetsbrudd, misbruk, og gruppene eller miljøene som mest sannsynlig blir underbetjent. Mål oppgavekvalitet sammen med kalibrering eller usikkerhet, latens, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig vurderer kan reprodusere resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåkning med bevisst injiserte feil. Operasjonell telemetri bør avdekke inndata‑kvalitet, utdata‑adferd, modell‑ eller regelversjon, avhengighetshelse, menneskelige overstyringer og bekreftede resultater uten å samle unødvendige sensitive data. Definer varslings‑terskler og en responsansvarlig, og gjennomgå virkelige bevis etter utrulling i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, retningslinjer, maskinvare eller mål endres, og et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelseslæring, sletting‑ og lagringsprosedyrer, og et klart tidspunkt for når det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Forstår en GAN bildene den lager?
En GAN lærer statistisk struktur som er nyttig for generering. Det etablerer ikke i seg selv en menneskelig lik semantisk eller kausal forståelse.
Er GAN-genererte prøver trygge å bruke som treningsdata?
Kun etter at dekning, etikett‑gyldighet, memorering, skjevhet og om den syntetiske distribusjonen hjelper på et reelt hold‑ut‑testsett er kontrollert.
Primære referanser












