
Grunnleggende AI
Hva er en autoenkoder?

 Legg til Unite.AI blant dine foretrukne kilder på Google
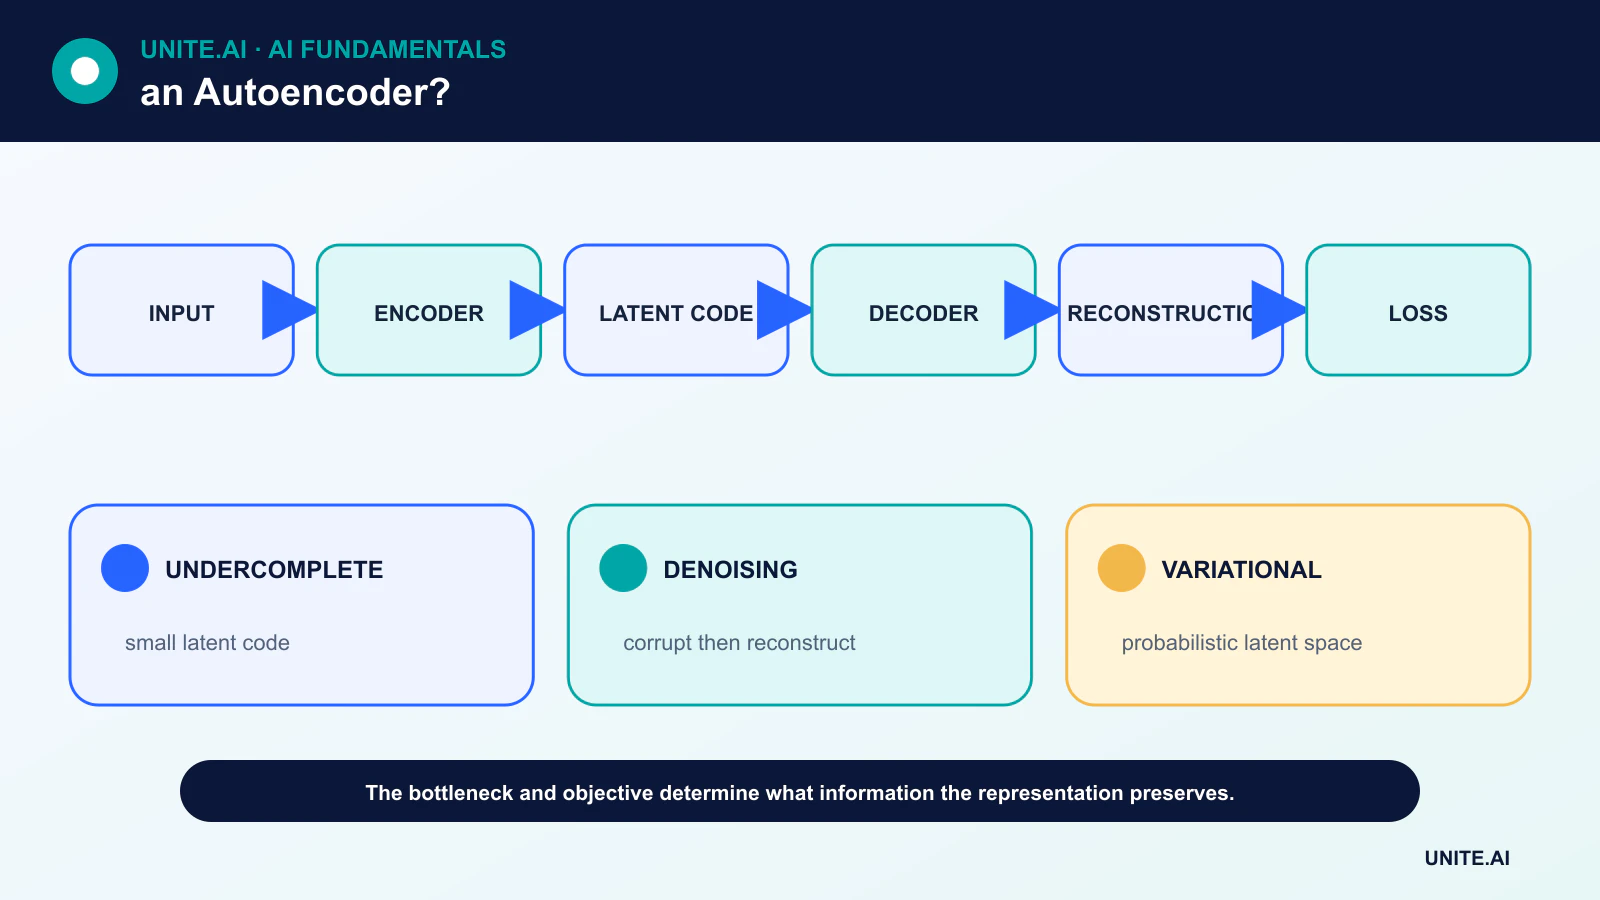
En autoenkoder er et nevralt nettverk trent til å rekonstruere sitt input. En enkoder kartlegger inputen til en latent representasjon; en dekoder kartlegger den representasjonen tilbake til en rekonstruksjon. Trening minimerer en rekonstruksjonstap, noen ganger med ekstra begrensninger.
Å kopiere inputen perfekt er ikke automatisk nyttig. Arkitekturen eller målet må skape en flaskehals, legge til støy, pålegge sparsitet eller på annen måte hindre en trivial identitetskartslegging slik at den latente koden fanger nyttig struktur.
Viktige punkter
- Enkoder komprimerer eller transformerer et input; dekoder rekonstruerer det fra en latent kode.
- En underkomplett flaskehals, støy eller regulering oppmuntrer modellen til å lære struktur i stedet for å kopiere.
- Rekonstruksjonsfeil kan støtte anomalideteksjon, men anomalier er ikke garantert å ha høy feil.
- Variasjonelle autoenkodere lærer en probabilistisk latent modell og skiller seg fra deterministiske autoenkodere.
Enkoder, latent rom og dekoder
For input x produserer enkoderen en latent kode z = f(x) og dekoderen produserer en rekonstruksjon x̂ = g(z). Tapet sammenligner x og x̂, for eksempel med gjennomsnittlig kvadratisk feil for kontinuerlige verdier eller en sannsynlighet som passer dataene.
Den latente dimensjonen kan være mindre enn inputen, noe som skaper en underkomplett autoenkoder. Et dypt nettverk kan også lære ikke‑lineære representasjoner, og utvider ideen bak dimensjonsreduksjon.
Vanlige varianter av autoenkodere
En sparsom autoenkoder straffer vidt spredt aktivering. En denoisende autoenkoder mottar et korrupt input og rekonstruerer den rene versjonen. En kontraktiv autoenkoder straffer følsomheten til koden for små endringer i input.
En variasjonell autoenkoder (VAE) koder parametere for en sannsynlighetsfordeling, trekker en latent verdi og balanserer rekonstruksjon med et reguleringsledd som former det latente rommet. Dette støtter sampling, men endrer målet og tolkningen.
Trening og unngåelse av trivielle løsninger
Autoenkodere bruker tilbakepropagering som andre nevrale nettverk. Et nettverk med for høy kapasitet kan memorere trenings‑eksempler eller lære en nesten‑identitetsfunksjon. Flaskehalsstørrelse, korrupting, straffer og validering på usett data begrenser det.
Valg av tap er viktig. Pixelvis tap kan gi uskarpe bilderekonstruksjoner, mens perseptuelle tap arver antakelser fra et annet nettverk. Den beste rekonstruksjonsmetrikken er ikke nødvendigvis det beste målet på semantisk likhet.
Bruksområder og begrensninger
Autoenkodere kan lære funksjoner, fjerne støy fra signaler, komprimere data, initialisere modeller og produsere latente variabler for visualisering. For anomalideteksjon kan en modell trent på normal data tildele høyere rekonstruksjonsfeil til uvanlige input.
Den tilnærmingen kan mislykkes når autoenkoderen også rekonstruerer anomalier godt, eller når harmløs variasjon er vanskeligere å rekonstruere enn mål‑anomalien. Terskler krever merkede eller nøye gjennomgåtte valideringsdata, og feil bør overvåkes per undergruppe og driftsforhold.
Autoenkodere versus andre generative modeller
En deterministisk autoenkoder er ikke automatisk en probabilistisk generativ modell. VAE-er definerer en strukturert latent fordeling; GAN-er trener en generator mot en diskriminator; diffusionsmodeller lærer en denoisingsprosess.
Valget avhenger av om målet er rekonstruksjon, representasjon, sannsynlighet, prøvekvalitet, kontrollerbarhet eller anomaliskårering. En mindre oppgavespesifikk modell er ofte mer praktisk enn en stor bildegenerator.
Enkoder–dekoder mål og latente representasjoner
En autoenkoder lærer en enkoder som kartlegger input x til en latent kode z og en dekoder som rekonstruerer x fra z. Hvis kapasiteten er ubegrenset, kan den lære en identitetskartslegging med lite nyttig struktur. Flaskehalser, regulering, korrupting, sparsitet eller arkitektoniske begrensninger tvinger en representasjon som bevarer utvalgt informasjon. Rekonstruksjonstapet definerer hva som regnes som likt: gjennomsnittlig kvadratisk feil favoriserer gjennomsnittlig pikselnøyaktighet, mens perseptuelle eller modalitetsspesifikke tap vektlegger ulike trekk. En lav feil garanterer ikke semantisk mening.
Underkomplette autoenkodere begrenser den latente dimensjonen. Denoisende autoenkodere rekonstruerer rene data fra korrupt input. Sparsomme varianter straffer aktivering; kontraktive varianter straffer følsomhet. Variasjonelle autoenkodere lærer en probabilistisk latent fordeling ved å kombinere rekonstruksjon med et divergensterm, noe som muliggjør sampling men endrer målet. Konvolusjonelle, sekvens‑, graf‑ og transformer‑autoenkodere koder modalitetsstruktur. Velg latent størrelse og regulering gjennom nedstrøms validering, ikke kun attraktive todimensjonale plott.
Anomalideteksjon, komprimering og evaluering
For anomalideteksjon, tren på representativ normal data og score rekonstruksjonsfeil eller latent sannsynlighet, men anomalier kan noen ganger rekonstrueres godt og sjeldne normale tilfeller dårlig. Velg terskler på merkede eller gjennomgåtte valideringscases, rapporter gjenkalling på hendelsesnivå og falske alarmer, og test endringer i driftsstatus. Sammenlign med enkle statistiske og én‑klasse baselines. For komprimering, tell med hele kodeken—inkludert modellstørrelse, kvantisering, metadata og dekodingsberegning—og sammenlign kvalitet ved tilsvarende bithastighet med etablerte kodeker.
Representasjonskvalitet kan evalueres gjennom lineære sonder, klyngestabilitet, gjenfinning, rekonstruksjon og nedstrøms oppgaver, hver som svarer på et annet spørsmål. Unngå lekkasje når enkoderen læres og terskler velges. Undersøk hvilke trekk tapet ignorerer og om sensitive attributter fortsatt er kodet. En komprimert latent er ikke automatisk anonymisert; inversjon og attributtinferens kan gjenopprette privat informasjon. Genererte rekonstruksjoner kan også virke plausible mens de endrer kritiske detaljer.
Distribusjon og overvåking
Versjonér enkoder og dekoder sammen, valider numeriske endringer etter eksport, og bevar inputskalering. Overvåk rekonstruksjonsfordeling, latent drift, terskelvarsler og bekreftede resultater. I industriell overvåking, beting modellen på driftsmodus slik at normale overganger ikke behandles som feil. For medisinsk eller vitenskapelig rekonstruksjon, presenter aldri en generert detalj som målt bevis uten validering og proveniens. Autoenkodere er fleksible representasjonslærere, men begrensningene og tapet—ikke arkitekturnavnet—bestemmer hvilken informasjon som beholdes, forkastes eller fabrikkeres.
Arbeidseksempel: en autoenkoder for pumpeanomalier
En underkomplett autoenkoder lærer vibrasjonsvinduer fra verifisert sunn pumpeoperasjon på tvers av belastning og temperatur. Den sammenlignes med statistiske terskler og én‑klasse‑metoder, og dens rekonstruksjonsterskel velges på gjennomgåtte normale overganger og kjente feil. Evalueringen bruker hendelses‑gjenkalling, varslingens ledetid, falske alarmer per driftstime, og resultater per pumpe, ikke tilfeldige vinduer som plasserer tilstøtende prøver i trenings‑ og testsett.
Produktionsmodellen betinger på driftsstatus og eksponerer residualmønstre for ingeniører. En høy feil ber om inspeksjon; den diagnostiserer ikke delen eller stopper pumpen automatisk. Sensorfrakobling, klipping og ukjent belastning gir eksplisitte ugyldige tilstander. Overvåkning sporer rekonstruksjonsfordeling, varselbekreftelse og sensorhelse. Når vedlikehold eller maskinvare endrer basislinjen, forblir den gamle modellen tilgjengelig mens en kandidat trenes på gjennomgåtte data og spilles av mot historiske hendelser.
Implementeringsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, input, output, avhengigheter, eier, og konsekvensen av hver viktig feil. Etabler en reproducerbar basislinje og et versjonert evalueringssett før justering. Test vanlige tilfeller, grensetilstander, feilformatert eller manglende input, distribusjonsendring, avhengighetsnedbrudd, misbruk, og gruppene eller miljøene som mest sannsynlig blir underbetjent. Mål oppgavekvalitet sammen med kalibrering eller usikkerhet, latens, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig reviewer kan gjenskape resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, bevar en sikker tilbakefallsløsning, og verifiser overvåkning med bevisst injiserte feil. Operasjonell telemetri bør avdekke inputkvalitet, output‑adferd, modell‑ eller regelversjon, avhengighetshelse, menneskelige overstyringer og bekreftede resultater uten å samle unødvendige sensitive data. Definer varselterskler og en responsansvarlig, og gjennomgå virkelige bevis etter utrulling i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, retningslinjer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelseslæring, sletting‑ og lagringsprosedyrer, og et tydelig punkt hvor det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Er autoenkodere tapsfri komprimering?
Nei, ikke generelt. De lærer vanligvis oppgave‑ og distribusjonsspesifikke tapsfulle representasjoner og krever den trente dekoderen for å rekonstruere data.
Er hver flaskehals tolkbar?
Nei. En kompakt kode kan være nyttig uten at hver dimensjon tilsvarer et menneskelig lesbart konsept.
Primære referanser












