
Grunnleggende AI
Hva er K-means‑klustering?

 Legg til Unite.AI blant dine foretrukne kilder på Google
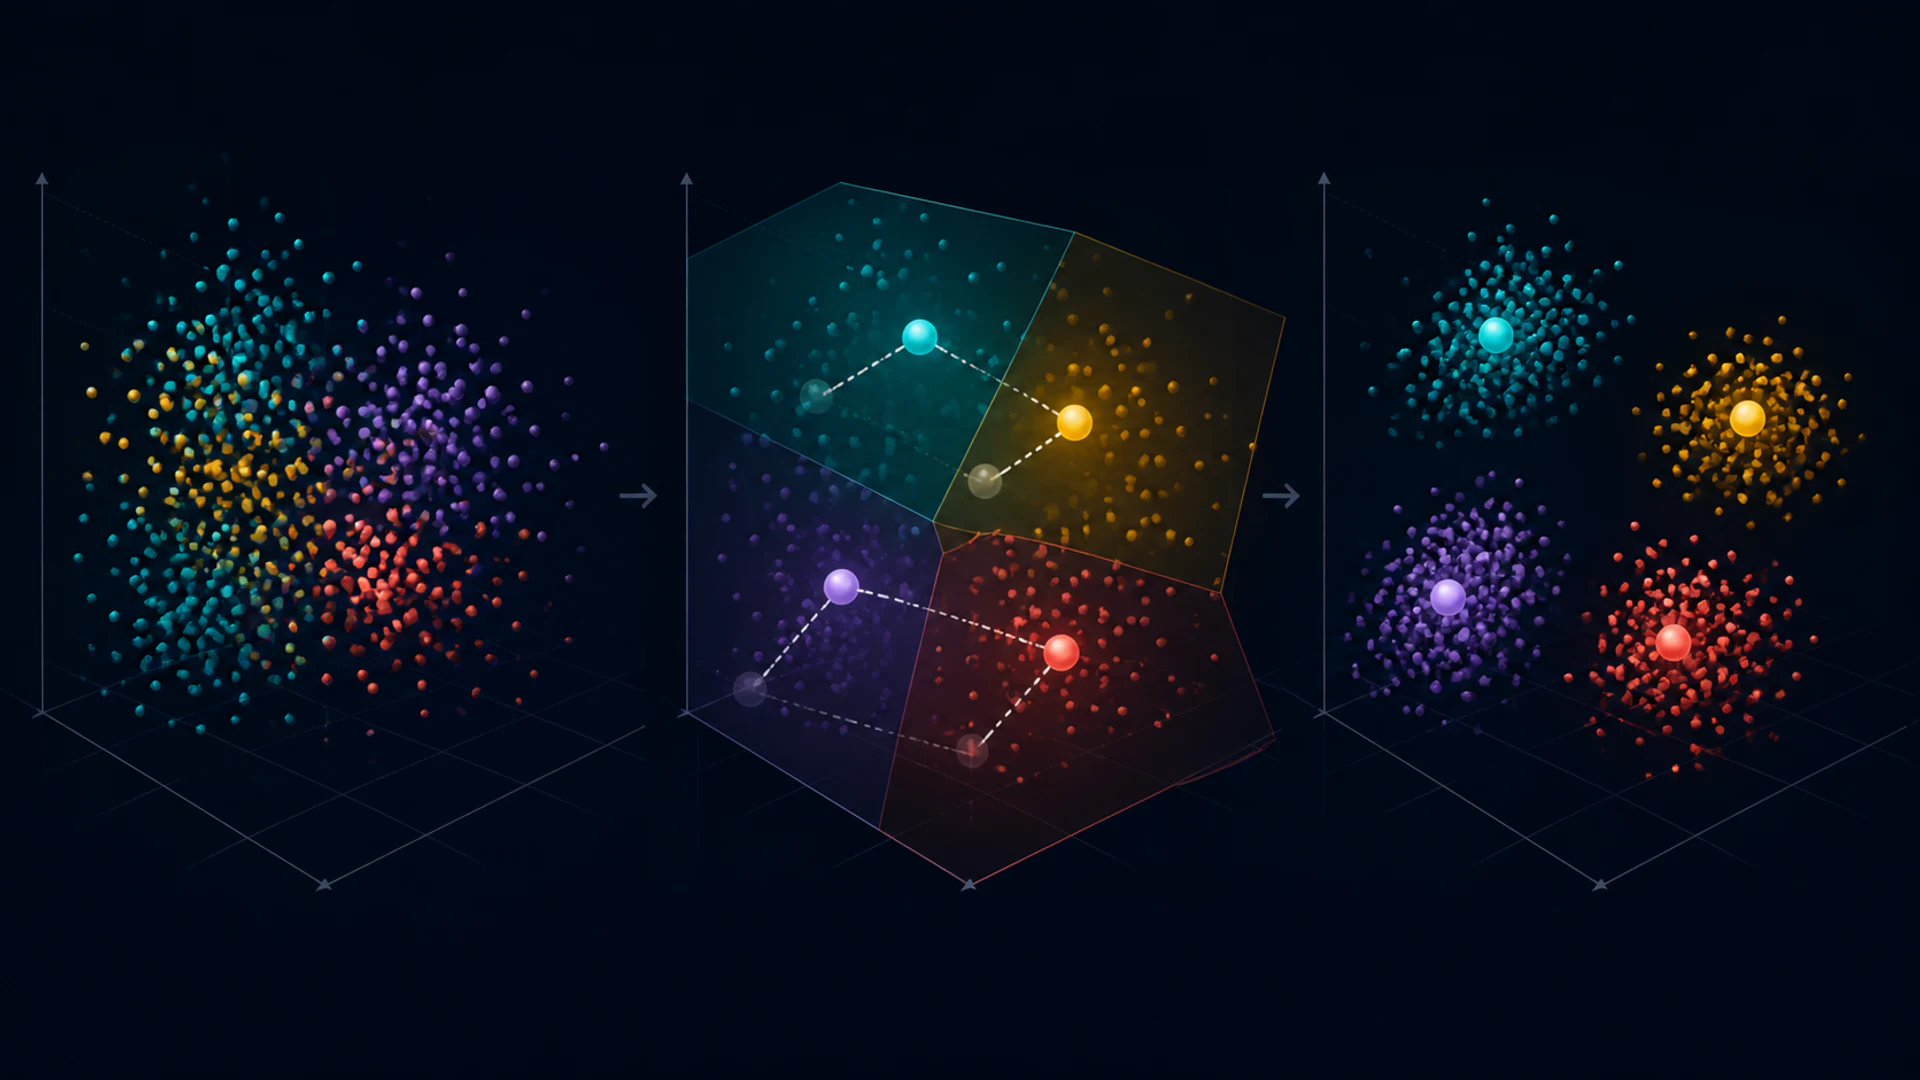
K-means er en ikke‑overvåket algoritme som deler numeriske observasjoner inn i k klynger. Den veksler mellom å tildele hvert punkt til sin nærmeste sentroid og å beregne hver sentroid på nytt som gjennomsnittet av sine tildelte punkter.
Algoritmen er rask og nyttig, men resultatet påvirkes av skalering, avstand, initialisering og det valgte k. En klynge er en matematisk partisjon, ikke automatisk en virkelig verdens kategori.
Viktige punkter
- K-means minimerer den kvadrerte euklidiske avstanden innenfor hver klynge til sentroidene.
- Initialisering er viktig; k-means++ sprer start‑sentroidene og forbedrer vanligvis resultatene.
- Standardiser funksjoner når deres enheter eller skalaer skal bidra på lik linje.
- K-means har problemer med avvikere, ikke‑sfæriske klynger, ulik tetthet og kategoriske data.
Målet og oppdateringsløkken
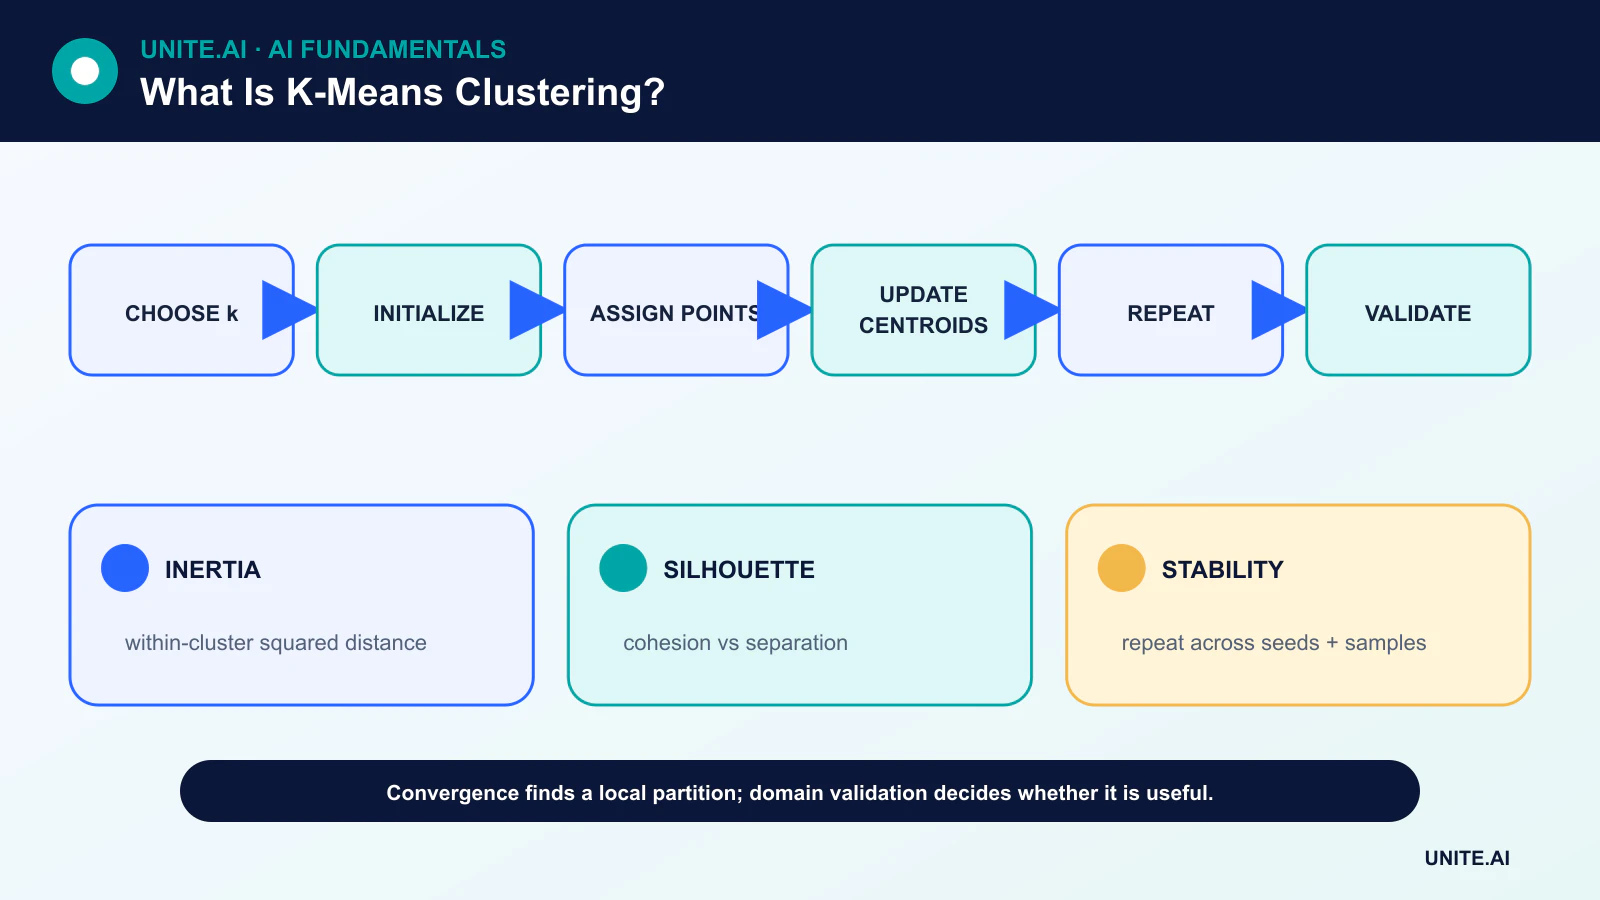
Gitt k sentroider sender tildelingssteget hver observasjon til den nærmeste. Oppdateringssteget erstatter hver sentroid med gjennomsnittet av sine tildelte observasjoner. Summen av kvadrerte avstander innen hver klynge kan ikke øke under disse stegene, så prosessen konvergerer til et lokalt optimum.
Konvergens garanterer ikke det globale optimum. Ulike start‑sentroider kan føre til ulike partisjoner, derfor kjører implementasjoner flere initialiseringer og beholder løsningen med lavest inerti.
Initialisering og k-means++
Å tilfeldig velge alle start‑sentroider fra én tett region kan gi en dårlig løsning eller langsom konvergens. K-means++ velger frø med sannsynlighet relatert til avstand fra eksisterende frø, noe som fremmer dekning av datasettet.
Flere kjøringer er fortsatt nyttige. Registrer den tilfeldige frøverdien og antall initialiseringer slik at resultatene kan reproduseres.
Skalering og avstand
Den kvadrerte euklidiske avstanden gjør K-means sensitivt for enheter. En funksjon målt i tusen kan dominere en annen målt mellom null og én. Standardisering er vanlig, men domenekunnskap bør avgjøre om lik standardisert varians reflekterer lik betydning.
Avvikere kan trekke et gjennomsnitt langt fra typiske punkter. Robust skalering, trimming eller metoder basert på medoid kan være bedre. One‑hot‑kategoriske funksjoner skaper en avstandsgeometri som kanskje ikke samsvarer med kategoris likhet.
Valg av k og validering av klynger
Inerti reduseres hver gang k øker, så den kan ikke velge k alene. Albue‑heuristikken ser etter avtagende forbedring. Silhouette‑analyse sammenligner sammenheng og separasjon. Stabilitet på tvers av prøver og frø gir en ekstra sjekk.
Den sterkeste valideringen er nytteverdien for det tiltenkte domenet. Sammenlign klynger med kjente resultater, ekspertvurdering eller en nedstrøms oppgave uten å late som om etterfølgende etiketter ble oppdaget objektivt.
Begrensninger og alternativer
K-means foretrekker kompakte, omtrent sfæriske grupper av lik skala. Gaussiske blandingsmodeller representerer sannsynlige ellipsoide komponenter; DBSCAN‑lignende metoder identifiserer tette regioner og støy; hierarkisk klynging produserer et tre av sammenslåinger.
Dimensionality reduction kan forbedre hastigheten eller redusere støy i inndata, men å tilpasse den på hele datasettet kan endre valideringsspørsmålet. Mini‑batch K-means reduserer beregning for store datasett på bekostning av en omtrentlig oppdatering.
Mål, initialisering og konvergens
K-means deler numeriske observasjoner inn i k klynger ved å minimere den kvadrerte euklidiske avstanden innen hver klynge til sentroidene. Lloyds algoritme veksler mellom å tildele hvert punkt til nærmeste sentroid og å beregne sentroidene på nytt til tildelinger eller mål stabiliseres. Den konvergerer til et lokalt optimum, men ikke nødvendigvis det globale beste. K-means++‑initialisering sprer de første sentrene og forbedrer vanligvis resultatene, men flere frø forblir viktige. Standardiser funksjoner når enheter skal bidra på lik linje fordi kvadrert avstand forsterker variabler med stor skala og avvikere.
Metoden forutsetter omtrent kompakte, sfæriske, likt skalerte klynger under euklidisk geometri. Den har problemer med langstrakte mangfold, ulik tetthet, kategoriske data, kraftige avvikere og nestet struktur. Tomme klynger og dupliserte punkter krever definert håndtering. Mini‑batch k-means skalerer til store data med en tilnærmingsavveining. For sparsom tekst kan kosinus‑orientert sfærisk k-means bedre matche retning, mens blandinger, tetthetsmetoder, hierarkisk klynging eller k‑medoid representerer andre antakelser.
Valg av k og validering av mening
Albuekurver, silhouette‑poeng, informasjonskriterier i relaterte modeller og stabilitet kan informere k, men ingen av dem avdekker et entydig korrekt tall. Forretningsnytte og domenetolkning er viktig. Tilpass på nytt på tvers av prøver og frø, sammenlign sentroidbevegelser og tildelingskonsistens, og valider klynger på uavhengige resultater som ikke ble brukt til å danne dem. En todimensjonal projeksjon kan forvrenge separasjon, så undersøk avstander og eksempler i det originale eller validerte representasjonsrommet.
Klynger er beskrivende grupper laget av de valgte funksjonene og metrikken; de er ikke naturlige typer eller kausale segmenter. Profiler basert på de samme variablene som brukes til klynging kan bli sirkulære. Bruk hold‑out‑attributter og kvalitativ gjennomgang, og undersøk om klyngene hovedsakelig gjenskaper geografi, datakilde eller sensitive trekk. Små klynger kan være anomalier eller artefakter. Å navngi en klynge gjør ikke at hvert medlem passer til etiketten.
Distribusjon og vedlikehold
Lagre skalering, funksjonsrekkefølge, sentroider, avstandsbegrep og klyngeetiketter sammen. For nye punkter, overvåk avstanden til tildelt sentroid og andelen som ligger langt utenfor treningsstøtte; tilby en ukjent tilstand i stedet for å tvinge hver sak inn i en klynge. Spor klyngestørrelser, sentroider og resultatrelevans over tid. Gjenopplæring endrer klyngeidentiteter, så kartlegg eller versjoner nedstrøms regler i stedet for stille å bruke gamle navn. K-means er et nyttig kompresjons‑ og segmenteringsgrunnlag når geometrien passer til spørsmålet, men ikke en universell oppdagelsesmotor.
Arbeidseksempel: kundesegmentering med k-means
Et abonnementsselskap standardiserer bruksfunksjoner over et fast tidsvindu, fjerner kontoidenter, og tester k på tvers av frø. Stabilitet, silhouette og hold‑out forretningsresultater gjennomgås, men produkteam inspiserer også representative og grensende kontoer. De oppdager at én klynge ganske enkelt er nye kunder med kortere observasjonsperiode, så ansettelsestid håndteres eksplisitt. K-means sammenlignes med hierarkiske og tetthetsbaserte alternativer i stedet for å bli antatt passende. Øvelsen behandles som ikke‑overvåket læring, ikke etikettoppdagelse.
Segmenter styrer forsknings‑ og meldings‑eksperimenter, ikke berettigelse eller pris. Nye kontoer langt fra hver sentroid får en ukjent tildeling. Skalering, funksjoner, sentroider og navn versjoneres, og gjenopplæring kartlegger nye klynger til gamle kun med bevis. Overvåking sporer klyngestørrelse, avstand og resultatrelevans. Sensitive attributter og proxyer revideres, og teamet unngår å beskrive klynger som naturlige personlighetstyper når de er matematiske partisjoner av valgt atferd.
Implementasjonsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, inn‑ og utdata, avhengigheter, eier og konsekvensen av hver viktig feil. Etabler en reproduserbar basislinje og et versjonert evalueringssett før finjustering. Test vanlige tilfeller, grensetilstander, feilformatert eller manglende input, distribusjonsendring, avhengighetsavbrudd, misbruk, og gruppene eller miljøene som mest sannsynlig blir underbetjent. Mål oppgavens kvalitet sammen med kalibrering eller usikkerhet, latenstid, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig reviewer kan reprodusere resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, bevar en sikker tilbakefallsplan, og verifiser overvåkning med bevisst injiserte feil. Operasjonell telemetri bør avdekke input‑kvalitet, output‑adferd, modell‑ eller regelversjon, avhengighetshelse, menneskelige overstyringer og bekreftede resultater uten å samle unødvendige sensitive data. Definer varslingsgrenser og en ansvarlig for respons, og gjennomgå virkelige bevis etter utrulling i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, retningslinjer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelseslæring, sletting‑ og lagringsrutiner, og et tydelig punkt hvor det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Er K-means overvåket eller ikke‑overvåket?
Den er ikke‑overvåket fordi den mottar funksjoner og et valgt antall klynger, ikke mål‑etiketter.
Klassifiserer K-means nye data?
Etter tilpasning kan et nytt punkt tildeles sin nærmeste sentroid. Det er en klyngetildeling, ikke nødvendigvis en overvåket klassifiseringsprediksjon.
Primære referanser












