Grunnleggende AI
Hva er datavitenskap?

 Legg til Unite.AI blant dine foretrukne kilder på Google
Data science er praksisen med å omdanne data til forsvarlig kunnskap, prediksjoner eller beslutninger. Den kombinerer domenekompetanse, statistikk, databehandling, data‑engineering, visualisering og kommunikasjon. En modell kan være en del av arbeidet, men disiplinen starter før modellering og fortsetter etter utrulling.
Det viktigste spørsmålet er ikke «Hvilken algoritme skal vi bruke?» Det er «Hvilken beslutning støtter vi, hvilket bevis vil svare på den, og hvordan vet vi at resultatet fortsatt er nyttig?»
Viktige punkter
- Datavitenskap er en ende‑til‑ende bevis‑arbeidsflyt, ikke et synonym for maskinlæring.
- Problemdefinisjon, måling og datastyring avgjør ofte suksess mer enn modellkompleksitet.
- Prediktive og kausale spørsmål krever ulike antakelser og evalueringsdesign.
- En utrullet analyse trenger overvåking, dokumentasjon og kommunikasjon som er tilpasset brukerne.
Start med en beslutning og et estimand
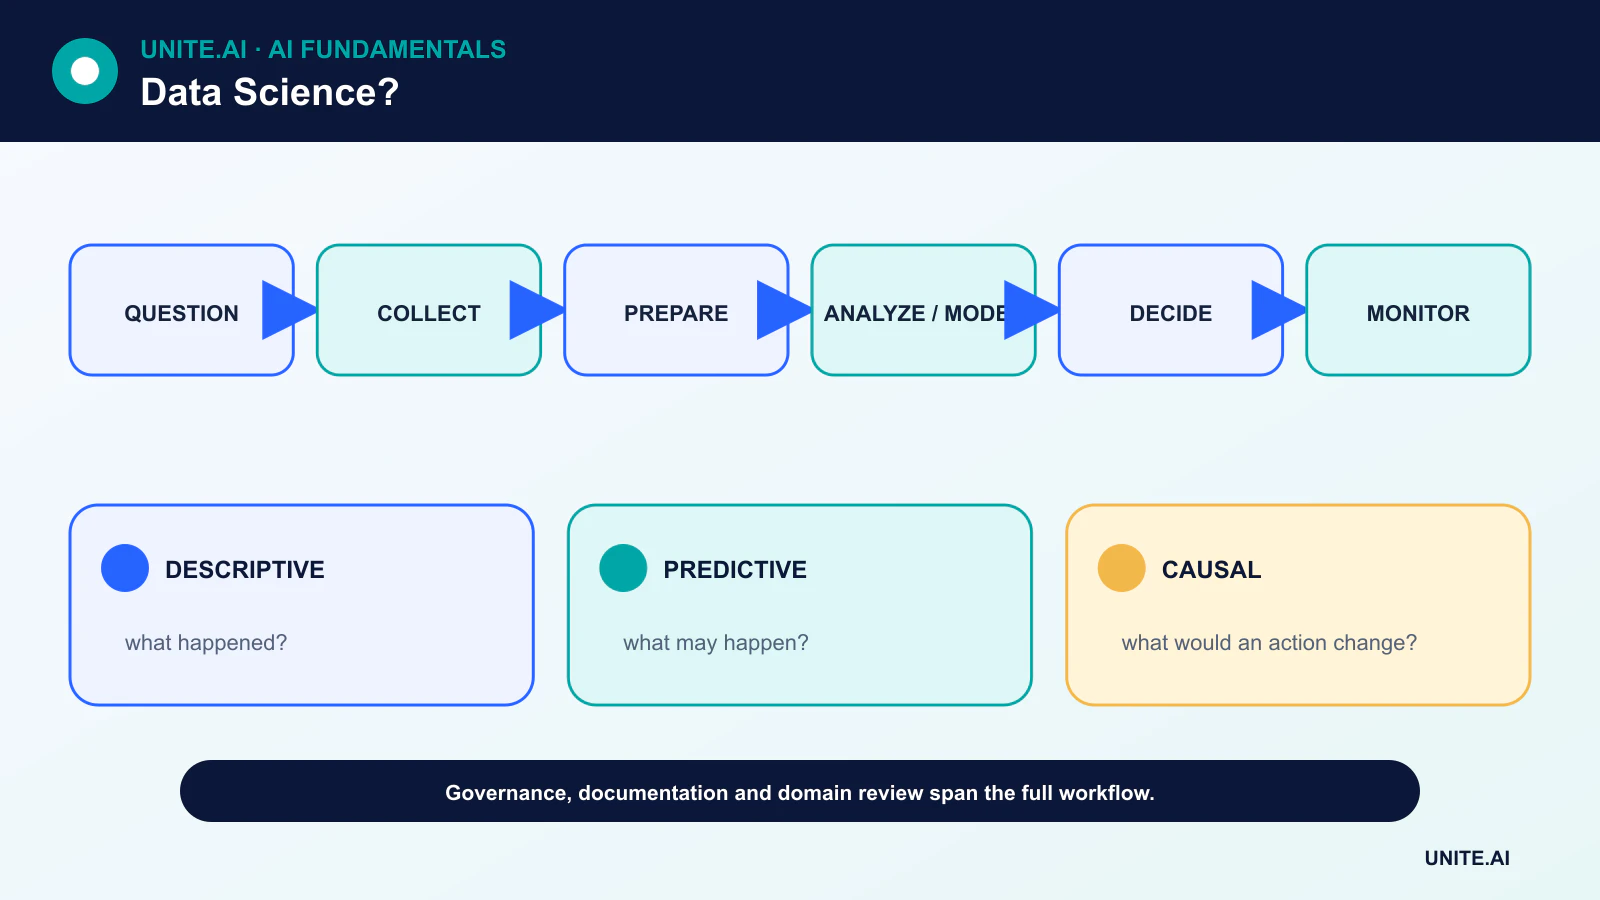
Et prosjekt bør identifisere brukeren, beslutningen, intervensjonen og kostnaden ved feil. For et beskrivende spørsmål kan målet være en rate eller trend. For prediksjon kan det være fremtidig etterspørsel eller risiko. For et kausalt spørsmål beskriver estimandet effekten av en definert intervensjon under gitte antakelser.
Uklare mål som «finn innsikter» gjør evaluering umulig. Et mål som kan måles skaper en avgrensning for datainnsamling og hindrer analysen i å spre seg til alle tilgjengelige felt.
Samle, styre og forstå data
Teamene lager oversikt over kilder, eierskap, samtykke, lagring, opphav og tilgang. De skiller mellom strukturert og ustrukturert data, definerer enheter og tidsstempler, og undersøker om postene representerer den aktuelle populasjonen og tidsperioden.
Rensing er ikke bare å slette manglende rader. Det inkluderer å løse duplikater, umulige verdier, etikett‑uklarhet, skjema‑drift, sensurering og sammenføyninger som endrer analyseenheten. Hver transformasjon bør være reproduserbar og dokumentert.
Utforsk før modellering
Utforskende analyse studerer fordelinger, mangler, relasjoner og potensielle måleartefakter. Visualisering kan avdekke avvikere og undergruppeforskjeller som et sammendragsgjennomsnitt skjuler. Utforskning bør informere hypoteser uten å bli forvekslet med bekreftende bevis.
Egenskaps‑engineering, dimensjonsreduksjon og representasjons‑læring kan forbedre modellering, men transformasjoner må kun tilpasses treningsdata for å forhindre lekkasje.
Velg metoder for spørsmålet
Statistisk estimering kvantifiserer usikkerhet rundt interesse‑mengder. Maskinlæring er nyttig når hovedmålet er prediktiv ytelse på nye data. Eksperimenter og kausal inferens‑metoder kreves når målet er en intervensjonseffekt.
Et grunnlag bør være enkelt nok til å forstå. Mer komplekse modeller må tjene sin ekstra kostnad gjennom bedre hold‑out‑ytelse, kalibrert usikkerhet, operasjonell verdi eller en nødvendig evne som bilde‑ eller språkbehandling.
Evaluer, kommuniser og overvåk
Evaluering bør tilpasses beslutningen. En klassifikator kan kreve presisjon, tilbakekalling, kalibrering og undergruppeanalyse i stedet for kun nøyaktighet; et prognosesystem trenger tids‑bevisst tilbakeprøving. Overtilpasning og lekkasje er prosess‑feil, ikke bare modell‑egenskaper.
Kommunikasjon inkluderer antakelser, usikkerhet, begrensninger og anbefalte handlinger. Når en modell eller dashbord er i bruk, overvåker teamene inndata‑kvalitet, resultat‑drift, brukeradferd og nedstrøms påvirkning. En pensjonert beslutningsprosess trenger et arkiv og tydelig eierskap, akkurat som en utrullet prosess trenger en operatør.
Datavitenskapens livssyklus og analytiske spørsmål
Datavitenskap kombinerer domenekunnskap, statistikk, databehandling og kommunikasjon for å omdanne data til bevis for beslutninger. Start med å skille mellom beskrivelse, diagnostikk, prediksjon og kausal inferens. Et dashbord som rapporterer hva som skjedde, en modell som forutsier hvem som vil slutte, og et eksperiment som estimerer om en intervensjon endrer frafall, svarer på ulike spørsmål. Definer enheten, populasjonen, tidsvinduet, resultatet, handlingen og kostnaden ved feil før du henter data. Mange mislykkede prosjekter løser en målbar proxy som ikke kan støtte den tiltenkte beslutningen.
Anskaffelse krever opphav, tillatelser, utvalgsdesign og en datakontrakt. Utforskning sjekker fordelinger, mangler, duplikater, avvikere, relasjoner, målingsendringer og potensiell lekkasje. Rensevalg er analytiske antakelser: sletting av manglende rader, imputering av verdier eller begrensning av avvikere kan endre populasjonen og konklusjonen. Versjonér rådata uforanderlig og transformasjoner som kode, og lag en datadictionary med enheter og betydning. Del evalueringsdata før du lærer transformasjoner eller gjentatte ganger tester hypoteser.
Modellering, inferens og reproduserbarhet
Statistisk inferens kvantifiserer usikkerhet under antakelser; prediktiv modellering estimerer ytelse utenfor prøven; kausal analyse krever identifikasjon gjennom design eller forsvarlige antakelser. Velg metoder som passer spørsmålet og den data‑genererende prosessen. Sammenlign med enkle grunnlinjer, bruk gruppert eller tids‑bevisst validering, og rapporter usikkerhet og sensitivitet. Høy korrelasjon eller funksjons‑viktighet etablerer ikke kausalitet. Multipel testing, forskerens frihetsgrader og selektiv rapportering kan konstruere overbevisende mønstre, så forhåndsregistrering eller et tydelig adskilt bekreftende stadium kan hjelpe.
Reproduserbarhet inkluderer kode, miljø, datasnapshot, tilfeldige frø, spørringsdefinisjoner og en oversikt over manuelle beslutninger. Automatiserte tester bør dekke skjemaer, forretnings‑invarianter, transformasjoner og måleparametre. Notatbøker er verdifulle for utforskning, men produksjonsarbeid krever modulære, gjennomgåelige pipelines. Fagfellevurdering bør utfordre antakelser, lekkasje, mål‑validitet og om resultatene generaliserer. Kommuniser effektstørrelser, usikkerhet, begrensninger og motbevis i stedet for kun statistisk signifikans eller en modell‑score.
Utrulling og beslutningspåvirkning
Hvis analysen driver en tilbakevendende prosess, tildel eiere, overvåk datafriskhet og resultatkvalitet, og definer tilbakeføring eller pensjonering. Beskytt personlig og konfidensiell informasjon gjennom minimalisering, tilgangskontroll, lagring og sikre utskrifter. Evaluer undergruppe‑effekter og hvordan brukere reagerer på modellen; tilbakemeldingssløyfer kan endre fremtidige data. Mål om beslutningen forbedret det reelle målet, ikke bare om en modell ble utrullet. Datavitenskap er vellykket når bevis endrer handling pålitelig og gjennomsiktig – ikke når en organisasjon samler dashbord, funksjoner eller eksperimenter uten eierskap.
Arbeidseksempel: måling av en retensjonsintervensjon
Et produktteam observerer lavere retensjon og definerer en aktiv bruker, kohort, tidsvindu, eksklusjoner og beslutning. Analytikere reviderer instrumentering, manglende hendelser og anskaffelses‑blanding før modellering. Beskrivende kohorter identifiserer hvor nedgangen skjer, en prediktiv modell prioriterer forskningsdeltakere, og et randomisert onboarding‑eksperiment estimerer om den foreslåtte endringen forbedrer retensjon. Dette er tre separate analyser med ulike antakelser og resultater.
Notatboken, spørringene, datasnapshotet, metrikkdefinisjonen og eksperimentplanen er versjonert og fagfellevurdert. Resultatene rapporterer effektstørrelse og usikkerhet med sikkerhetsrammer for støttebehov og tilgjengelighet. Et dashbord overvåker eksperimentet, men erstatter ikke den forhåndsdefinerte analysen. Hvis intervensjonen lykkes, forblir utrullingen trinnvis og sjekker langsiktig adferd. Arbeidet anses som verdifullt kun hvis det støtter en reproduserbar beslutning, ikke fordi en kompleks modell eller visuelt imponerende diagram ble laget.
Implementeringsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, inndata, utdata, avhengigheter, eier og konsekvensen av hver viktig feil. Etabler en reproduserbar grunnlinje og et versjonert evalueringssett før justering. Test vanlige tilfeller, grensetilstander, feilformet eller manglende inndata, distribusjons‑skift, avhengighets‑nedbrudd, misbruk, og gruppene eller miljøene som sannsynligvis er underbetjent. Mål oppgavekvalitet sammen med kalibrering eller usikkerhet, latens, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig vurderer kan reprodusere resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåking med bevisst injiserte feil. Operasjonell telemetri bør avdekke inndata‑kvalitet, utdata‑adferd, modell‑ eller regelversjon, avhengighets‑helse, menneskelige overstyringer og bekreftede resultater uten å samle unødvendige sensitive data. Definer varslings‑terskler og en respons‑eier, og gjennomgå virkelige bevis etter utrulling i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, retningslinjer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelses‑læring, sletting‑ og lagringsprosedyrer, og et tydelig punkt hvor det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Er datavitenskap det samme som dataanalyse?
Begrepene overlapper. Datavitenskap inkluderer ofte bygging av dataprodukter og prediktive systemer, mens analyse kan fokusere mer på beskrivende og diagnostisk beslutningsstøtte. Bruken varierer mellom organisasjoner.
Trenger hvert datavitenskapsprosjekt AI?
Nei. En velutformet spørring, diagram, eksperiment eller statistisk estimat kan være mer nyttig og pålitelig enn en kompleks modell.
Primære referanser