Grunnleggende AI
Hva er dimensjonsreduksjon?

 Legg til Unite.AI blant dine foretrukne kilder på Google
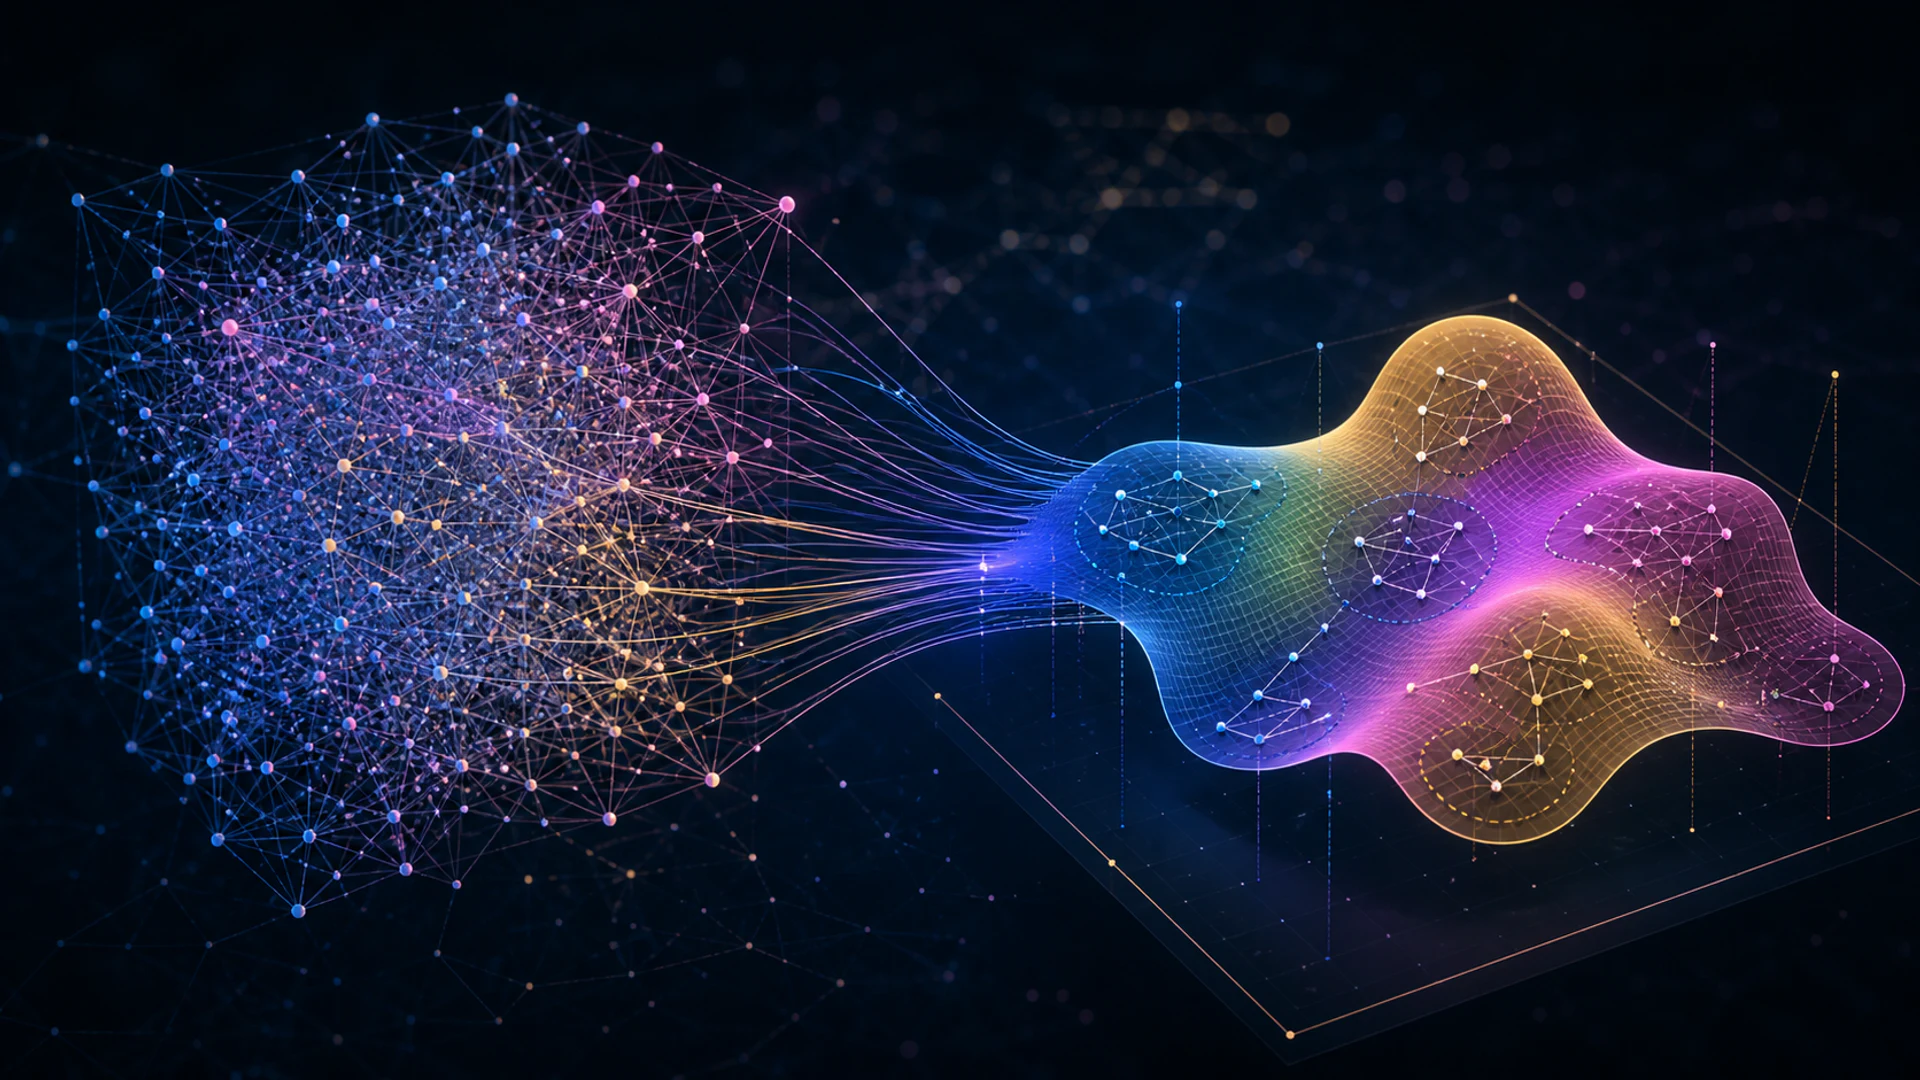
Dimensjonsreduksjon representerer data med færre variabler samtidig som den bevarer informasjon som er nyttig for en oppgave. Den kan redusere lagring og støy, forbedre visualisering, dempe redundante funksjoner og gjøre etterfølgende modeller enklere å trene.
Ingen metode bevarer alle relasjoner. En nyttig reduksjon starter med å angi hva som skal overleve: varians, klasseadskillelse, lokale naboskap, global geometri, rekonstruksjonskvalitet eller tolkbarhet.
Viktige punkter
- Funksjonsutvelgelse beholder de originale variablene; funksjonsekstraksjon lager nye lavdimensjonale koordinater.
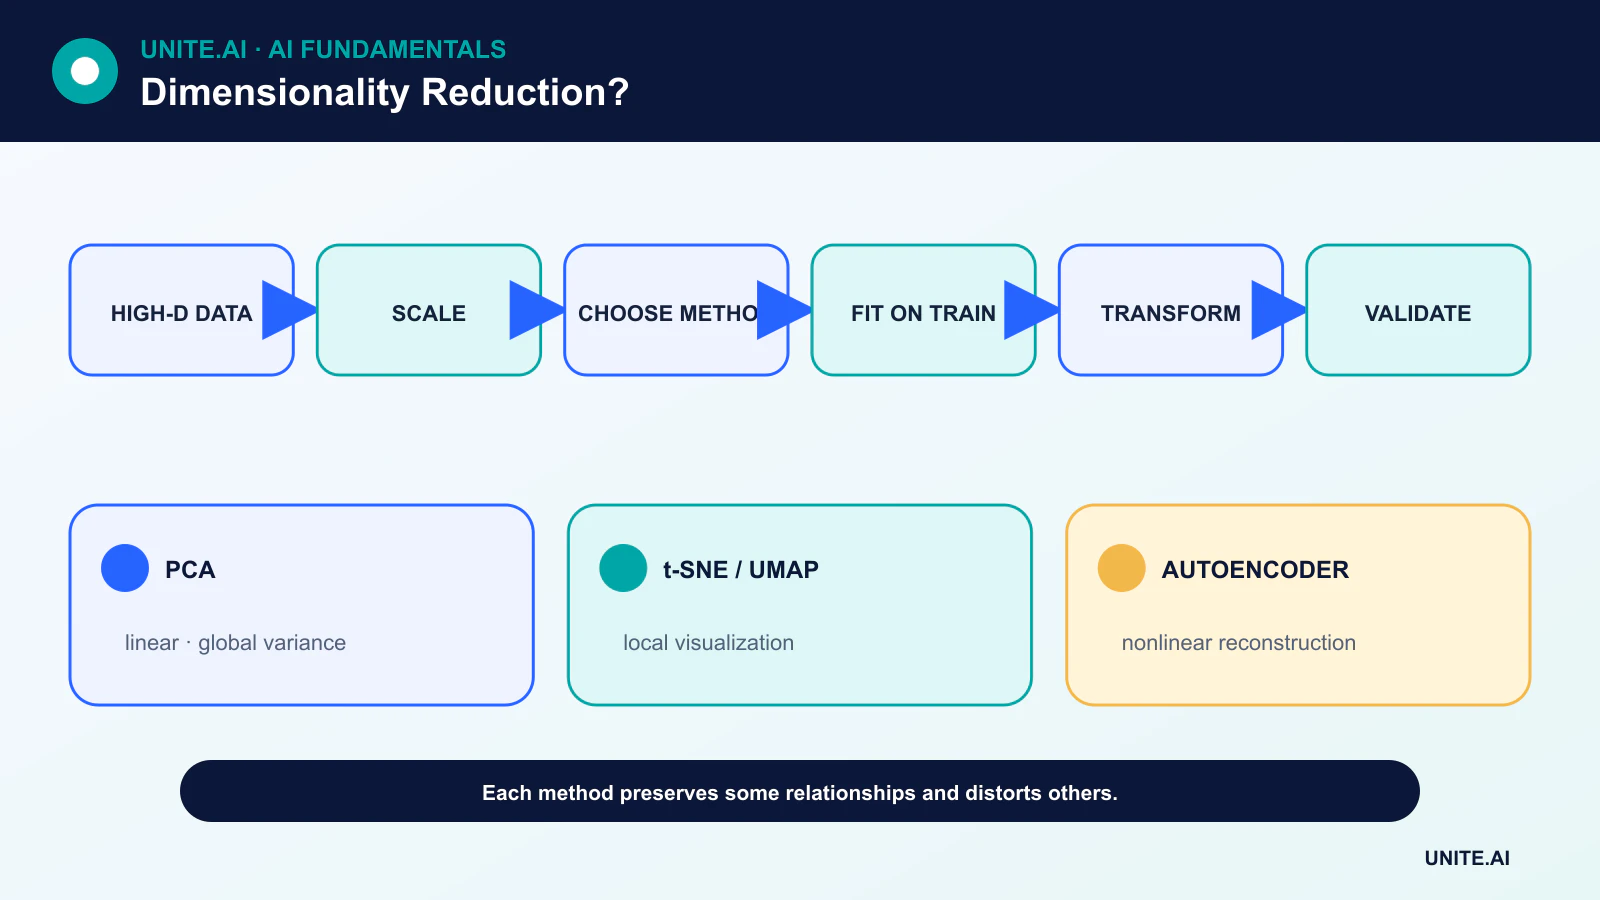
- PCA er lineær og variansorientert; t-SNE og UMAP legger vekt på nabostruktur for visualisering.
- Visualiserings‑innbygginger kan forvrenge avstander, klynge‑størrelser og global separasjon.
- Tilpass reduksjonen kun på treningsdata, og anvend deretter den lærte transformasjonen på validerings‑ og testdata.
Funksjonsutvelgelse versus projeksjon
Funksjonsutvelgelse fjerner variabler ved hjelp av domeneregler, manglende verdier, redundans, prediktive tester eller regularisering. Den bevarer de originale betydningene, noe som kan hjelpe styring og forklaring.
Projeksjonsmetoder kombinerer variabler til nye koordinater. De kan fange distribuert struktur, men kan gjøre hver koordinat vanskeligere å tolke. En autoencoder lærer en ikke‑lineær projeksjon gjennom rekonstruksjon.
PCA og SVD
Hovedkomponentanalyse identifiserer ortogonale retninger med synkende varians etter sentrering av dataene. Singularverdidekomposisjon gir en vanlig numerisk tilnærming. Skala er viktig: en måleenhet med høy varians kan dominere komponentene.
PCA er deterministisk bortsett fra fortegn og gjentatte egenverdier, støtter transformasjon utenfor prøvetaking og gir oppsummeringer av forklart varians. Høy varians er ikke alltid oppgave‑relevant, og lineære komponenter kan ikke utfoldes på alle krumme mangfold.
t-SNE og UMAP
t-SNE konstruerer sannsynlighetsfordelinger over naboer og optimaliserer et lavdimensjonalt kart som vektlegger lokal likhet. UMAP bygger en vektet nabografer og optimaliserer en lavdimensjonal representasjon med relaterte mål for lokal struktur.
Begge er kraftige utforskende verktøy, men er følsomme for forhåndsbehandling, avstandsmål og hyperparametere. Tomt rom, klynge‑areal og avstand mellom klynger i et 2D‑plott bør ikke automatisk gis en virkelighetsbasert tolkning.
Overvåkede metoder og oppgavebevisste representasjoner
Lineær diskriminantanalyse bruker klasselabeler for å søke separasjon, noe som gjør den forskjellig fra usupervisert PCA. Nevrale representasjons‑læring kan optimalisere prediksjon‑ eller kontrastive mål i stedet for rekonstruksjon.
Hvis etiketter styrer reduksjonen, må all tilpasning og justering forbli innenfor treningsprosessen. Ellers kan informasjon fra testsettet lekke inn i modellutvelgelsen og skape et optimistisk resultat.
Velge og validere en metode
Begynn med forhåndsbehandling og en enkel basislinje. For komprimering, mål rekonstruksjon eller etterfølgende ytelse på tvers av dimensjoner. For visualisering, test stabilitet på tvers av frø og hyperparametere og sammenlign nabobevaring med domenekunnskap.
For produksjon, spør om metoden kan transformere nye poster, hvordan den håndterer manglende verdier, om den endres ved ny trening og om brukere trenger forklaringer på de originale funksjonene. Overfitting kan forekomme i reduksjonstrinnet akkurat som i den endelige modellen.
Lineære og ikke‑lineære reduksjonsmetoder
Dimensjonsreduksjon kartlegger høy‑dimensjonale data til færre koordinater samtidig som den bevarer valgt struktur. Hovedkomponentanalyse finner ortogonale retninger med maksimal varians etter sentrering; skala er nødvendig når enheter skal bidra på likt grunnlag. Singularverdidekomposisjon beregner relatert lav‑rang struktur og støtter sparsomme matriser. Lineær diskriminantanalyse bruker etiketter for å finne klasse‑separerende retninger. Disse metodene gir eksplisitte transformasjoner, men varians eller klasseadskillelse kan mislykkes i å bevare informasjonen som kreves for en etterfølgende oppgave.
Mangfoldsmetoder som t‑SNE og UMAP konstruerer naboskap og optimaliserer et lav‑dimensjonalt oppsett. De er kraftige for utforskning, men forvrenger global avstand, tetthet, klynge‑størrelse og noen ganger separasjon. Resultatene avhenger av forhåndsbehandling, metrikk, naboer eller perplexity, initiering og frø. En tiltalende klynge i to dimensjoner kan oppstå selv uten diskrete grupper. Bruk flere innstillinger, farg kun etter metadata som ikke brukes i tilpasning, og valider tilsynelatende struktur i det originale rommet eller med uavhengige etiketter.
Funksjonsutvelgelse, innbygginger og evaluering
Funksjonsutvelgelse beholder de originale variablene gjennom filtre, wrappers eller modell‑basert viktighet; representasjons‑læring skaper nye latente funksjoner ved bruk av autoencodere eller overvåkede modeller. Tilfeldige projeksjoner bevarer avstander omtrentlig under visse betingelser og gir effektive basislinjer. Velg metode basert på komprimering, visualisering, støyreduksjon, hastighet, lagring eller modell‑ytelse. Tilpass reduksjonen kun på treningsdata, og transformer deretter validerings‑ og testsett. Overvåket reduksjon må nestes inn i kryss‑validering for å unngå etikett‑lekkasje.
Evaluer forklart varians eller rekonstruksjon for lineær komprimering, pålitelighet og nabobevaring for visualisering, samt etterfølgende nøyaktighet, kalibrering, latens og robusthet for prediksjon. Mål stabilitet på tvers av prøver og frø. Undersøk om sjeldne klasser eller sensitive grupper blir slått sammen og om omvendt kartlegging er mulig. Reduserte koordinater kan fortsatt inneholde privat informasjon; et todimensjonalt plott er ikke anonymisering. Dokumenter transformasjonen, skalereren, rekkefølgen på funksjonene og begrensningene.
Produksjonsbruk
Tjeneste krever den eksakte tilpassede transformasjonen og inndataskjemaet. Overvåk manglende funksjoner, rekkeviddeskift, komponent‑score‑fordeling, rekonstruksjonsfeil og etterfølgende resultater. Hvis nye kategorier eller sensorer dukker opp, tren på nytt og versjoner hele pipeline‑en i stedet for å legge til kolonner stille. Reduksjon kan forbedre beregning og fjerne støy fra en modell, men den kan også forkaste svake signaler som er viktige for sjeldne hendelser. Behandle den som et lært målesteg hvor både beholdt og tapt informasjon må testes mot beslutningen.
Arbeidseksempel: redusere kundeadferds‑funksjoner
En analytiker standardiserer 200 adferdsmål og tilpasser PCA kun på treningskundene. Kryss‑validering velger antall komponenter basert på etterfølgende churn‑ytelse og stabilitet, ikke et todimensjonalt spredningsplott. Lastinger inspiseres for dominerte kilder og manglende verdier. PCA, funksjonsutvelgelse, tilfeldig projeksjon og en u‑reduksjonert regularisert modell sammenlignes på kalibrering, latens og resultater for sjeldne kundesegmenter. Gjentatte prøver tester også om de ledende komponentene og etterfølgende konklusjoner forblir stabile.
Den distribuerte pipeline‑en fastsetter funksjonsrekkefølge, skalerer og komponenter og avviser manglende skjema‑versjoner. Overvåkning sporer komponentfordelinger, rekonstruksjonsfeil og etterfølgende resultater. En visualisering med tilsynelatende klynger brukes til å generere spørsmål, ikke til å tildele kundepersonas. Siden latente komponenter fortsatt koder adferd, forblir tilgang og oppbevaring kontrollert. Hvis kilde‑definisjoner endres, bygges den komplette transformasjonen og modellen på nytt og valideres i stedet for å projisere inkompatible data inn i gamle komponenter.
Implementeringsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, innganger, utganger, avhengigheter, eier og konsekvensene av hver viktig feil. Etabler en reproduserbar basislinje og et versjonert evalueringssett før justering. Test vanlige tilfeller, grensetilstander, feilformatert eller manglende input, distribusjonsendring, avhengighets‑nedbrudd, misbruk, og gruppene eller miljøene som sannsynligvis blir underbetjent. Mål oppgavekvalitet sammen med kalibrering eller usikkerhet, latens, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig reviewer kan reprodusere resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåkning med bevisst injiserte feil. Operasjonell telemetri bør avdekke input‑kvalitet, output‑adferd, modell‑ eller regelversjon, avhengighets‑helse, menneskelige overstyringer og bekreftede resultater uten å samle inn unødvendige sensitive data. Definer varslings‑terskler og en ansvarlig for respons, og gjennomgå virkelige bevis etter utrulling i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, retningslinjer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelses‑læring, slettings‑ og oppbevaringsprosedyrer, og et klart punkt hvor det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Forbedrer dimensjonsreduksjon alltid en modell?
Nei. Den kan forkaste prediktiv informasjon eller komplisere tolkning. Sammenlign med en basislinje uten reduksjon på hold‑out‑data.
Beviser adskilte t‑SNE‑klynger at reelle klasser eksisterer?
Nei. Kartet er en optimalisert visualisering av naborelasjoner og kan skape tilsynelatende separasjon. Valider klynger med uavhengige bevis.
Primære referanser