Grunnleggende AI
Hva er Support Vector Machines?

 Legg til Unite.AI blant dine foretrukne kilder på Google
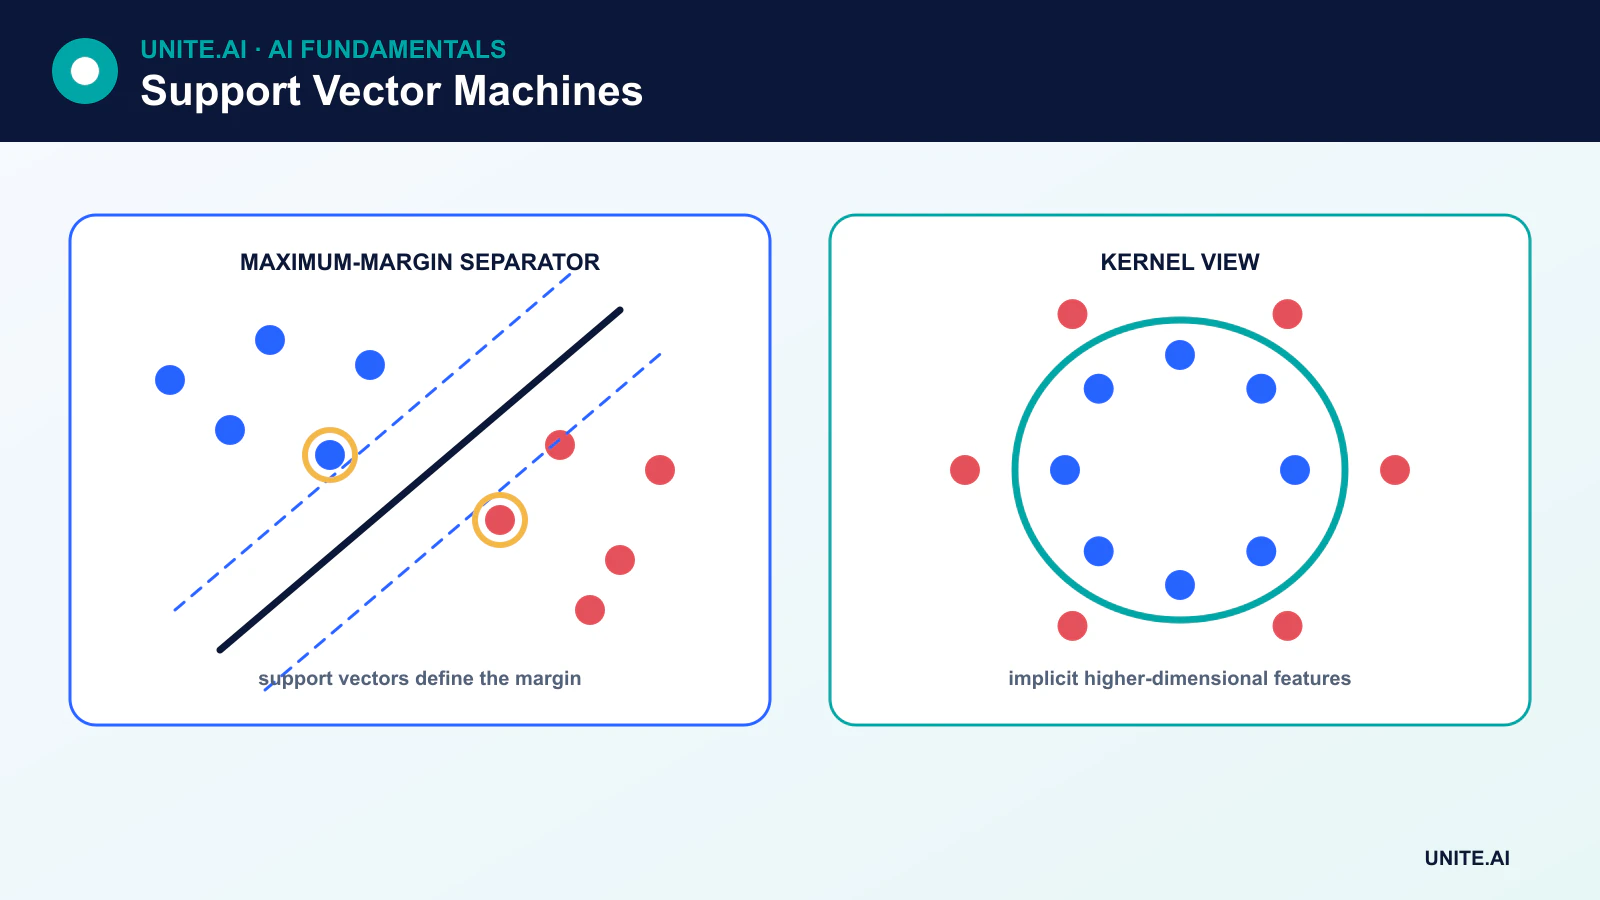
En supportvektormaskin (SVM) er en overvåket læringsmetode som finner en beslutningsgrense med den bredest mulige marginen mellom klasser. Treningseksemplene som bestemmer den grensen er supportvektorer.
SVM-er kan utføre lineær eller ikke‑lineær klassifisering, regresjon og nyhetsdeteksjon. De er spesielt nyttige for små til mellomstore datasett med informative trekk, inkludert høy‑dimensjonale sparsomme data, men treningskostnaden kan bli upraktisk på svært store datasett.
Viktige punkter
- En SVM maksimerer den minste marginen mellom grensen og de nærmeste treningspunktene.
- Supportvektorer er datapunkter, ikke ekstra hyperplan.
- Parameteren C balanserer marginbredden mot straffer for brudd.
- Kjerner beregner likhet i et implisitt funksjonsrom uten å eksplisitt materialisere hver transformert funksjon.
Ideen om maksimal margin
For en lineær binær klassifikator er beslutningsgrensen et hyperplan:
w · x + b = 0
Vektoren w bestemmer orienteringen og b forskyvningen. Mange hyperplan kan skille treningsklassene. SVM-en velger det som maksimerer avstanden til de nærmeste eksemplene på hver side. Disse nærmeste eksemplene er supportvektorer og har størst innflytelse på den tilpassede grensen.
Målet er ikke å maksimere avstanden fra grensen til hvert punkt uavhengig. Den maksimerer den minste marginen samtidig som den oppfyller eller straffer klassebegrensninger.
Hard‑ og soft‑marginer
En hard‑margin SVM krever perfekt lineær separasjon og er sensitiv for avvikere. Reelle datasett krever vanligvis en soft margin, som introduserer slakkvariabler for observasjoner innenfor marginen eller på feil side av grensen.
Hyperparameteren C styrer straffen for disse bruddene:
- En større C straffer brudd sterkere og gir ofte en smalere margin som følger treningseksemplene tettere.
- En mindre C tillater flere brudd i bytte for en bredere, mer regularisert margin.
Antallet supportvektorer er et resultat av dataene og løsningen; økning av C garanterer ikke et bestemt antall supportvektorer.
Kjerne‑trikset
Noen klasser kan ikke separeres med et rett hyperplan i det opprinnelige funksjonsrommet. En kjerne evaluerer et indre produkt som tilsvarer et annet funksjonsrom. Dette gjør at SVM-en kan tilpasse en ikke‑lineær grense uten å eksplisitt beregne hver transformert koordinat.
Vanlige kjerner inkluderer:
- Linear: effektiv for høy‑dimensjonale sparsomme trekk som tekst.
- Polynomial: modellerer interaksjoner opp til en valgt grad.
- Radial basis function (RBF): lager fleksible lokale grenser basert på avstand.
- Sigmoid: ligner en nevral aktivering, men er mindre vanlig som standardvalg.
For en RBF‑SVM kontrollerer gamma hvor lokalt hvert treningseksempel påvirker grensen. Stor gamma kan skape svært detaljerte regioner og overtilpasse; liten gamma gir en jevnere påvirkning.
Multiklasse‑klassifisering
Det klassiske SVM‑målet er binært. Biblioteker utvider det ved hjelp av strategier som one-vs-rest, som trener én klassifikator per klasse, eller one-vs-one, som trener klassifikatorer for klassepar og kombinerer deres beslutninger. Multiklasse‑SVM-er trekker ikke bare én linje mindre enn antall klasser.
Supportvektor‑regresjon og én‑klasse SVM
Supportvektor‑regresjon (SVR) tilpasser en funksjon mens den ignorerer feil innenfor et epsilon‑bredt rør og straffer større avvik. En én‑klasse SVM estimerer en grense rundt typiske data og kan støtte nyhetsdeteksjon. Et uvanlig punkt er ikke automatisk svindel eller feil; det er uvanlig i forhold til den tilpassede representasjonen.
Praktiske krav
SVM-er avhenger av avstander og indre produkter, så numeriske trekk trenger vanligvis skalering. C, kjerne, gamma og klassevekter bør velges gjennom validering. Sannsynlighetsestimater er ikke iboende i marginen og krever ofte kalibrering, noe som øker kostnadene og bør evalueres separat.
Trening av kjerne‑SVM kan skaleres mellom kvadratisk og kubisk tid i antall prøver, avhengig av data og implementasjon. Lineære SVM-varianter eller stokastiske lineære modeller er bedre egnet for svært store datasett. For rå bilder, lyd eller språk kan lærte representasjoner fra dyp læring være mer effektive, mens en SVM fortsatt kan klassifisere en fast innebygd representasjon.
SVM‑styrker og begrensninger
SVM-er kan fungere godt med mange trekk, tilbyr et tydelig regularisert mål, og avhenger hovedsakelig av supportvektorer ved prediksjon. Begrensninger inkluderer sensitivitet for skalering og hyperparametere, potensielt kostbar trening, redusert tolkbarhet under ikke‑lineære kjerner, og krav til sannsynlighetskalibrering.
Marginer, kjerner og optimaliseringsmålet
En supportvektormaskin søker et separerende hyperplan med en stor margin mellom klasser. Kun supportvektorer på eller innenfor marginen bestemmer grensen. Soft‑margin SVM-er introduserer slakk for overlapp og feilmerkede punkter; parameteren C bytter en bredere margin mot treningsbrudd. Inndata bør vanligvis skaleres fordi avstand og prikkprodukter driver løsningen. Klassevekter eller resampling hjelper når feilkostnader og forekomst er ulikt fordelt, men terskler og sannsynligheter krever fortsatt uavhengig validering.
Kjerne‑trikset evaluerer likhet som om inndata ble kartlagt til et høyere‑dimensjonalt funksjonsrom. Lineære, polynomiale, radial‑basis og spesialiserte kjerner kodar ulike antakelser. For en RBF‑kjerne kontrollerer gamma hvor lokalt hvert punkt påvirker grensen: høy gamma kan skape intrikate regioner og overtilpasse, mens lav gamma kan under‑tilpasse. Kernematriser vokser kvadratisk med antall prøver, noe som gjør ikke‑lineære SVM-er dyre på store datasett. Lineære løsnere eller tilnærmede funksjonskart er ofte foretrukket i stor skala.
Multiklasse‑bruk, kalibrering og operasjonelle begrensninger
Binære SVM-er utvides til multiklasse via one‑vs‑rest, one‑vs‑one eller strukturerte formuleringer. Hyperparametere må tunes innen kryss‑validering, med grupperte eller tidsmessige splittelser der det er nødvendig. Evaluer klasse‑spesifikk presisjon og tilbakekalling, marginfordelinger, kalibrering og ytelse under skift. Rå beslutningsskår er ikke sannsynligheter; Platt‑skalering eller isotonskalibrering bruker separate data og kan forverres hvis forekomsten endres. Sammenlign med logistisk regresjon, trær og moderne representasjonsbaserte metoder med lik forbehandling og tuning‑innsats.
Distribusjon krever nøyaktig skalerings‑verktøy, funksjonsrekkefølge, kjerneparametere, supportvektorer og klassemapping. Prediksjonskostnaden for en kjerne‑SVM vokser med antall supportvektorer, så mål latens og minne på realistiske batcher. Inndata langt fra treningssupport kan fortsatt få sikre etiketter; legg til out‑of‑distribution‑kontroller eller en avståelses‑policy der det er hensiktsmessig. Undersøk feil for sensitive proxy‑variabler og datasettartefakter. SVM-er forblir sterke for mellomstore, høy‑dimensjonale problemer, men en maksimal geometrisk margin er ikke bevis på kausal struktur eller sikkerhet.
Arbeidseksempel: en SVM for sjelden dokumentruting
Et juridisk operasjonsteam klassifiserer korte innleveringer i rutekategorier ved hjelp av TF–IDF‑trekk og en lineær SVM. Det splittes etter sak og tid for å hindre at maler lekker, skalerer klassevekter basert på gjennomgått feil‑kostnad, og tuner C i nestet validering. Den lineære modellen sammenlignes med logistisk regresjon og en transformer. Per‑klasse presisjon, tilbakekalling, kalibrering og korrekturarbeid er viktigere enn total nøyaktighet.
Beslutningsskår kalibreres på separate data, og dokumenter med lav margin eller uten støttet språk går til manuell inntak. Distribusjons‑artefakten inkluderer tokeniserer, vokabular, vektlegging, modell, kalibrering og etikett‑kart. Overvåkning sporer nye termer, kategori‑forekomst, marginer og korrigerte ruter. Dokumenter og supportvektorer beskyttes fordi teksttrekk kan avsløre konfidensiell informasjon. En ikke‑lineær kjerne avvises når dens lille kvalitetsgevinst ikke kan rettferdiggjøre latens, minne‑ og tolkingskostnad.
Implementeringsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, inndata, utdata, avhengigheter, eier og konsekvensen av hver viktig feil. Etabler en reproduserbar basislinje og et versjonert evalueringssett før tuning. Test vanlige tilfeller, randbetingelser, feil‑ eller manglende inndata, distribusjons‑skift, avhengighets‑nedbrudd, misbruk, og gruppene eller miljøene som sannsynligvis blir underbetjent. Mål oppgavens kvalitet sammen med kalibrering eller usikkerhet, latens, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig vurderer kan reprodusere resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåkning med bevisst injiserte feil. Operasjonell telemetri bør avdekke inndata‑kvalitet, utdata‑adferd, modell‑ eller regelversjon, avhengighets‑helse, menneskelige overstyringer og bekreftede resultater uten å samle unødvendige sensitive data. Definer varslings‑terskler og en responsansvarlig, og gjennomgå virkelige bevis etter distribusjon i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, retningslinjer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelses‑læring, slettings‑ og oppbevaringsprosedyrer, samt et klart tidspunkt for når det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Utfører SVM-er kun klassifisering?
Nei. Supportvektor‑regresjon forutsier kontinuerlige mål, mens en én‑klasse SVM kan estimere en nyhetsgrense. Hver variant har et annet mål og et eget sett med hyperparametere.
Når er en lineær SVM et sterkt valg?
Lineære SVM-er er ofte effektive for høy‑dimensjonale sparsomme trekk, inkludert tradisjonelle tekstrepresentasjoner, der en fleksibel kjerne ville tilføre kostnad uten klar nytte.
Primære referanser