Grunnleggende AI
Hva er få‑skudds‑læring?

 Legg til Unite.AI blant dine foretrukne kilder på Google
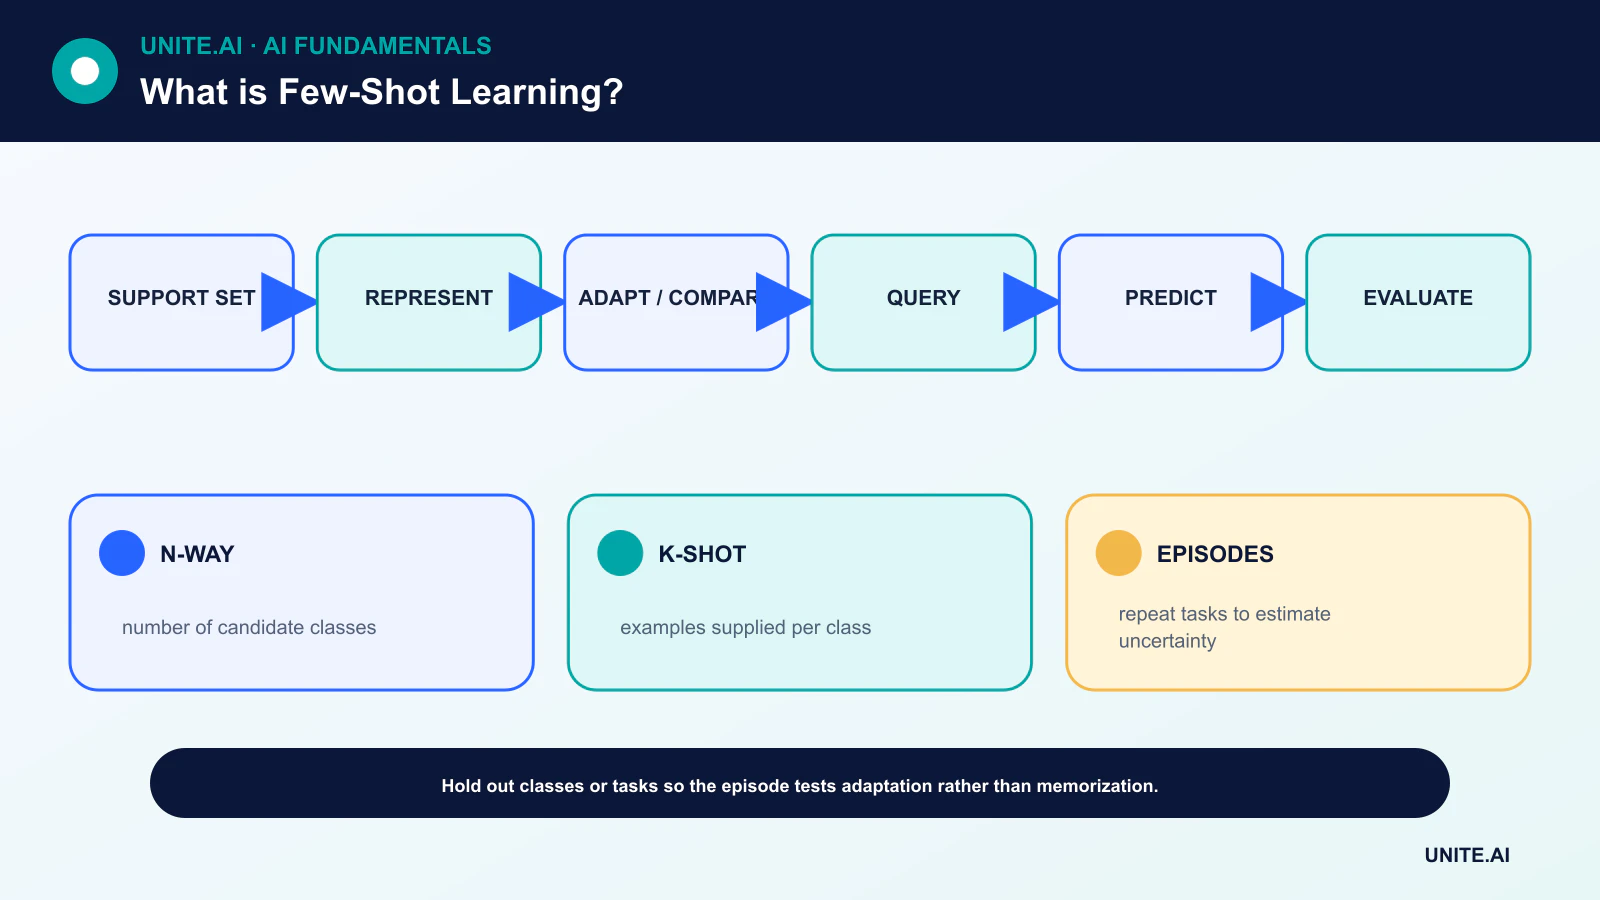
Few-shot learning studerer hvordan en modell kan tilpasse seg en ny oppgave eller klasse med kun et lite antall merkede eksempler. I klassiske tester gir en episode et støttesett – for eksempel fem klasser med ett eller fem eksempler per klasse – og ber modellen klassifisere usette spørringer.
Begrepet brukes også om in‑context‑læring, hvor en forhåndstrent språkmodell får noen demonstrasjoner i prompten uten å oppdatere parametere. Disse oppsettene deler målet om få eksempler, men benytter ulike tilpasningsmekanismer og krever forskjellige evalueringsdesign.
Viktige poeng
- N‑way K‑shot beskriver N klasser og K merkede støtteeksempler per klasse.
- Metric‑learning‑metoder sammenligner spørringer med innlærte representasjoner av støtteeksempler.
- Meta‑learning optimaliserer over mange oppgaver slik at en ny oppgave kan læres raskt.
- Få eksempler forsterker merkefeil, lekkasje, klasse‑uklarhet og usikkerhet, så referansebaser og rapportering av konfidens er viktig.
Episoder, støttemengder og spørringsmengder
En few‑shot‑episode skiller en liten merket støttemengde fra en spørringsmengde som brukes til evaluering. Under meta‑trening ser modellen mange slike episoder. En grundig evaluering holder tilbake hele klasser, oppgaver eller domener slik at test‑episoden måler tilpasning i stedet for memorering.
Rapporter nøyaktighetsfordelinger over mange episoder i stedet for ett enkelt utvalg. Sammenlign med enkle nærmeste‑nabos‑ og lineære referansemetoder; en sofistikert metode som ikke kan slå en godt trent representasjon pluss en enkel klassifikator, rettferdiggjør kanskje ikke sin kompleksitet.
Metrisk læring og prototyper
Matching‑nettverk og relaterte metoder embedder støtte‑ og spørringseksempler i et rom hvor nærliggende vektorer bør dele samme label. Prototypiske nettverk tar gjennomsnittet av støtte‑embeddingene for hver klasse og klassifiserer en spørring basert på avstanden til disse klasse‑prototypene.
Dette knytter few‑shot‑læring til kvaliteten på representasjoner. En forhåndstrent deep‑learning‑modell kan allerede organisere relevante trekk godt, mens en mismatchede representasjon kan gjøre hver avstand misvisende.
Optimaliseringsbasert meta‑learning
Model‑Agnostic Meta‑Learning søker etter parametere som kan tilpasses med et lite antall gradientsteg. Andre metoder lærer en optimizer, en initialisering eller en regel for parameteroppdatering. Den ytre løkken evaluerer ytelsen etter tilpasning på tvers av oppgaver.
Meta‑learning forutsetter at nyttig struktur deles mellom trenings‑ og måloppgaver. Når måldistribusjonen avviker kraftig, kan rask tilpasning mislykkes. Validering bør variere antall skudd, klasser, domener og oppgavevanskelighet i stedet for å behandle ett referansepunkt som universelt.
Transfer‑learning og datanivå‑strategier
Transfer learning er ofte det sterkeste praktiske utgangspunktet: fryse en forhåndstrent enkoder, trene et lite hode, og deretter fin‑tune selektivt dersom nok data finnes. Data‑augmentering kan innføre invarians, men urealistiske syntetiske eksempler kan forsterke skjevhet eller skape snarveier.
Aktiv læring kan prioritere hvilke eksempler som skal merkes, mens semi‑supervised læring kan bruke ekstra umerkede data. Dette er komplementære strategier, ikke synonymer for few‑shot‑læring.
Few‑shot‑prompting er annerledes
En transformer kan inferere et mønster fra demonstrasjoner plassert i konteksten. Ingen vedvarende parameteroppdatering er nødvendig. Rekkefølge, formulering og balanse i etiketter kan materiell endre resultatet, og eksempler kan bruke en stor del av kontekstvinduet.
Bruk et representativt evalueringssett, versjoner hver prompt og demonstrasjon, og test null‑shot, few‑shot og fin‑tune‑alternativer. Et lite støttemengde støtter ikke sterke påstander på befolkningsnivå, spesielt for sjeldne eller sikkerhetskritiske tilfeller.
Few‑shot‑læringsparadigmer og oppgavekonstruksjon
Few‑shot‑læring har som mål å utføre en oppgave med svært få merkede eksempler. I metrisk‑baserte metoder kartlegger en enkoder eksempler til et rom hvor nærmeste prototyper eller naboer representerer klasser. Optimaliserings‑basert meta‑learning trener en initialisering eller oppdateringsregel for rask tilpasning. Transfer‑learning fin‑tuner en forhåndstrent modell på et lite målsett. In‑context‑læring leverer eksempler i en prompt uten å oppdatere vekter. Disse mekanismene er ulike, så påstander bør spesifisere om parametere endres, hvilken tidligere trening som har skjedd, og hvordan eksempler velges.
Evaluering bør skille trenings‑ og testklasser, oppgaver, subjekter eller domener i henhold til påstått generalisering. En N‑way K‑shot‑episode inneholder N klasser og K støtteeksempler per klasse, samt spørringseksempler for poengsetting. Gjentatte episoder estimerer varians fra støtteseleksjon. For prompting kan rekkefølge på eksempler, etikettformulering, format og likhet i demonstrasjoner materiell endre resultatene. Sammenlign med null‑shot, nærmeste‑nabos, lineær‑probe og vanlige fin‑tune‑referanser ved bruk av samme representasjon og databudsjett.
Datakvalitet, usikkerhet og negativ transfer
Med få eksempler har feilmerkede eller atypiske tilfeller en uforholdsmessig stor påvirkning. Definer annotasjonsregler, inspiser hvert støttelement, og behold et ukjent‑ eller avstå‑utfall. Data‑augmentering og syntetiske eksempler kan hjelpe kun når de bevarer oppgaven og tilfører realistisk variasjon. En forhåndstrent modell kan overføre snarveier eller skjevhet fra sin kilde‑domene. Test utenfor‑domene‑tilfeller, sjeldne grupper, og følsomhet for fjerning av ett støtteeksempel. Rapporter konfidensintervaller på tvers av oppgaver og tilfeldige frø, ikke én gunstig prompt.
Aktiv læring kan be om etiketter på informative tilfeller, mens semi‑supervised metoder bruker umerkede data under ekstra antakelser. Gjenfinning kan velge relevante demonstrasjoner dynamisk, men må unngå lekkasje av test‑etiketter. Tilpasning kan overtilpasse raskt, så begrens oppdateringer, bruk regularisering, og valider på separate eksempler. For oppgaver med høy risiko, rettferdiggjør få etiketter sjelden autonome beslutninger; bruk modellen til å prioritere eller bistå gjennomgang til tilstrekkelig bevis for resultatet foreligger.
Produksjonsdrift
Versjonér grunnmodellen, embedding‑ eller prompt‑malen, demonstrasjoner, etikett‑skjemaet og tilpasningsparametere. Beskytt eksempler fordi prompts eller gradienter kan avsløre sensitive opplysninger. Overvåk ytelse etter hvert som klasser og språk endres, og oppdater støtteeksempler gjennom styrt gjennomgang i stedet for automatisk selv‑merking. Few‑shot‑læring reduserer behovet for merkede mål ved å utnytte tidligere struktur; den eliminerer ikke behovet for representativ evaluering, nøye oppgave‑definisjon, domene‑ekspertise eller en sikker fallback når den nye oppgaven ligger utenfor dette forutsetningene.
Arbeidseksempel: few‑shot‑klassifisering for et nytt produkt
Et supportteam trenger rutingsetiketter for et produkt med kun fem gjennomgåtte eksempler per sak. Det sammenligner nærmeste prototyper i en forhåndstrent embedding, et lineært hode, parameter‑effektiv fin‑tuning og in‑context‑prompting. Produktfamilier, kunder og senere meldinger holdes utenfor meta‑trening og modellutvelgelse. Gjentatt sampling av støttemengde rapporterer klasserecall, kalibrering, varians og sensitivitet for én feilmerket demonstrasjon.
Meldinger med lav tillit og uten støtte dirigeres til generell support, og gjennomgåere korrigerer etiketter via en styrt kø. Eksempler blir avidentifisert, versjonert og blir aldri valgt fra det endelige testsettet. Overvåking sporer nytt vokabular, klasse‑frekvenser, korrigeringer og uenighet. Når nok etiketter har samlet seg, sammenlignes few‑shot‑systemet med vanlig supervisert trening. Rask oppsett er nyttig, men rettferdiggjør ikke automatisering dersom ytelsen forblir ustabil eller dersom det nye produktet avviker betydelig fra tidligere oppgave‑familier.
Implementasjonsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, innganger, utganger, avhengigheter, eier og konsekvensen av hver viktig feil. Etabler en reproduserbar basislinje og et versjonert evalueringssett før justering. Test vanlige tilfeller, grensetilstander, feilformet eller manglende input, distribusjons‑skift, avhengighets‑nedbrudd, misbruk, og gruppene eller miljøene som mest sannsynlig blir underbetjent. Mål oppgavekvalitet sammen med kalibrering eller usikkerhet, latency, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig reviewer kan reprodusere resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåkning med bevisst injiserte feil. Operasjonell telemetri bør avdekke input‑kvalitet, output‑atferd, modell‑ eller regelversjon, avhengighets‑helse, menneskelige overstyringer og bekreftede resultater uten å samle unødvendige sensitive data. Definer varslings‑terskler og en ansvarlig for respons, og gjennomgå virkelige bevis etter distribusjon i stedet for å anta at offline‑ytelse vedvarer. Revurder når datakilder, brukere, modeller, leverandører, retningslinjer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelses‑læring, sletting‑ og lagringsprosedyrer, samt et klart punkt hvor det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Er one‑shot‑læring det samme som few‑shot‑læring?
One‑shot‑læring er det spesielle tilfellet med ett merket støtteeksempel per klasse eller oppgave. Zero‑shot‑læring bruker ingen merkede mål‑eksempler.
Eliminerer few‑shot‑læring behovet for data?
Nei. Det flytter avhengigheten mot forhåndstreningsdata, relaterte oppgaver, representasjoner og antakelser. Måletikettene er få; den samlede læringshistorikken er vanligvis stor.
Primære referanser