
Grunnleggende AI
Hva er KNN (K-nærmeste naboer)?

 Legg til Unite.AI blant dine foretrukne kilder på Google
K-nearest neighbors (KNN) forutsier et resultat basert på de merkede trenings‑eksemplene som er nærmest et spørringspunkt. For klassifisering stemmer naboene på klassen. For regresjon blir deres målverdier gjennomsnittet eller på annen måte kombinert.
KNN er en instansbasert, ikke‑generalisende metode: tilpasning lagrer i hovedsak trenings‑eksemplene og en eventuell søkeindeks. Det fjerner ikke behovet for trenings‑, validerings‑ og test‑splitt. Evaluering på hold‑out‑data er essensiell for valg av k, avstandsmål, funksjonsbehandling og stemmeregel.
Viktige punkter
- KNN forutsier lokalt; den deler ikke først datasettet inn i klynger.
- Funksjonsskala er kritisk fordi avstand definerer hvilke eksempler som teller som naboer.
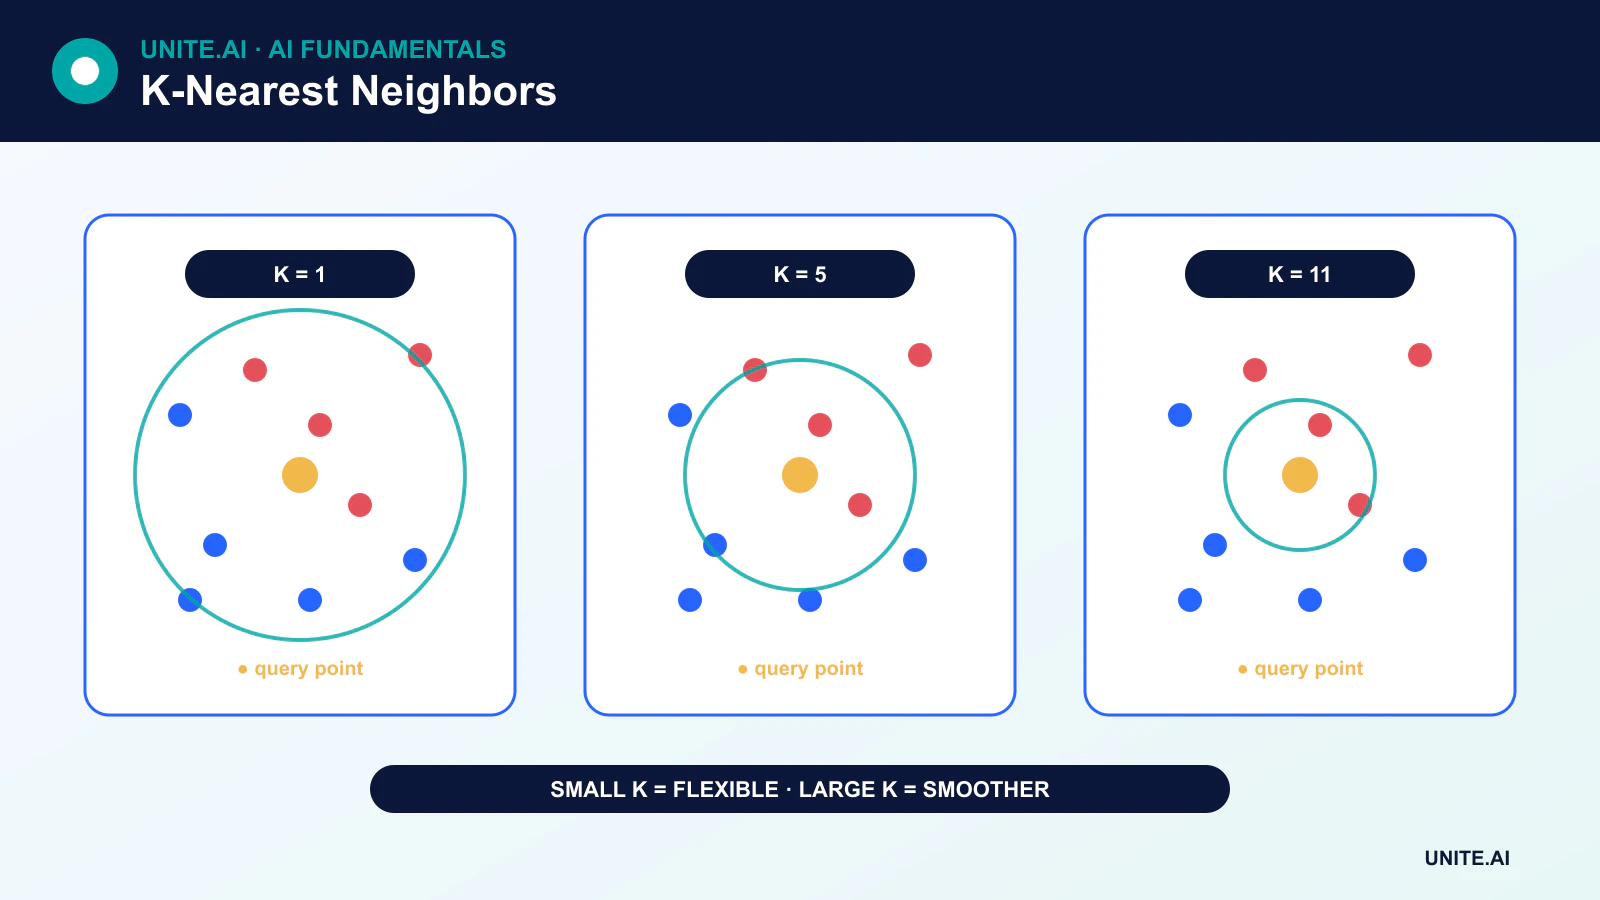
- Liten k kan være støyende, mens stor k kan jevne bort lokal struktur.
- Høye dimensjoner, irrelevante funksjoner, klasseubalanse og treg søking kan begrense ytelsen.
Hvordan KNN-klassifisering fungerer
- Representer spørringen og trenings‑eksemplene i samme funksjonsrom.
- Beregn avstanden fra spørringen til trenings‑eksemplene.
- Velg de k nærmeste eksemplene.
- Forutsig majoritetsklassen eller bruk avstandsvektet stemming.
Avstandsvektet stemming gir nærmere naboer mer innflytelse. Ved likhet må en dokumentert regel brukes, og naboer med lik avstand men ulike etiketter kan gjøre resultatene avhengige av rekkefølge eller implementasjonsdetaljer.
KNN-regresjon
For regresjon er prediksjonen vanligvis gjennomsnittet av nabomålene. Avstandsvekting kan redusere påvirkningen fra fjernere observasjoner. Median eller robust aggregasjon kan være nyttig når lokale mål inneholder avvikere.
Avstandsmål
Euclidisk avstand er vanlig for kontinuerlige funksjoner, Manhattan‑avstand summerer absolutte differanser, og cosinus‑avstand fokuserer på retning snarere enn størrelse. Andre mål gjelder for binære, kategoriske, geografiske, sekvens‑ eller innlærte innebyggingsdata.
Å kalle KNN “ikke‑parametrisk” betyr at den ikke antar en fast, endelig‑dimensjonal funksjonsform for beslutningsgrensen. Den forutsetter fortsatt at den valgte representasjonen og målet gjør nærliggende punkter relevante for hverandre.
Hvorfor skalering er viktig
Hvis en funksjon har område fra 0 til 1 og en annen fra 0 til 100 000, vil vanlig euclidisk avstand domineres av den andre funksjonen. Standardisering, normalisering eller domene‑spesifikke transformasjoner bør tilpasses på trenings‑partisjonen og brukes på validerings‑, test‑ og produksjonsdata.
Irrelevante funksjoner forvrenger også nabolag. Funksjonsutvelgelse, dimensjonsreduksjon eller innlærte representasjoner kan hjelpe, men hvert valg må valideres uten datalekkasjer.
Valg av k
Med k = 1 kan modellen følge støy og feilmerkede eksempler. Etter hvert som k øker, blir prediksjonene jevnere og mindre følsomme for enkeltpunkter. Hvis k blir for stor, dominerer fjerne klasser eller regioner og modellen under‑tilpasses.
Velg k gjennom kryss‑validering på treningsdataene. For binær klassifisering reduserer et oddetalls‑k likheter, men eliminerer dem ikke helt. Klassevekter, stratified‑splitt, terskelvalg og passende mål er viktige når klasser er ubalanserte.
Forbannelsen av dimensjonalitet
I høydimensjonale rom kan avstander bli mindre informative fordi eksemplene er spredte og nær‑ og fjerneste avstander blir relativt like. KNN kan kreve enorme mengder data for å opprettholde meningsfulle lokale nabolag. Dette er forbannelsen av dimensjonalitet.
Dimensjonsreduksjon eller oppgavespesifikke innebygginger kan hjelpe, men en innebyggings geometri bør valideres for den tiltenkte likhets‑definisjonen.
Søkeytelse
En brute‑force‑spørring sammenligner det nye punktet med hvert lagret eksempel. KD‑trær og ball‑trær akselererer noen eksakte søk, selv om fordelene avtar i høye dimensjoner. Tilnærmede nærmeste‑nabo‑indekser bytter en liten mengde tilbakekalling for store hastighets‑ og minnegevinster. Dette konseptet ligger også til grunn for vektorsøk etter likhet.
Styrker og begrensninger
KNN er enkel, støtter uregelmessige beslutningsgrenser og gir en intuitiv eksempel‑basert forklaring. Den kan også kreve betydelig minne, eksponere sensitive trenings‑eksempler, forutsi sakte, og oppføre seg dårlig når avstand ikke er meningsfull. Den er et nyttig basislinje‑verktøy — ikke en metode som er svært nøyaktig på de fleste problemer som standard.
Avstand, nabolag og hyperparameter‑oppførsel
K-nærmeste naboer lagrer trenings‑eksemplene og forutsier fra de k nærmeste under et valgt avstandsmål. Klassifisering bruker flertalls‑ eller avstandsvektet stemme; regresjon gjennomsnittlig nabomål. Skalering er essensiell fordi en funksjon med stort område kan dominere den euclidiske avstanden. Kategoriske, sparsomme, sekvens‑ eller geografiske data kan kreve Hamming, cosinus, redigerings‑, stor‑sirkel‑ eller innlærte avstander. Målet er en modellantakelse om likhet, og det bør valideres mot den faktiske betydningen av nærliggende tilfeller.
Liten k skaper fleksible, høy‑varians‑grenser og sensitivitet for støy; stor k jevner prediksjoner og kan fjerne minoritetsstruktur. Oddetalls‑k unngår noen binære likheter, men er ingen generell regel. Velg k, avstand, vektning, funksjonssett og forhåndsbehandling innen kryss‑validering. Klasseubalanse kan få lokalt flertalls‑stemming til å overse sjeldne utfall, så undersøk per‑klasse‑tilbakekalling og nabolags‑sammensetning. I høye dimensjoner konsentrerer avstander seg, og irrelevante funksjoner forringer nabolag; utvelgelse, dimensjonsreduksjon eller innlærte innebygginger kan hjelpe.
Indeksering, usikkerhet og produksjonsdrift
Naiv inferens sammenligner en spørring med hvert treningspunkt. KD‑trær og ball‑trær hjelper i passende lave dimensjoner; tilnærmede nærmeste‑nabo‑indekser bytter nøyaktighet mot hastighet og skala. Mål tilbakekalling av nabosøket separat fra prediksjons‑kvalitet. Minne inkluderer lagrede funksjoner, etiketter og indeks‑strukturer. Oppdateringer er konseptuelt enkle, men kan kreve indeks‑gjenbygging, versjons‑konsistens og sletting‑propagering. Beskytt sensitive trenings‑eksempler fordi retur av naboer eller avstander kan eksponere poster.
KNN kan fremvise eksempler som gjør en prediksjon forståelig, men nærhet er ikke årsak eller rettferdighet. Gi avstand, stemme‑margin og en avvisnings‑regel når nabolag er sparsomt eller i konflikt. Overvåk spørrings‑avstand, naboe‑etiketter, funksjons‑drift, ventetid og bekreftede utfall. Hold forhåndsbehandling og indeks‑versjoner synkronisert, og test eksakte versus tilnærmede resultater etter endringer. KNN er en effektiv lokal basislinje‑ og hente‑metode når avstand er meningsfull; den sliter når likhet ikke kan representeres av tilgjengelige funksjoner.
Arbeidseksempel: KNN for produkters substitusjon
En forhandler representerer produkter med standardiserte numeriske attributter, kategorisk kompatibilitet og en innlært tekst‑innebygging, og definerer en vektet avstand vurdert av vareansvarlige. K og vekter velges ved senere produktlanseringer, ikke tilfeldige vare‑rader. Evaluering sjekker relevant substitutt‑tilbakekalling, inkompatible anbefalinger, avstand, kategoridekning og resultater for sjeldne varer. En popularitets‑basislinje viser om lokal likhet tilfører verdi.
En tilnærmet indeks benchmarkes mot eksakte naboer for tilbakekalling og ventetid. Spørringer uten nærliggende kompatibel vare returnerer ingen forslag i stedet for en tvungen nabo. Produkt‑slettinger og attributt‑korrigeringer propagere til indeksen gjennom versjonerte oppdateringer. Overvåking sporer avstands‑fordelinger, tomme resultater, overstyringer og kommersielle utfall uten å forveksle salg med sann kompatibilitet. Sensitive leverandør‑vilkår ekskluderes fra forklaringer, og returnerte eksempler forblir bevis på likhet — ikke et krav om at produkter er ekvivalente.
Implementeringsbevis og operasjonell beredskap
En produksjons‑beslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, innganger, utganger, avhengigheter, eier og konsekvensene av hver viktig feil. Etabler en reproduserbar basislinje og et versjonert evalueringssett før tuning. Test vanlige tilfeller, grensetilstander, feil‑ eller manglende inndata, distribusjons‑skifte, avhengighets‑nedbrudd, misbruk og de grupper eller miljøer som sannsynligvis blir under‑betjent. Mål oppgavekvalitet sammen med kalibrering eller usikkerhet, ventetid, gjennomstrømning, ressurs‑kostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig vurderer kan reprodusere resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbake‑rulling og pensjonering. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåkning med bevisst injiserte feil. Operasjonell telemetri bør avdekke inndata‑kvalitet, utdata‑atferd, modell‑ eller regel‑versjon, avhengighets‑helse, menneskelige overstyringer og bekreftede utfall uten å samle unødvendige sensitive data. Definer varslings‑terskler og en respons‑eier, og gjennomgå virkelige bevis etter utrulling i stedet for å anta at offline‑ytelse vedvarer. Revurder når datakilder, brukere, modeller, leverandører, retningslinjer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelses‑læring, sletting‑ og oppbevarings‑prosedyrer, samt et klart punkt hvor det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Har KNN en treningsfase?
Den har lite parameter‑tilpasning, men den har fortsatt en utviklingsprosess: forhåndsbehandling læres fra treningsdata, en indeks kan bygges, og k, mål, vekter og funksjoner velges med validering.
Er KNN det samme som K-means?
Nei. KNN er primært en supervisert lokal‑prediksjonsmetode. K-means er en usupervisert klyngingsalgoritme der K er antallet klyngesentre.
Primære referanser












