
Grunnleggende AI
Hva er et datafabric?

 Legg til Unite.AI blant dine foretrukne kilder på Google
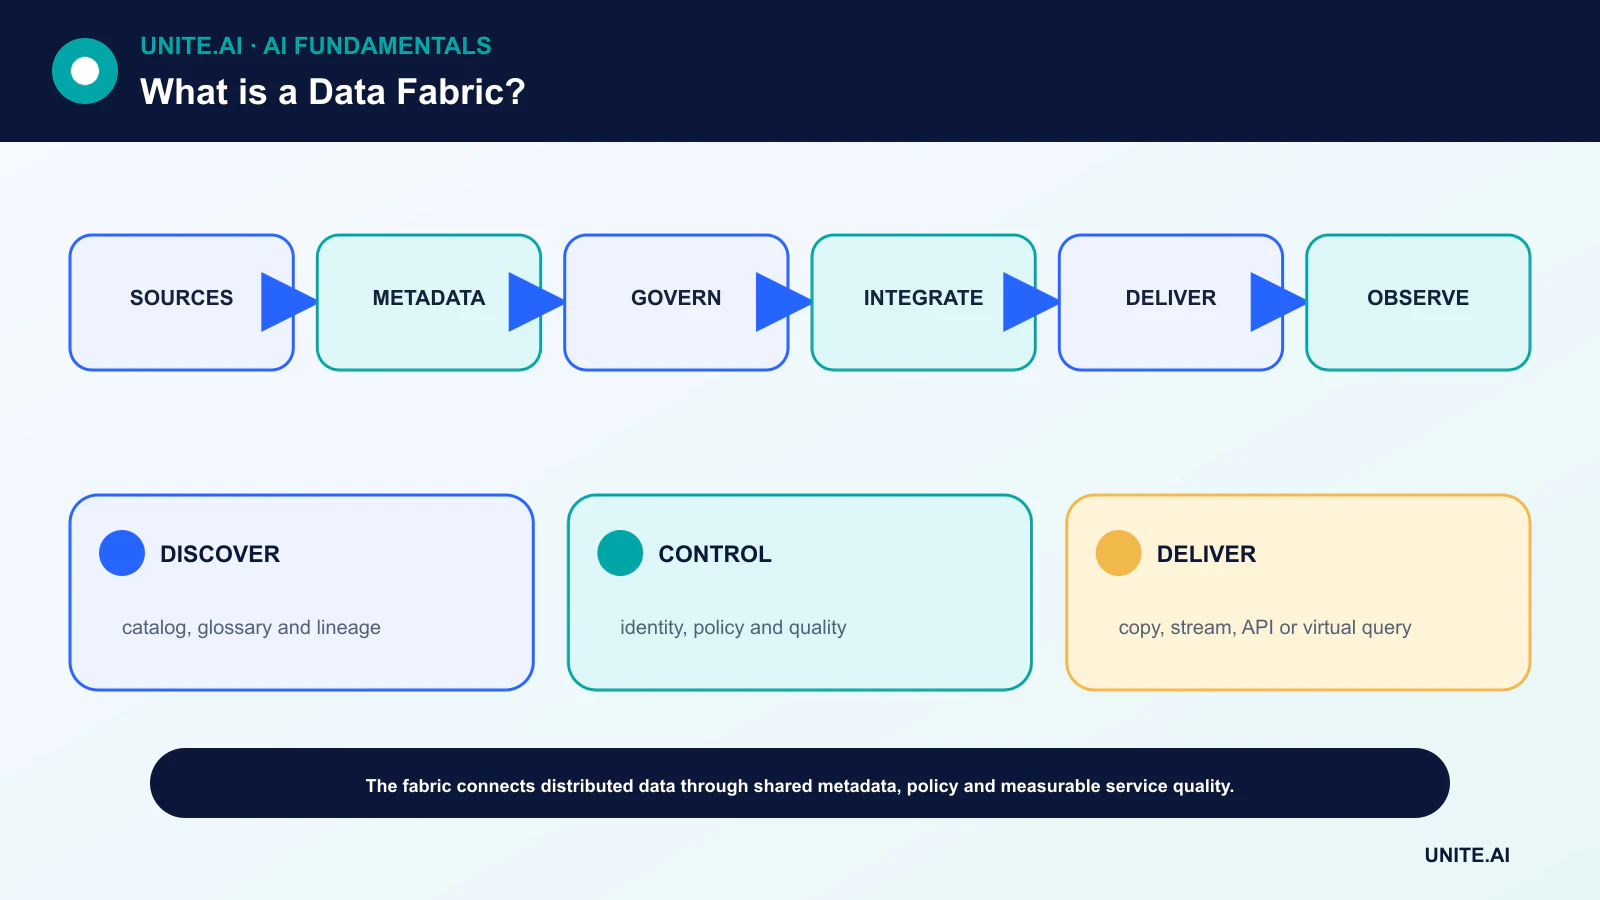
Et data fabric er et arkitekturmønster for å oppdage, koble sammen, styre og levere data på tvers av distribuerte systemer. Det gir et delt metadata‑ og kontroll‑lag slik at mennesker og applikasjoner kan finne pålitelig data uten å tvinge hvert datasett inn i en fysisk lagringsplass.
Et datafabric er ikke ett enkelt produkt, og det fjerner ikke forskjellene mellom kildesystemer. Verdien avhenger av nøyaktig metadata, tydelig eierskap, håndhevbare retningslinjer, pålitelig integrasjon og bevis på at brukerne får data som passer til deres formål.
Viktige punkter
- Et metadata‑rikt kontrollplan kobler kataloger, linjehistorikk, kvalitet, retningslinjer og tilgang.
- Data kan forbli distribuert og kopieres, strømmes, transformeres eller virtualiseres etter arbeidsbelastning.
- Datafabric er teknologifokusert; data mesh legger vekt på domeneeierskap og data‑som‑produkt.
- Automatisering hjelper med å skalere styring, men ansvarlige eiere definerer fortsatt betydning, kvalitet og tillatt bruk.
Kontrollplanet og dataplanet
Dataplanet inneholder databaser, filer, strømmer, API‑er og pipelines som flytter eller spørrer dem. Kontrollplanet registrerer teknisk og forretningsmessig metadata: skjemaer, eiere, klassifiseringer, kvalitetsmålinger, linjehistorikk, retningslinjer og bruk.
En katalog eller kunnskapsgraf kan knytte disse faktaene slik at en bruker kan oppdage et datasett og forstå konteksten. Fabricen bruker deretter metadata til å styre tilgang, transformasjon, observabilitet og håndheving av retningslinjer på tvers av heterogene plattformer.
Integrasjon uten én obligatorisk lagring
Noen arbeidsbelastninger kopierer data via ETL; andre bruker endringsdatafangst, hendelsesstrømmer, API‑er eller spørringsvirtualisering. Det riktige mønsteret avhenger av ferskhet, ytelse, konsistens, suverenitet, kostnad og begrensninger i kildesystemet.
Virtuell tilgang kan redusere duplisering, men kan eksponere brukerne for kilde‑latens og tilgjengelighet. Fysisk materialisering forbedrer ytelse og reproducerbarhet, men skaper synkroniserings‑ og livssyklusansvar.
Styring, semantikk og kvalitet
Et forretningsglossar gir delt betydning til termer som kunde, ordre eller aktiv konto. Linjehistorikk viser hvor et felt oppsto og hvordan det har endret seg. Klassifisering og retningslinjer bestemmer hvem som kan få tilgang til sensitive oppføringer og til hvilket formål.
Kvalitetsregler bør knyttes til konkrete brukstilfeller. Fullstendighet som er tilstrekkelig for et dashbord, kan være usikker for automatiserte beslutninger. En fabric bør vise ferskhet, valideringshistorikk og kjente begrensninger i stedet for kun å merke en ressurs som sertifisert.
Datafabric, mesh og lakehouse
Data mesh er en sosioteknisk tilnærming som gir domeneteam ansvar for interoperable dataprodukter. Et datafabric legger vekt på delte tekniske tjenester og metadata‑automatisering. Organisasjoner kan kombinere dem: domeneeierskap kan operere gjennom en felles fabric.
Et lakehouse kombinerer fleksibiliteten i et datalake med lager‑lignende styring og spørringsfunksjoner. Det kan være én deltakende plattform, men det er ikke hele tverrsystem‑fabricen. På samme måte gir verken et lager eller en katalog alene alle integrasjons‑ og retningslinjefunksjoner.
Implementering og evaluering
Start med et verdifullt tverrsystem‑brukstilfelle og lag en oversikt over de nødvendige kildene, eiere, retningslinjer og tjenestenivå‑forventninger. Etabler identitet, metadata‑standarder, kontrakter, testing og observabilitet før du legger til automatiserte anbefalinger.
Mål oppdagelsestid, godkjenningstid for tilgang, hendelsesrater, dataferskhet, gjenbruk og forbrukertillit. Koble fabricen til styring av strukturerte og ustrukturerte data samt cybersikkerhet; tilkobling uten kontroll kan øke eksponeringen.
Data‑fabric‑arkitektur og metadata‑plan
Et datafabric er en arkitekturtankegang for å koble distribuert data gjennom delt metadata, styring, integrasjon og tilgangstjenester. Det er ikke én database eller ett produkt. Kilder kan forbli i lagre, innsjøer, operasjonelle systemer, strømmer og SaaS‑plattformer mens kataloger beskriver datasett, linjehistorikk sporer transformasjoner, retningslinjer kontrollerer tilgang, og semantiske definisjoner gjør konsepter gjenbrukbare. Virtualisering, replikering, API‑er og pipelines er komplementære leveringsmetoder valgt ut fra latens, skala, kildekapasitet og konsistensbehov.
Aktiv metadata fanger skjemaer, eierskap, bruk, kvalitet, klassifiseringer, linjehistorikk, spørringsmønstre og operasjonelle hendelser og kan drive automatisering. En kunnskapsgraf kan knytte forretningskonsepter til fysiske felter og retningslinjer. Automatisering kan foreslå join‑operasjoner, oppdage driftsavvik, spre klassifiseringer eller rute hendelser, men avledet metadata krever tillit og forvaltning. En katalog som ikke er koblet til levering og kontroll blir dokumentasjonsgjeld; automatisert integrasjon uten semantisk eierskap skaper raskere inkonsistens.
Integrasjon, styring og dataprodukter
Batch‑ETL, endringsdatafangst, strømmer, federasjon og revers‑ETL har ulike ferskhets‑ og feil‑semantikker. Definer autoritative kilder, identifikatorer, kontrakter, hendelsestid, sene data, sletting og avstemming. Virtuelle spørringer unngår kopier, men er avhengige av kilde‑ytelse og tilgjengelighet; materialisering forbedrer hastighet, men skaper forpliktelser knyttet til ferskhet og lagring. Sensitive retningslinjer må følges eller revurderes for avledet data, cache‑lagring, innebygde representasjoner og eksport.
Behandle høyt verdsatte datasett som produkter med eiere, brukere, dokumentasjon, tjeneste‑forventninger, tester og støtte. Federert eierskap lar domener håndtere betydning mens delte standarder bevarer interoperabilitet. Sentralteam leverer plattform‑kapabiliteter og styring, ikke eierskap til hvert felt. Mål oppdagelsestid, gjenbruk, datakvalitet, tilgangs‑lead‑time, hendelsesløsing, adopsjon av pålitelige måleparametre og kostnad. Antallet katalogposter eller koblinger er ikke bevis på at folk kan finne og bruke pålitelig data.
Implementasjonsstrategi
Start med én tverrdomenereise der forsinkelser og risikoer er kjente. Lag en oversikt over kilder og kontrakter, etabler identitet og klassifisering, koble linjehistorikk og kvalitet, og automatiser gjentatte kontroller. Unngå et flerårig forsøk på å modellere hele virksomheten før du leverer verdi. Test kilde‑nedetid, skjemaendring, tilbakekalt tilgang, sene hendelser og katastrofegjenoppretting. Et datafabric lykkes når distribuert data blir enklere å styre og bruke uten å fjerne de operative realitetene og ansvarlighetene til systemene der den oppstår.
Arbeidseksempel: et kunde‑datafabric
Et selskap kobler sammen handel, support, markedsføring og produktdata mens de operasjonelle systemene forblir autoritative. En delt katalog knytter kunde-, konto‑, ordre‑, samtykke‑ og interaksjonsdefinisjoner til fysiske felter. Endringsdatafangst leverer styrte produkter, mens virtualisering betjener lavvolum‑spørringer i sanntid og materialiserte tabeller støtter analyser. Identitet, linjehistorikk, kvalitet og retningslinjer er implementert før et AI‑personliggjøringslag får bruke dataene.
Et trekk‑til‑bakside‑samtykke spres gjennom lager‑tabeller, søke‑indekser, innebygde representasjoner og aktiveringssystemer, med bevis på fullføring. Skjema‑kontrakter og avstemmings‑tester oppdager kildeendringer. Eiere publiserer forventninger til ferskhet og kvalitet, og bruks‑metadata hjelper med å avvikle ubrukte kopier. Piloten måler tilgangs‑lead‑time, gjenbruk av pålitelige måleparametre, hendelsesløsing og personvern‑etterlevelse. Fabricen anses som vellykket fordi én tverrdomenereise blir pålitelig og styrbar – ikke fordi en leverandør koblet det største antallet kilder.
Implementeringsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, inn‑ og utdata, avhengigheter, eier og konsekvensene av hver viktig feil. Etabler en reproduserbar basislinje og et versjonert evalueringssett før finjustering. Test vanlige tilfeller, grensetilstander, feil‑ eller manglende inndata, distribusjons‑skifte, avhengighets‑nedetid, misbruk og de grupper eller miljøer som mest sannsynlig blir underbetjent. Mål oppgavekvalitet sammen med kalibrering eller usikkerhet, latens, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig revisor kan gjenskape resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, behold en sikker fallback, og verifiser overvåkning med bevisst innsprøytede feil. Operasjonell telemetri bør avdekke inndata‑kvalitet, utdata‑adferd, modell‑ eller regelversjon, avhengighets‑helse, menneskelige overstyringer og bekreftede resultater uten å samle unødvendige sensitive data. Definer varslings‑terskler og en respons‑eier, og gjennomgå virkelige bevis etter distribusjon i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, retningslinjer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelses‑læring, sletting‑ og lagrings‑prosedyrer, samt et tydelig tidspunkt for når det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Flytter et datafabric all data til ett sted?
Nei. Det kan koordinere data som forblir distribuert og velge fysisk flytting eller virtualisering per arbeidsbelastning.
Er et datafabric det samme som et data mesh?
Nei. Fabric beskriver primært muliggjørende arkitektur og automatisering; mesh beskriver primært desentralisert domeneeierskap og ansvar for dataprodukter. De kan eksistere side om side.
Primære referanser











