Andersons vinkel
Slik vet du om bildesyntesesystemer lager virkelig originalt materiale

 Legg til Unite.AI blant dine foretrukne kilder på Google

Viktige punkterKAIST og NAVERs sjeldenhetspoeng måler bildeoriginalitet via nærmeste nabo-avstander.
Vis mer
- KAIST og NAVERs sjeldenhetspoeng måler bildeoriginalitet via nærmeste nabo-avstander.
- Eksisterende målinger som avkortningstrikset favoriserer autentisitet fremfor nyhet i genererte bilder.
- Sjeldenhetspoenget kan identifisere virkelig oppfinnsomme resultater fra systemer som DALL-E 2.
En ny sørkoreansk studie foreslår en metode for å avgjøre om bildesyntesesystemer lager virkelig nye bilder eller bare små varianter av treningsdataene. Det siste kan undergrave målet med slike arkitekturer: å skape nye og originale bilder.
Ifølge artikkelen er det siste svært ofte tilfellet, fordi eksisterende mål som skal forbedre genereringsevnen under treningen, favoriserer bilder som ligger relativt nær de ekte kildebildene i datasettet.
Et bilde som ligner visuelt på kildedataene, vil gjerne få bedre poeng for autentisitet enn originalitet: det er tro mot kilden, om enn lite oppfinnsomt.
I en sektor som er for ung og uprøvd til at de juridiske følgene er kjent, kan dette bli et viktig juridisk spørsmål dersom kommersialisert syntetisk bildemateriale ikke skiller seg nok fra ofte opphavsrettslig beskyttet kildemateriale som nå får gjennomsyre forskningen gjennom populære datasett samlet inn fra nettet. Muligheten for fremtidige krenkelseskrav av denne typen har nylig fått oppmerksomhet i forbindelse med Microsofts GitHub Co-Pilot AI.
Til tross for stadig mer sammenhengende og semantisk solide resultater fra systemer som OpenAIs DALL-E 2, Googles Imagen og kinesiske CogView samt den mindre avanserte DALL-E mini, finnes det svært få pålitelige måter å teste originaliteten i etterkant.
Søk etter noen av de mest populære nye DALL-E 2-bildene fører ofte bare til flere kopier av de samme bildene, avhengig av søkemotoren.

Opplasting av en hel gruppe med ni DALL-E 2-bilder fører bare til flere slike grupper, fordi rutenettet er det sterkeste kjennetegnet. Når det første bildet skilles ut og lastes opp fra dette Twitter-innlegget fra 8. juni 2022 på kontoen Weird Dall-E Generations, låser Google seg til basketballen og sender bildesøket inn i en semantisk blindgate. For samme bilde ser Yandex i det minste ut til å analysere pikslene og sammenligne faktiske bildeegenskaper.
Yandex bruker oftere enn Google Search de faktiske egenskapene ved et bilde, altså avledede eller beregnede kjennetegn og ikke nødvendigvis menneskers ansiktstrekk, og visuelle fremfor semantiske egenskaper for å finne lignende bilder. Alle bildesøkemotorer har likevel en eller annen målsetting eller praksis som kan gjøre det vanskelig å avdekke plagiat av typen kilde>generert gjennom nettsøk.
Treningsdataene til en generativ modell er dessuten kanskje ikke offentlig tilgjengelige i sin helhet, noe som ytterligere hemmer den forensiske undersøkelsen av originaliteten.
Et bildesøk på et av de syntetiske bildene Google viser på Imagen-nettstedet finner interessant nok ingenting sammenlignbart med motivet når man vurderer selve bildet og søker upartisk etter lignende bilder. Google Images er fortsatt semantisk fastlåst og tillater ikke et rent bildesøk uten at ordene imagen google legges til som en ekstra, begrensende parameter:

Yandex finner derimot mange lignende, eller i det minste visuelt beslektede, virkelige bilder fra amatørkunstmiljøet:

Det ville vært bedre om nyheten eller originaliteten til bildesyntesens resultater kunne måles uten å hente ut egenskaper fra alle mulige nettbilder på treningstidspunktet, eller fra lukkede datasett som kan bruke opphavsrettslig beskyttet materiale.
Forskere ved Kim Jaechul Graduate School of AI på Korea Advanced Institute of Science and Technology (KAIST AI) har derfor samarbeidet med det globale IKT- og søkeselskapet NAVER Corp om en sjeldenhetsskår (Rarity Score) som kan identifisere mer originale resultater fra bildesyntesesystemer.

Bildene er laget med StyleGAN-FFHQ. Kolonnene går fra dårligst til best fra venstre mot høyre. Truncation trick og Realism har egne målsettinger, mens den nye sjeldenhetsskåren øverst søker sammenhengende, men originale bilder fremfor bare sammenhengende bilder. På grunn av artikkelens begrensede bildestørrelser viser originalstudien flere detaljer og høyere oppløsning. Kilde: https://arxiv.org/pdf/2206.08549.pdf
Den nye studien heter Rarity Score: A New Metric to Evaluate the Uncommonness of Synthesized Images (Sjeldenhetsskår: et nytt mål på hvor uvanlige syntetiske bilder er) og er skrevet av tre forskere fra KAIST og tre fra NAVER Corp.
Forbi det billige trikset
Blant tidligere mål den nye studien vil forbedre, er Truncation trick, som ble foreslått i 2019 i et samarbeid mellom britiske Heriot-Watt University og Googles DeepMind.
Truncation trick bruker en annen latent fordeling til utvalg enn den som ble brukt til å trene den generative modellen.
Utviklerne var overrasket over at metoden fungerte, men innrømmer at den reduserer variasjonen i resultatene. Likevel er den blitt effektiv og populær som et slags billig triks for å få autentisk utseende resultater. Disse tar ikke opp i seg alle mulighetene i dataene og kan ligne kilden mer enn ønskelig.
Forfatterne av den nye studien sier:
«Metoden er ikke ment å lage sjeldne prøver i treningsdatasett, men å syntetisere typiske bilder mer stabilt. Vi antar at eksisterende generative modeller kan produsere prøver som dekker den virkelige datafordelingen rikere, dersom generatoren kan fås til å lage sjeldne prøver effektivt.»
Om tendensen til å bruke tradisjonelle mål som Frechet Inception Distance (FID), som ble kraftig kritisert i desember 2021, Inception Score (IS) og Kernel Inception Distance (KID) som fremdriftsmål under treningen, kommenterer forfatterne videre*:
«Denne læringsordningen får generatoren til å lage få sjeldne prøver som er unike og har sterke kjennetegn, men som utgjør en liten del av den virkelige bildefordelingen. Eksempler fra offentlige datasett er mennesker med ulike tilbehør i FFHQ, hvite dyr i AFHQ og uvanlige statuer i Metfaces.
«Evnen til å lage sjeldne prøver er viktig både fordi den gjelder grensene for generative modellers kapasitet, og fordi unikhet er sentralt i kreative bruksområder som virtuelle mennesker.
«Kvalitative resultater fra flere nyere studier inneholder likevel sjelden slike eksempler. Vi antar at adversariell læring tvinger de genererte bildenes fordeling til å ligne treningsdatasettets. Derfor utgjør tydelig individuelle eller sjeldne bilder bare en liten del av modellenes resultater.»
Teknikk
Den nye sjeldenhetsskåren tilpasser en idé fra tidligere arbeider: bruk av K nærmeste naboer (KNN) for å representere samlingene av ekte treningsdata og syntetiske resultater i et bildesyntesesystem.
Forfatterne beskriver analysemetoden slik:
«Vi antar at vanlige prøver ligger nær hverandre, mens unike og sjeldne prøver ligger spredt i egenskapsrommet.»
Resultatbildet over viser avstandene til nærmeste nabo (NND) fra minst til størst i en StyleGAN-arkitektur trent på FFHQ.
«For alle datasett viser prøvene med minst NND representative og typiske bilder. Prøvene med størst NND har derimot sterk individualitet og skiller seg vesentlig fra de typiske bildene med minst NND.»
Teoretisk kan målet brukes som diskriminator eller inngå i en mer kompleks diskriminatorarkitektur og styre systemet fra ren etterligning til en mer oppfinnsom algoritme. Samtidig kan det beholde sammenhengen i begreper som er viktige for autentisk bildeskaping, som mann, kvinne, bil, kirke og så videre.
Sammenligninger og forsøk
Forskerne sammenlignet sjeldenhetsskåren med Truncation trick og NVIDIAs Realism Score fra 2019. På tvers av flere rammeverk og datasett klarte tilnærmingen å skille ut unike resultater.
Studiens resultater er for omfattende til å gjengis her, men forskerne ser ut til å ha vist at metoden finner sjeldenhet i både ekte kildebilder og genererte bilder:
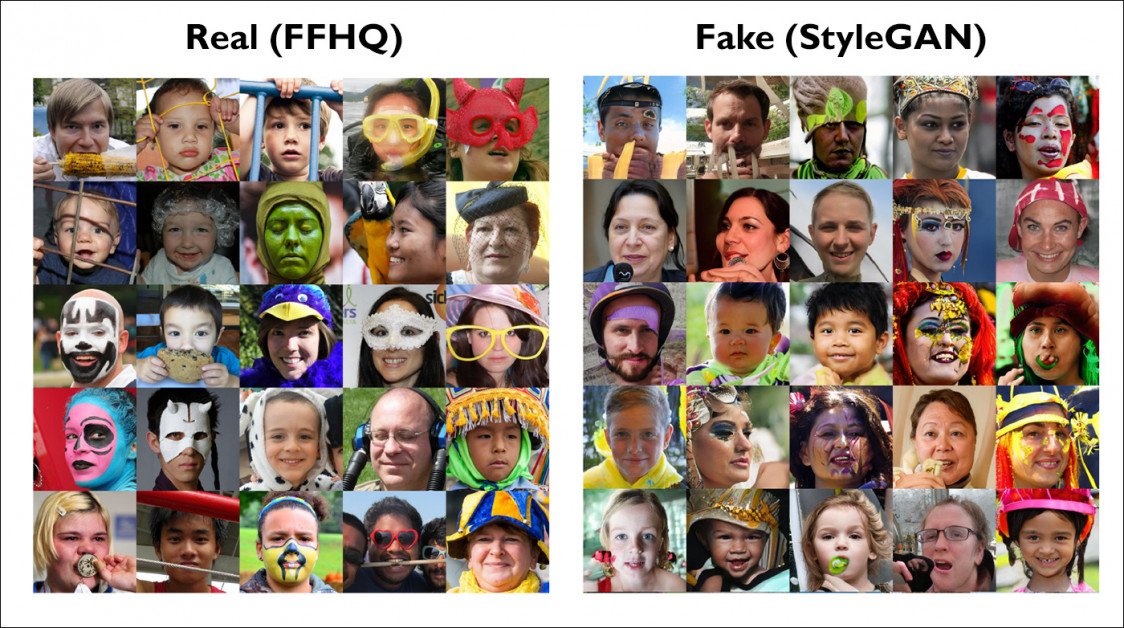
Utvalgte eksempler fra studiens omfattende bilderesultater; se kilden over for detaljer. Til venstre er ekte FFHQ-eksempler med få nære naboer i originaldatasettet, altså nye og uvanlige. Til høyre er StyleGAN-genererte bilder som det nye målet har identifisert som virkelig nye. På grunn av artikkelens begrensede bildestørrelser viser originalstudien flere detaljer og høyere oppløsning.
Forskerne hevder at sjeldenhetsskåren ikke bare kan identifisere nye resultater i én arkitektur, men også sammenligne generative modeller med forskjellige arkitekturer, som autoenkodere, VAE og GAN.
Studien sier at målet skiller seg fra eldre mål ved å vektlegge evnen til å lage unike og sjeldne bilder. Tradisjonelle mål undersøker mer snevert variasjonen mellom resultatene under treningen.
Utover begrensede oppgaver
Forsøkene gjaldt begrensede domener, som generator- og datasettkombinasjoner for menneske- eller kattebilder. Sjeldenhetsskåren kan likevel potensielt brukes i enhver bildesyntese der man vil identifisere resultater som utnytter fordelingene fra treningsdataene. Dette er et alternativ til å øke autentisitet og redusere variasjon med fremmede latente fordelinger eller andre snarveier som ofrer nyhet for autentisitet.
Målet kan dermed skille ut virkelig nye resultater i systemer som DALL-E-serien ved å bruke avstanden mellom et tilsynelatende avvikende resultat, treningsdata og resultater fra lignende instruksjoner eller innganger, også bildebaserte instruksjoner.
I praksis vet vi ikke klart hvor godt systemet virkelig har tilegnet seg visuelle og semantiske begreper, ofte fordi kunnskapen om treningsdataene er begrenset. Metoden kan likevel avdekke et ekte inspirasjonsøyeblikk: punktet der nok inngangsbegreper og data skaper noe virkelig oppfinnsomt fremfor noe for avledet eller nær kildedataene.
* Jeg har gjort forfatternes referanser i løpende tekst om til hyperlenker.
Først publisert 20. juni 2022.