
Grunnleggende AI
Hva er datamaskinsyn?

 Legg til Unite.AI blant dine foretrukne kilder på Google
Datamaskinsyn er fagområdet som bygger systemer som trekker ut nyttig informasjon fra bilder og video. En visjonsmodell kan klassifisere et helt bilde, lokalisere objekter, merke hver piksel, lese tekst, estimere posering, spore bevegelse, eller knytte visuelt innhold til språk.
Moderne visjonssystemer gjenskaper ikke bare den tidlige kantdeteksjonsprosessen i menneskelig persepsjon. De lærer oppgavespesifikke representasjoner fra data, ofte ved bruk av konvolusjonsnevrale nettverk, visjonstransformatorer eller multimodale grunnleggende modeller.
Viktige punkter
- Klassifisering, deteksjon, segmentering, OCR, sporing og generering er ulike visjonsoppgaver.
- CNN-er innlemmer lokalitet og vektdeling; visjonstransformatorer bruker oppmerksomhet på tvers av bilde‑lapper.
- Etiketter kan komme fra mennesker, svak overvåking, syntetiske data eller selv‑overvåkede mål.
- Kun nøyaktighet er utilstrekkelig: robusthet, latens, personvern, skjevhet og kostnader ved feil er viktige.
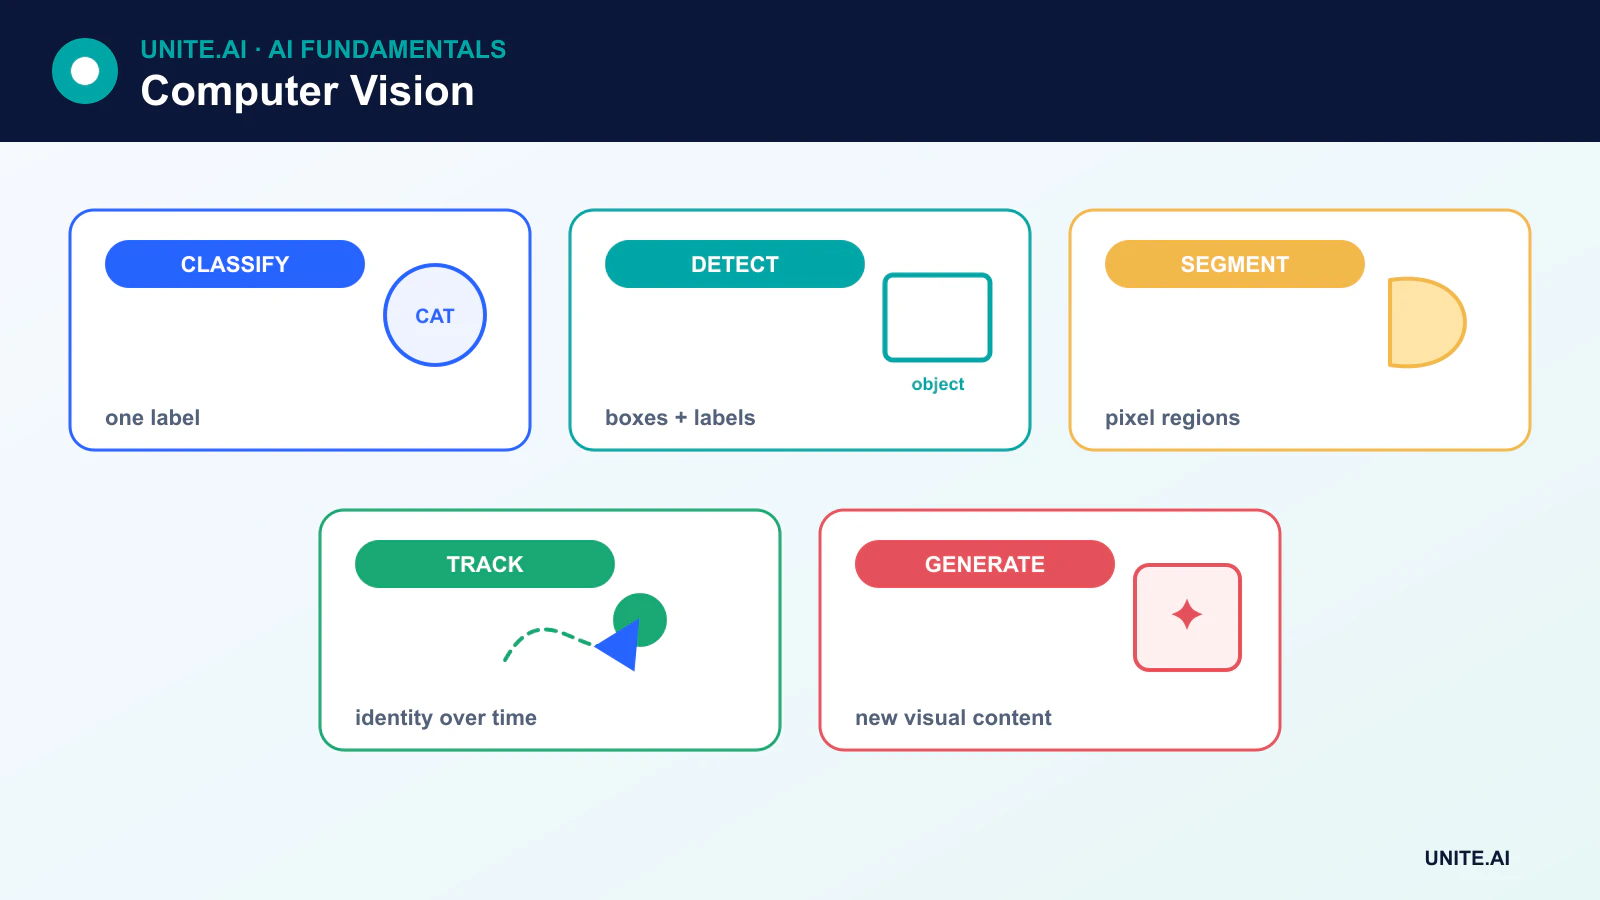
De viktigste oppgavene innen datamaskinsyn
- Bildeklassifisering tilordner ett eller flere etiketter til et bilde. Se hvordan bildeklassifisering fungerer.
- Objektdeteksjon forutsier kategorier og avgrensningsbokser for flere objekter.
- Semantisk segmentering merker hver piksel etter klasse, mens instanssegmentering skiller individuelle objekter.
- Optisk tegngjenkjenning (OCR) oppdager og transkriberer tekst.
- Poseringsestimering forutsier kropp‑ eller objektlandemerker.
- Sporing knytter deteksjoner på tvers av videorammer.
- Bildegenerering og -redigering produserer eller transformerer visuelt innhold, ofte ved bruk av diffusjonsmodeller.
Hvordan bilder blir modellens innganger
Et digitalt bilde er allerede numeriske data: en tensor som inneholder pikselverdier over romlige dimensjoner og kanaler. Forbehandling kan endre størrelse, normalisere, beskjære eller augmentere bildet. Video legger til en tidsdimensjon, mens medisinsk og vitenskapelig avbildning kan legge til dybde, bølgelengde eller andre modaliteter.
Klassisk datamaskinsyn brukte håndlagde kant-, hjørne‑ og tekstur‑funksjoner. Moderne dype modeller lærer vanligvis funksjonene sammen med oppgaven, selv om klassiske metoder fortsatt er nyttige når data er begrenset, regler er godt forstått, eller beregning må holdes minimal.
CNN-er og lærte lokale funksjoner
Et CNN anvender lærte kjerner over lokale nabolag. Tidlige lag kan reagere på lokale mønstre, mens senere blokker kombinerer dem til oppgave‑relevante representasjoner. Pooling‑ eller stride‑operasjoner reduserer romlig oppløsning, og residual‑forbindelser gjør dype nettverk enklere å optimalisere.
En moderne CNN‑klassifikator bruker ofte global pooling i stedet for en stor stabel av fullt tilkoblede lag. Detektorer og segmenteringsnettverk legger til spesialiserte hoder eller dekoder‑stier som bevarer romlig informasjon.
Visjonstransformatorer og grunnleggende modeller
En visjonstransformer deler et bilde inn i lapper, embedder dem, og bruker oppmerksomhet til å modellere deres relasjoner. Transformere kan skaleres effektivt med store datasett og forhåndstrening, mens CNN‑er ofte gir sterkere innebygde antakelser og effektivitet i mindre skalaer.
Multimodale modeller justerer bilder med tekst slik at brukere kan søke, legge til bildetekster, svare på spørsmål, eller veilede segmentering ved hjelp av språk. Disse modellene utvider mulighetene, men arver også svakheter fra bred web‑skala data, inkludert stereotypier, opphavsrettsbeskyttet materiale og ujevn dekning av befolkninger og miljøer.
Etiketter, selv‑overvåking og syntetiske data
Avgrensningsbokser, masker, landemerker og bildetekster kan være kostbare å lage. Selv‑overvåket læring utleder mål fra bildene selv, mens svak overvåking bruker støyende eller indirekte etiketter. Syntetiske data kan tilføre sjeldne scenarier, men simuleringsgap kan hindre at syntetisk ytelse overføres til den virkelige verden.
Annotasjonskvalitet må måles. Tvetydige etiketter, inkonsistente grenser og manglende objekter setter en tak på ytelsen og kan skjule feil i undergrupper.
Hvordan visjonssystemer evalueres
Klassifisering bruker måleverdier som nøyaktighet, presisjon, tilbakekalling, F1 og kalibrering. Deteksjon bruker vanligvis intersection over union og gjennomsnittlig presisjon. Segmentering bruker intersection over union eller Dice‑lignende mål. Sporing legger til identitets‑ og trajektori‑metrikker.
Måleverdien må tilpasses utrullingen. En modell kan oppnå gode resultater på et kuratert benchmark og likevel mislykkes i regn, svakt lys, uvanlige kameravinkler, nye enheter eller ukjente befolkninger. Evaluering bør inkludere distribusjons‑skift, adversarielle forhold og operasjonell latens.
Personvern, skjevhet og utrulling
Ansikter, kjøretøyregistreringsskilt, boliger, medisinske skanninger og video fra arbeidsplassen kan avsløre sensitiv informasjon. Innsamling og lagring bør følge et definert juridisk og etisk grunnlag, med tilgangskontroller og dataminimering. Ansiktsanalyse og biometrisk identifikasjon krever spesiell gransking fordi feil og overvåkning kan påføre ulik skade.
Edge‑utrulling kan redusere latens og datatransfer. Edge AI, kvantisering, beskjæring og spesialiserte akseleratorer kan gjøre visjonssystemer praktiske på kameraer, kjøretøy, roboter og mobile enheter, men komprimering må revurderes med hensyn til nøyaktighet og skjevhet.
Fra piksler til visuelle oppgaver
Datamaskinsyn gjør bilder eller video om til oppgave‑utganger som klassifisering, deteksjon, segmentering, sporing, posering, dybde, optisk flyt eller tekstgjenkjenning. Oppgavedefinisjonen bestemmer annoteringen: en bildetikett kan ikke trene presis lokalisering, og en avgrensningsboks kan ikke fullt beskrive en segmenteringsmaske. Kamerageometri, linser, eksponering, belysning, bevegelse, komprimering og synsvinkel former datasfordelingen. Definer driftsmiljøet og konsekvensene av feil før du velger en modell, fordi en benchmark‑bildesamling kanskje ikke representerer den implementerte sensoren eller scenen.
En pipeline dekoder og orienterer media, endrer størrelse eller fliser den, normaliserer verdier, anvender etikett‑bevarende augmentering, kjører en modell, og etterbehandler logitter, bokser, masker eller spor. Objektdetektorer bruker konfidens‑terskler og undertrykkelse; sporere knytter deteksjoner over tid; segmentering kan kreve morfologisk opprydding. Bevar koordinattransformasjoner slik at utdataene stemmer overens med originalbildet. Del data etter person, kamera, lokasjon eller opptaksøkt for å unngå nesten identiske rammer i både trenings‑ og testsett.
Evaluering, skjevhet, personvern og drift
Måleverdier må tilpasses oppgaven og bruken. Klassifisering trenger klasse‑spesifikk presisjon og tilbakekalling; deteksjon bruker intersection‑over‑union og gjennomsnittlig presisjon over terskler; segmentering bruker IoU eller Dice; sporing legger til identitetsbytter; latens og varighet av tapte hendelser er viktig for video. Rapporter resultater etter belysning, avstand, enhet, okklusjon, hudtone, alder og andre relevante forhold. Inspiser kalibrering og feil med høy konfidens. Syntetiske eller augmenterte data kan fylle hull, men krever sammenligning med reelle driftsdata og må ikke lekke test‑scener.
Visjon kan samle tilskuere, lokasjoner, biometrikk og sensitiv atferd. Minimer opptak og lagring, sikre strømmer, begrens sekundær bruk, og gi varsel eller samtykke der det kreves. Test adversarielle lapper, gjenspilling, okklusjon, kamerafeil og domeneskift. Overvåk sensorhelse, inndata‑statistikk, utdata‑hastigheter og bekreftede resultater; behold menneskelig gjennomgang for beslutninger med konsekvenser. Usynliggjøring eller beskjæring kan redusere eksponering, men kan også fjerne bevis. En høy laboratoriescore rettferdiggjør ikke påstander om identitet, følelser eller intensjon utover den validerte oppgaven.
Arbeidseksempel: fotgjengerdeteksjon ved en lagerkryssing
Kameraer overvåker en begrenset kjøretøyskryssing, og modellen oppdager personer uten å identifisere dem. Data dekker dag og natt, vær, klær, okklusjon, rullestolbrukere, kameraposisjoner og tomme scener, delt etter opptaksøkt. Detektoren evalueres for hendelses‑tilbakekalling, falske alarmer, lokalisering, advarselens ledetid og ytelse på avstand. Sikkerhetsingeniørfaget definerer maksimal tolerert latens og uavhengige fysiske kontroller.
Visjonsalarmen kan bremse et kjøretøy, men nødstopper og barrierer er ikke avhengige av den lærte modellen. Kameraobstruksjon, frosne rammer, nettverkstap og modell‑timeout gir eksplisitte feil. Råvideo‑lagring minimeres og tilgang loggføres. Overvåkning sporer sensorhelse, alarmrater, gjennomgåtte hendelser og nesten‑ulykker etter forhold. Enhver flytting av kamera eller endring av oppsett utløser re‑validering fordi tilsynelatende bildelikhet ikke garanterer samme geometri eller risiko.
Implementeringsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, innganger, utganger, avhengigheter, eier, og konsekvensen av hver viktig feil. Etabler en reproduserbar basislinje og et versjonert evalueringssett før justering. Test vanlige tilfeller, grensetilstander, feilformet eller manglende inngang, distribusjons‑skift, avhengighets‑nedbrudd, misbruk, og gruppene eller miljøene som mest sannsynlig blir underbetjent. Mål oppgavekvalitet sammen med kalibrering eller usikkerhet, latens, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig vurderer kan reprodusere resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåkning med bevisst injiserte feil. Operasjonell telemetri bør avdekke inndata‑kvalitet, utdata‑adferd, modell‑ eller regelversjon, avhengighets‑helse, menneskelige overstyringer og bekreftede resultater uten å samle unødvendig sensitiv data. Definer alarm‑terskler og en ansvarlig for respons, og gjennomgå virkelige bevis etter utrulling i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, retningslinjer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelses‑læring, slettings‑ og lagringsprosedyrer, og et klart punkt hvor det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Er datamaskinsyn det samme som bildegjenkjenning?
Nei. Bildegjenkjenning refererer vanligvis til klassifisering eller identifikasjon. Datamaskinsyn inkluderer også lokalisering, segmentering, måling, sporing, rekonstruksjon, generering og resonnering over visuell informasjon.
Ser et visjonssystem som et menneske?
Nei. En modell behandler numeriske innganger i henhold til sin arkitektur og treningsmål. Den kan overgå mennesker på et smalt benchmark, men mislykkes ved små endringer som en person håndterer enkelt.
Primære referanser












