
Andersons vinkel
Å bringe visuelle analogier til AI

 Legg til Unite.AI blant dine foretrukne kilder på Google
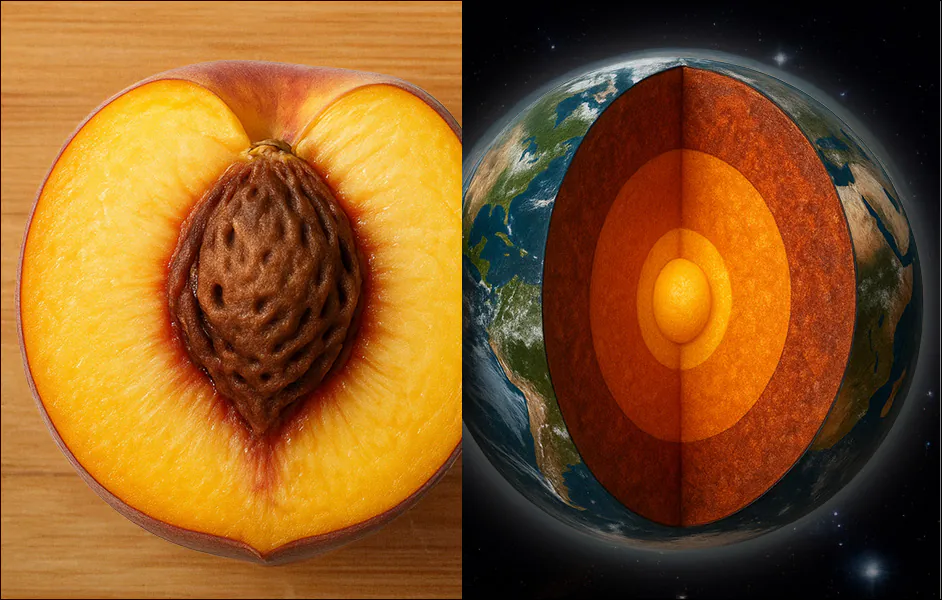
De nåværende AI-modellene klarer ikke å gjenkjenne ‘relasjonelle’ billedlikheter, slik som hvordan jordens lag er lik en fersken, og mangler en nøkkelaspekt av hvordan mennesker oppfatter bilder.
Selv om det finnes mange datamaskin-synsmodeller som kan sammenligne bilder og finne likheter mellom dem, har den nåværende generasjonen av sammenligningssystemer lite eller ingen fantasifull kapasitet. Overveur noen av tekstene i den klassiske 1960-talls-sangen, Vindmøller i ditt sinn:
Like en karusell som snurrer, løper ringer rundt månen
Like en klokke hvis hender sveiper forbi minuttene på dens ansikt
Og verden er som et eple som snurrer stille i rommet
Slike sammenligninger representerer et domene av poetisk allusjon som er meningsfullt for mennesker på en måte langt utenfor kunstnerisk uttrykk; snarere er det knyttet til hvordan vi utvikler våre perseptuelle systemer; når vi skaper vårt ‘objekt’-domene, utvikler vi en kapasitet for visuell likhet, så at – for eksempel – tverrsnitt som viser en fersken og jorden, eller fraktale rekurrenser som kaffespiraler og galaksegrener, registrerer som analoge hos oss.
På denne måten kan vi slutte oss til sammenhenger mellom åpenbart uavhengige objekter og objektyper, og slutte oss til systemer (slik som tyngdekraft, bevegelsesmengde og overfladekohesjon) som kan gjelde for en rekke domener på en rekke nivåer.
Å se ting
Selv de nyeste generasjonen av bilde-sammenligningssystemer, slik som Learned Perceptual Image Patch Similarity (LPIPS) og DINO, som er informert av menneskelig tilbakemelding, utfører bare bokstavelige overflatesammenligninger.
Deres evne til å finne ansikter der ingen finnes – dvs. pareidolia – representerer ikke den type visuell likhetsmekanismer som mennesker utvikler, men skjer fordi ansiktsøk-algoritmer bruker lavnivå ansiktsstruktur egenskaper som noen ganger stemmer overens med tilfeldige objekter:

Eksempler på feilpositive for ansiktsgjenkjenning i ‘Faces with Things’-datasettet. Kilde
For å bestemme om maskiner virkelig kan utvikle vår fantasifull kapasitet til å gjenkjenne visuell likhet over domener, har forskere i USA utført en studie om relasjonell visuell likhet, og har kuratert og trent et nytt datasett som er designet for å tvinge abstrakte relasjoner til å danne seg mellom forskjellige objekter som likevel er bundet sammen av en abstrakt relasjon:

De fleste AI-modellene gjenkjenner bare likhet når bilder deler overfladetrek som form eller farge, og det er derfor de bare kobler gruppe B (ovenfor) til referansen. Mennesker, derimot, ser også gruppe A som lik – ikke fordi bildene ligner hverandre, men fordi de følger samme underliggende logikk, slik som å vise en transformasjon over tid. Det nye arbeidet forsøker å gjenskape denne type strukturell eller relasjonell likhet, med mål om å bringe maskinpersepsjon nærmere menneskelig resonnering. Kilde: https://arxiv.org/pdf/2512.07833
Kapionsystemet som er utviklet for datasettet muliggjør usedvanlig abstrakte annotasjoner, designet for å tvinge AI-systemer til å fokusere på grunnleggende egenskaper i stedet for spesifikke lokale detaljer:

De forutsagte ‘anonyme’ kapionsene som bidrar til forfatternes ‘relsim’-metrikk.
Det kuraterte samlingen og den usedvanlige kapionsstilen driver forfatternes nye foreslåtte metrikk relsim, som forfatterne har finjustert inn i en visjon-språkmodell (VLM).

En sammenligning mellom kapionsstilen i typiske datasett, som fokuserer på attributtlikhet, mens relsim-tilnærmingen (nederste rad) betoner relasjonell likhet.
Den nye tilnærmingen bygger på metoder fra kognitiv vitenskap, spesielt Dedre Gentners Struktur-Mapping-teori (en studie av analogi) og Amos Tverskys definisjon av relasjonell likhet og attributtlikhet.

Fra det tilknyttede prosjektets nettsted, et eksempel på relasjonell likhet. Kilde
Forfatterne slår fast:
‘[Mennesker] prosesserer attributtlikhet perseptuelt, men relasjonell likhet krever konseptuell abstraksjon, ofte støttet av språk eller forhåndsviten. Dette antyder at gjenkjenning av relasjonell likhet først krever å forstå bildet, å trekke på kunnskap og å abstrahere dets underliggende struktur.’
Den nye artikkelen heter Relasjonell visuell likhet, og kommer med et prosjektnettsted (se video innlemmet i slutten av denne artikkelen).
Metode
Forskerne brukte ett av de best kjente hyperskale-datasettene som utgangspunkt for sin egen samling – LAION-2B:

Metadata for en innføring i LAION-2B-samlingen. Kilde
114 000 bilder som sannsynligvis inneholder elastiske relasjonelle strukturer, ble trukket ut fra LAION-2B, inkludert filtrering av de mange lavkvalitetsbildene som er til stede i det minimalt kuraterte datasettet.
For å lage en pipeline for denne valgprosessen, brukte forfatterne Qwen2.5-VL-7B, og utnyttet 1 300 positive og 11 000 negative menneske-merkede eksempler:

RelSim-systemet er trent i tre faser: filtrering av bilder fra LAION-2B for relasjonell innhold; tildeling av hver gruppe en felles anonym kapion som fanger deres underliggende logikk; og læring av å matche bilder til disse kapionene ved hjelp av en kontrastiv tap.
Artikkelen slår fast:
‘Annotatorer ble instruert: “Kan du se noen relasjonell mønster, logikk eller struktur i dette bildet som kunne være nyttig for å lage eller koble til et annet bilde?”. Den finjusterte modellen oppnår 93% enighet med menneskelige vurderinger, og når den blir brukt på LAION-2B, resulterer det i N = 114k bilder som er identifisert som relasjonelt interessante.’
For å generere relasjonelle merker, ble Qwen-modellen bedt om å beskrive den felles logikken bak sett av bilder uten å navngi spesifikke objekter. Denne abstraksjonen var vanskelig å oppnå når modellen så bare ett bilde, men ble mulig når flere eksempler viste den underliggende mønsteret.
De resulterende gruppe-merkene erstattet spesifikke termer med stedfortredere som ‘{Emne}’ eller ‘{Type av bevegelse}’, og gjorde dem bredt anvendelige.
Etter menneskelig verifisering, ble hver kapion koblet med alle bilder i sin gruppe. Mer enn 500 slike grupper ble brukt til å trene modellen, som deretter ble brukt på de 114 000 filtrerte bildene for å produsere et stort sett av abstrakte, relasjonelt annoterte eksempler.
Data og tester
Etter ekstraksjon av relasjonelle egenskaper med Qwen2.5-VL-7B, ble en modell finjustert på dataene ved hjelp av LoRA, i 15 000 steg, via åtte A100-GPUer*. For tekst-siden, ble relasjonelle kapioner innlemmet ved hjelp av all-MiniLM-L6-v2 fra Sentence-Transformers-biblioteket.
Datasettet på 114 000 merkte bilder, ble delt inn i 100 000 for trening og 14 000 for evaluering. For å teste systemet, ble en innhentingoppsett brukt: gitt et spøringsbilde, måtte modellen finne et annet bilde fra en 28 000-objekt-pool som uttrykte samme relasjonelle idé. Innhentingspoolen inkluderte 14 000 evalueringsbilder og 14 000 ekstra eksempler fra LAION-2B, med 1 000 spøringer valgt tilfeldig fra evalueringssettet for benchmarking.
For å evaluere innhentingskvalitet, ble GPT-4o brukt til å score den relasjonelle likheten mellom hver spøring og hentet bilde på en skala fra 0 til 10. En separat menneskelig studie ble også gjennomført for å måle brukerpreferanse (se under).
Hver deltager ble vist et anonymt spøringsbilde med to kandidater, en hentet av den foreslåtte metoden og den andre av en baseline. Deltagerne ble bedt om å velge hvilket bilde som var mer relasjonelt likt spøringsbildet, eller hvis begge var like nære. For hver baseline, ble 300 triplettar laget og vurdert av minst tre personer hver, og resulterte i rundt 900 svar.
RelSim-tilnærmingen ble sammenlignet med flere etablerte bilde-til-bilde-ligningsmetoder, inkludert den ovennevnte LPIPS og DINO, samt dreamsim og CLIP-I. I tillegg til baselines som direkte beregner ligningsskår mellom bildepar, som LPIPS, DINO, dreamsim og CLIP-I, testet forfatterne også kapionsbaserte metoder hvor Qwen ble brukt til å generere en anonym eller abstrakt kapion for hvert bilde.; dette tjente deretter som innhentings-spøring.
To innhentingsvarianter ble evaluert, med CLIP-basert tekst-til-bilde-innhenting (CLIP-T) brukt til tekst-til-bilde-innhenting, og Qwen-T som brukte tekst-til-tekst-innhenting. Begge kapionsbaserte baselines brukte den opprinnelige forhånds-trent Qwen-modellen, i stedet for den finjusterte versjonen på relasjonell logikk. Dette tillot forfatterne å isolere effekten av gruppebasert trening, ettersom den finjusterte modellen hadde vært eksponert for bilde-sett, i stedet for isolerte eksempler.
Eksisterende metrikker og relasjonell likhet
Forfatterne testet først om eksisterende metrikker kunne fange relasjonell likhet:

Sammenligning av innhentingsytelse vurdert av GPT-4o, som viser gjennomsnittlig relasjonell likhetsskår for hver metode. Konvensjonelle ligningsmetrikker som LPIPS, DINO og CLIP-I fikk lavere skår. Kapionsbaserte baselines Qwen-T og CLIP-T underpresterte også. Den høyeste skåren ble oppnådd av relsim (6,77, høyre mest blå kolonne), og indikerer at finjustering på gruppebaserte relasjonelle mønster forbedret tilpasningen til GPT-4o sine vurderinger.
Om disse resultater slår forfatterne fast**:
‘[LPIPS], som fokuserer ren på perseptuell likhet, oppnår den laveste skåren (4,56). [DINO] presterte bare litt bedre (5,14), sannsynligvis fordi den er trent bare i en selvstendig måte på bilde-data. [CLIP-I] gir de sterkeste resultater blant baselinene (5,91), sannsynligvis fordi noen abstraksjon noen ganger er til stede i bildekapsler.
‘Men CLIP-I underpresterer likevel i forhold til vår metode, og å oppnå en bedre skår kan kreve evnen til å nå enda høyere abstraksjonsnivåer, slik som de i anonyme kapioner.’
I den menneskelige studien foretrakk mennesker konsekvent relsim-metoden over alle baselinene:

Relasjonell likhetsskår tildelt av GPT-4o for hver metode. Standard ligningsmetrikker som LPIPS, DINO og CLIP-I fikk lavere skår, og kapionsbaserte varianter Qwen-T og CLIP-T presterte bare litt bedre. Selv finjusterte versjoner av DINO og CLIP lukket ikke gapet. Den høyeste skåren, 6,77, ble oppnådd av den foreslåtte modellen, trent med gruppebasert overvåking.
Forfatterne påpeker:
‘Dette er svært oppmuntrende, ettersom det ikke bare viser at vår modell, relsim, kan suksessfullt hente relasjonelt like bilder, men også igjen bekrefter at mennesker faktisk oppfatter relasjonell likhet – ikke bare attributtlikhet!’
For å utforske hvordan relasjonell og attributtlikhet kan komplementere hverandre, brukte forskerne en kombineringsvisualiseringsmetode. Et enkelt spøringsbilde (‘En hund som holder et kamera’) ble sammenlignet med 3 000 tilfeldige bilder, og likhet ble beregnet ved hjelp av både relasjonell og attributtbasert modeller:

Fellessvisualisering av visuell likhetsrom ved hjelp av relasjonell og attributt-akser. Et enkelt spøringsbilde, som viser en hund som bruker et kamera, ble sammenlignet med 3 000 andre. Resultatene ble organisert etter relasjonell likhet (vertikal) og attributtlikhet (horisontal). Øvre høyre regionen inneholder bilder som ligner spøringsbildet både i logikk og utseende, som andre hunder som bruker verktøy. Øvre venstre regionen inneholder semantisk relaterte, men visuelt distinkte eksempler, som andre dyr som utfører kamera-relaterte handlinger. De fleste gjenværende eksemplene grupperer lavere i rommet, og reflekterer svakere likhet. Layouten viser hvordan relasjonell og attributtmodeller fremhever komplementære aspekter av visuell data. Vennligst se kildeartikkelen for bedre oppløsning.
Resultatene avdekket kluster som motsvarer ulike typer likhet: noen bilder var både relasjonelt og visuelt like, som andre hunder i menneskelige posisjoner; andre delte relasjonell logikk, men ikke utseende, som andre dyr som imiterer menneskelige handlinger; resten viste ingen.
Denne analysen antyder at de to likhetstypene tjener distinkte roller og gir rikere struktur når de kombineres.
Bruksområder
Artikkelen utforsker også noen mulige bruksområder for relasjonell likhet, inkludert relasjonell bilde-innhenting, som tillater bilde-søk mer i samsvar med menneskers egen kreative måte å se på verden:

Relasjonell innhenting returnerer bilder som deler en dypere konseptuell struktur med spøringsbildet, i stedet for å matche overfladetrek. For eksempel returnerer en matvare som er stilisert for å ligne et ansikt andre antropomorfe måltider; et skåret objekt returnerer andre skårede former; og scener med voksen-avkom-interaksjon returnerer bilder med lignende relasjonelle roller, selv om arter og komposisjon forskjeller.
Et annet mulighet er analogisk bilde-generering, som ville tillate syntese av spøringer som bruker relasjonelle strukturer i stedet for direkte beskrivelser. I en sammenligning av resultater fra nåværende generasjon av tekst-til-bilde-modeller, kan vi se at resultatene av en slik tilnærming sannsynligvis vil være mer diverse:

Gitt et inngangsbilde og en relasjonell prompt, ble modellene bedt om å generere et nytt bilde som uttrykker samme underliggende konsept. Proprietære modeller produserte mer trofaste analogier, og bevarte strukturell logikk over store endringer i form, mens åpne modeller tenderte til å regrediere til bokstavelige eller stilistiske matcher, og mislyktes i å overføre den dypere idéen. Utgangene ble sammenlignet med menneske-kurerte analogier, som eksemplifiserte den ønskede transformasjonen.
Konklusjon
Generative AI-systemer ville, det ser ut til, være merkbart forbedret ved en evne til å inkorporere abstrakt representasjon i deres konseptualiseringer. Som det står nå, å be om konsept-baserte bilder som ‘sinne’ eller ‘lykke’ tenderer til å returnere bilder stilisert fra de mest populære eller tallrike bildene som hadde disse assosiasjonene i datasettet; hvilket er memorisering i stedet for abstraksjon.
Det ser ut til at dette prinsippet kunne være enda mer nyttig hvis det kunne bli anvendt på generativ skriving – spesielt analytisk, spekulativ eller fiktiv utgang.
Trykk på å spille. Kilde
* En A100 kan ha 40Gb eller 80GB av VRAM; dette er ikke spesifisert i artikkelen.
** Forfatternes sitater er redundante og ekskludert.
Først publisert tirsdag, 16. desember 2025


