
Grunnleggende AI
Hva er tilbakepropagering?

 Legg til Unite.AI blant dine foretrukne kilder på Google
Backpropagation er algoritmen som brukes til å beregne hvordan tapet til et nevralnettverk endres med hensyn til dets trenbare parametere. Den anvender kjerneregelen i kalkulus bakover gjennom operasjonene som ble lagret under en fremoverpassering.
Tilbakepropagering beregner gradienter; den bestemmer ikke oppdateringen i seg selv. En optimaliserer som stokastisk gradientnedstigning eller AdamW bruker disse gradientene til å endre vekter, biaser og andre trenbare parametere.
Viktige punkter
- Fremoverpasseringen bygger mellomliggende verdier og produserer en prediksjon.
- Tapfunksjonen konverterer prediksjonen og målet til et skalar treningsmål.
- Tilbakepropagering bruker lokale deriverte og kjerneregelen for å beregne parametergradienter effektivt.
- Moderne rammeverk implementerer reversmodus automatisk differensiering over en beregningsgraf.
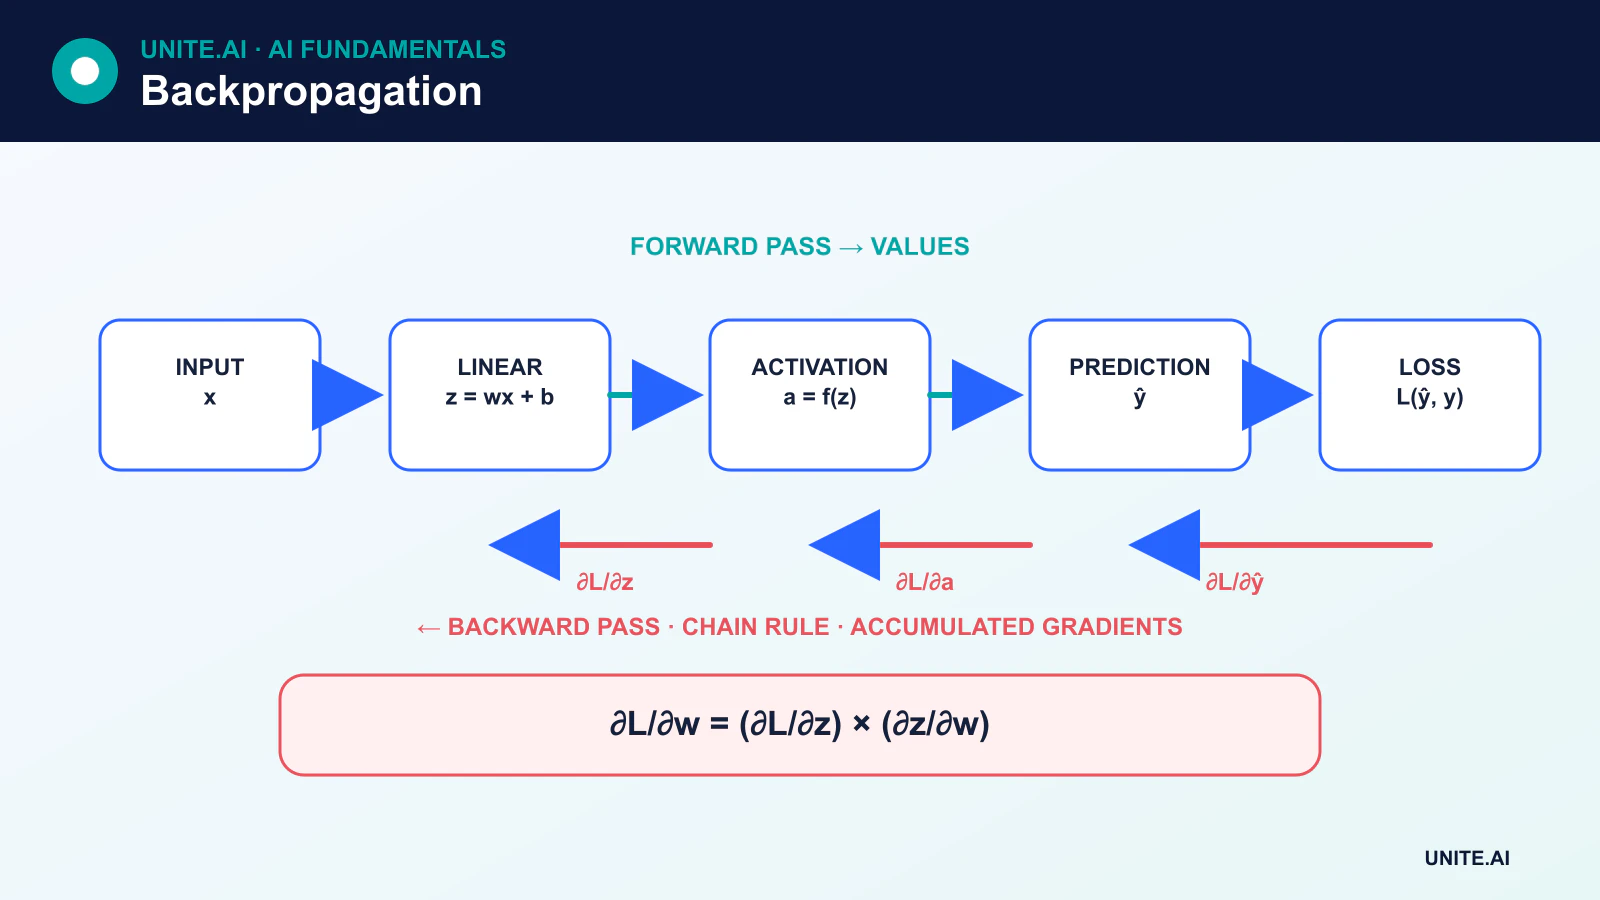
Fremoverpasseringen
Vurder en enkel enhet:
z = wx + bŷ = activation(z)
Inndataen er x, mens w og b er trenbare vekt- og bias‑parametere. Biaser endres vanligvis under trening akkurat som vekter gjør. Et nettverk kombinerer mange slike operasjoner, pluss normalisering, oppmerksomhet, konvolusjoner, residualkoblinger eller andre differensierbare blokker.
Fremoverpasseringen evaluerer disse operasjonene og produserer en prediksjon. Et tap som kryss‑entropi eller gjennomsnittlig kvadratisk feil måler målet. Det beste tapet avhenger av oppgaven og tolkningen av output.
Kjerneregelen
Hvis tapet L avhenger av en mellomliggende verdi z, og z avhenger av parameteren w, gir kjerneregelen:
∂L/∂w = (∂L/∂z) × (∂z/∂w)
Et dypt nettverk inneholder mange stier. Tilbakepropagering traverserer beregningsgrafen i revers, og akkumulerer bidrag når en verdi påvirker tapet gjennom mer enn én sti. Resultatet er en gradient for hver trenbar parameter som deltok i fremoverberegningen.
Et lite numerisk eksempel
Anta at ŷ = wx + b, med x = 2, w = 3 og b = 1. Prediksjonen er 7. Hvis målet er 5 og tapet er L = ½(ŷ - y)², så:
∂L/∂ŷ = ŷ - y = 2∂ŷ/∂w = x = 2∂L/∂w = 2 × 2 = 4∂L/∂b = 2 × 1 = 2
Optimalisereren kan da flytte w og b i den negative gradientretningen. Denne formelen er spesifikk for den valgte lineære enheten og kvadratisk‑feiltap; en universell tilbakepropageringsregel er kjerneregelen over den faktiske grafen, ikke en fast «feil»-likning.
Tilbakepropagering versus gradientnedstigning
Gradientnedstigning er en optimaliseringsmetode. Tilbakepropagering leverer gradientene den trenger. Et treningssteg følger vanligvis:
- Tøm eller tilbakestill lagrede gradienter.
- Kjør fremoverpasseringen.
- Beregn tapet.
- Kjør bakoverpasseringen.
- Påfør optimalisererens oppdatering.
Å skille disse konseptene gjør det enklere å forstå momentum, AdamW, gradientakkumulering og blandet‑presisjonstrening.
Automatisk differensiering
Rammeverk som PyTorch registrerer operasjoner og bygger en graf under fremoverpasseringen. Reversmodus automatisk differensiering beregner deretter vektor‑Jacobian‑produkter effektivt fra utganger tilbake til parametere. Dette er mer generelt enn å kode derivater manuelt for et fast nettverk og er grunnleggende for moderne dyp‑læring-rammeverk.
Noen operasjoner er ikke‑differensierbare eller har ustabile derivater. Rammeverk definerer subgradienter eller dokumenterte konvensjoner i visse tilfeller, men praktikere må fortsatt forstå frakoblede tensorer, operasjoner på‑stedet og numerisk presisjon.
Forsvinnende og eksploderende gradienter
Gjentatt multiplikasjon gjennom mange lag eller tidssteg kan gjøre gradienter ekstremt små eller store. Forsvinnende gradienter bremser læringen i tidlige lag; eksploderende gradienter destabiliserer oppdateringer. ReLU‑familie‑aktiveringer, nøye initiering, residualkoblinger, normalisering, gated‑rekurrens og gradientklipping hjelper, men ingen er en universell kur.
Sjekke gradienter
Finitt differanse‑gradientkontroll sammenligner en analytisk eller automatisk gradient med en numerisk tilnærming. Den er treg men nyttig for feilsøking av tilpassede operasjoner. Overvåking av gradientnormer og oppdagelse av NaN‑ eller uendelige verdier kan avsløre ustabilitet under trening.
Kjerneregelen gjennom en beregningsgraf
Tilbakepropagering beregner effektivt gradienter av et skalar‑tap med hensyn til hver differensierbare parameter. En fremoverpassering registrerer mellomliggende verdier i en beregningsgraf. Fra tapet anvender reversmodus automatisk differensiering kjerneregelen, multipliserer lokale derivater og akkumulerer bidrag der stier møtes. For et lag y=f(x,w) kombineres oppstrøms‑sensitivitet til y med partielle derivater for å produsere sensitivitet for x og w. Tilbakepropagering beregner gradienter; optimalisereren bestemmer hvordan parametere endres.
Et enkelt affint lag produserer y=Wx+b. Gradientet for W er det ytre produktet av oppstrøms‑gradienten og inndata, gradientet for b summerer oppstrøms‑verdier, og inndata‑gradienten multipliseres med den transponerte vektmatrisen. Aktiveringer legger til elementvise derivater. Konvolusjon, normalisering, oppmerksomhet og rekurrent gjenbruk følger samme grafprinsipp, men krever korrekte tensor‑former, broadcasting, maskering og parameterdeling. Rammeverk frigjør lagrede aktiveringer etter bakoverpassering med mindre de beholdes, så minnet vokser ofte med batch‑størrelse, dybde og sekvenslengde.
Gradientfeil, verifisering og ingeniørpraksis
Produkter av mange derivater kan forsvinne eller eksplodere. ReLU‑lignende aktiveringer, nøye initiering, normalisering, residualkoblinger, gating og gradientklipping adresserer ulike mekanismer. Mettet aktivering og ikke‑differensierbare operasjoner kan blokkere nyttige signaler; avkortet tilbakepropagering begrenser sekvenshistorikk; blandet presisjon kan underflyte uten tap‑skalering. Eksploderende gradienter er et symptom, så klipping bør ledsages av undersøkelse av læringsrate, data, arkitektur og numeriske feil i stedet for å skjule dem.
Verifiser tilpassede operasjoner med finitt differanse‑gradientkontroller på små dobbel‑presisjon‑inndata, og unngå ikke‑differensierbare punkter. Inspiser gradientnormer, NaN‑verdier, inaktive parametere, og om gradientene når forventede moduler. Tøm akkumulerte gradienter bevisst og skill mellom trenings‑ og evalueringsadferd for dropout og normalisering. Kontrollpunkt‑gjenberegning av aktiveringer sparer minne; distribuert trening må aggregere gradienter konsistent. En synkende trenings‑tap viser at en optimaliseringsvei finnes, ikke at gradientene er konseptuelt korrekte, data er lekkasjefrie, eller at modellen generaliserer.
Arbeidseksempel: verifisering av et tilpasset nevralt lag
En ingeniør implementerer et differensierbart spektrallag for et lydnettverk. En liten dobbel‑presisjon‑test sammenligner automatiske gradienter med sentrale finitte differanser over inndata og parametere, og ekskluderer punkter hvor operasjonen bevisst er ikke‑differensierbar. Form, broadcasting, padding og kompleks‑til‑reell konvertering får separate tilfeller. Testen verifiserer akkumulerte gradienter når en parameter gjenbrukes og bekrefter at maskerte lydrammer ikke produserer gradient.
Under trening sporer dashborder gradient‑ og aktiveringsnormer, NaN‑verdier, inaktive parametere og tap‑skalering. En bevisst korrumpert batch bekrefter at validering fanger opp ikke‑finite output før en optimaliserer‑oppdatering. Blandet presisjon og eksporterte implementasjoner sammenlignes med referansen. Gjenopptak‑test av kontrollpunkt inkluderer optimaliserer‑tilstand og tilfeldig rekkefølge. Laget aksepteres ikke bare fordi total‑tapet faller; enhetsgradienter, numerisk stabilitet og nedstrøms‑generalisering må alle gi konsistent bevis.
Ofte stilte spørsmål
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, inndata, utdata, avhengigheter, eier, og konsekvensen av hver viktig feil. Etabler en reproduserbar basislinje og et versjonert evalueringssett før justering. Test vanlige tilfeller, grensetilstander, feil‑ eller manglende inndata, distribusjonsendring, avhengighets‑nedbrudd, misbruk, og gruppene eller miljøene som mest sannsynlig blir underbetjent. Mål oppgavekvalitet sammen med kalibrering eller usikkerhet, latenstid, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig vurderer kan reprodusere resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbake‑rulling og pensjonering. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåkning med bevisst injiserte feil. Operasjonell telemetri bør avdekke inndata‑kvalitet, utdata‑adferd, modell‑ eller regelversjon, avhengighets‑helse, menneskelig overstyring, og bekreftede resultater uten å samle unødvendige sensitive data. Definer varsel‑terskler og en ansvarlig for respons, og gjennomgå virkelige bevis etter distribusjon i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, retningslinjer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelses‑læring, slettings‑ og lagrings‑prosedyrer, og et klart punkt hvor det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Oppdaterer tilbakepropagering vektene?
Tilbakepropagering beregner gradienter. Optimalisereren anvender en oppdatering ved hjelp av disse gradientene, læringsraten, og eventuelt tilstand som momentum eller adaptive momenter.
Er tilbakepropagering biologisk realistisk?
Standard tilbakepropagering er en ingeniøralgoritme og aksepteres ikke som en detaljert modell for læring i biologiske hjerner. Den historiske nevrale analogien bør ikke behandles som biologisk ekvivalens.
Primære referanser












