Grunnleggende AI
Hva er nevrale nettverk?

 Legg til Unite.AI blant dine foretrukne kilder på Google
Et kunstig nevralt nettverk er en parametrisk matematisk modell bygget av lag med sammenkoblede operasjoner. Under trening justerer nettverket sine parametere slik at innganger blir kartlagt til nyttige utganger. Nevrale nettverk kan tilnærme komplekse ikke-lineære relasjoner og lære representasjoner direkte fra tekst, bilder, lyd, tidsserier og andre data.
Navnet er historisk inspirert av biologiske nevroner, men moderne nettverk er ingeniørsystemer snarere enn realistiske simuleringer av hjernen. Begreper som “neuron” og “learning” er nyttige forkortelser og bør ikke forveksles med bevis på menneskelig liknende kognisjon.
Viktige punkter
- Et nevron beregner en vektet sum, legger til en trenbar bias, og anvender en aktiveringsfunksjon.
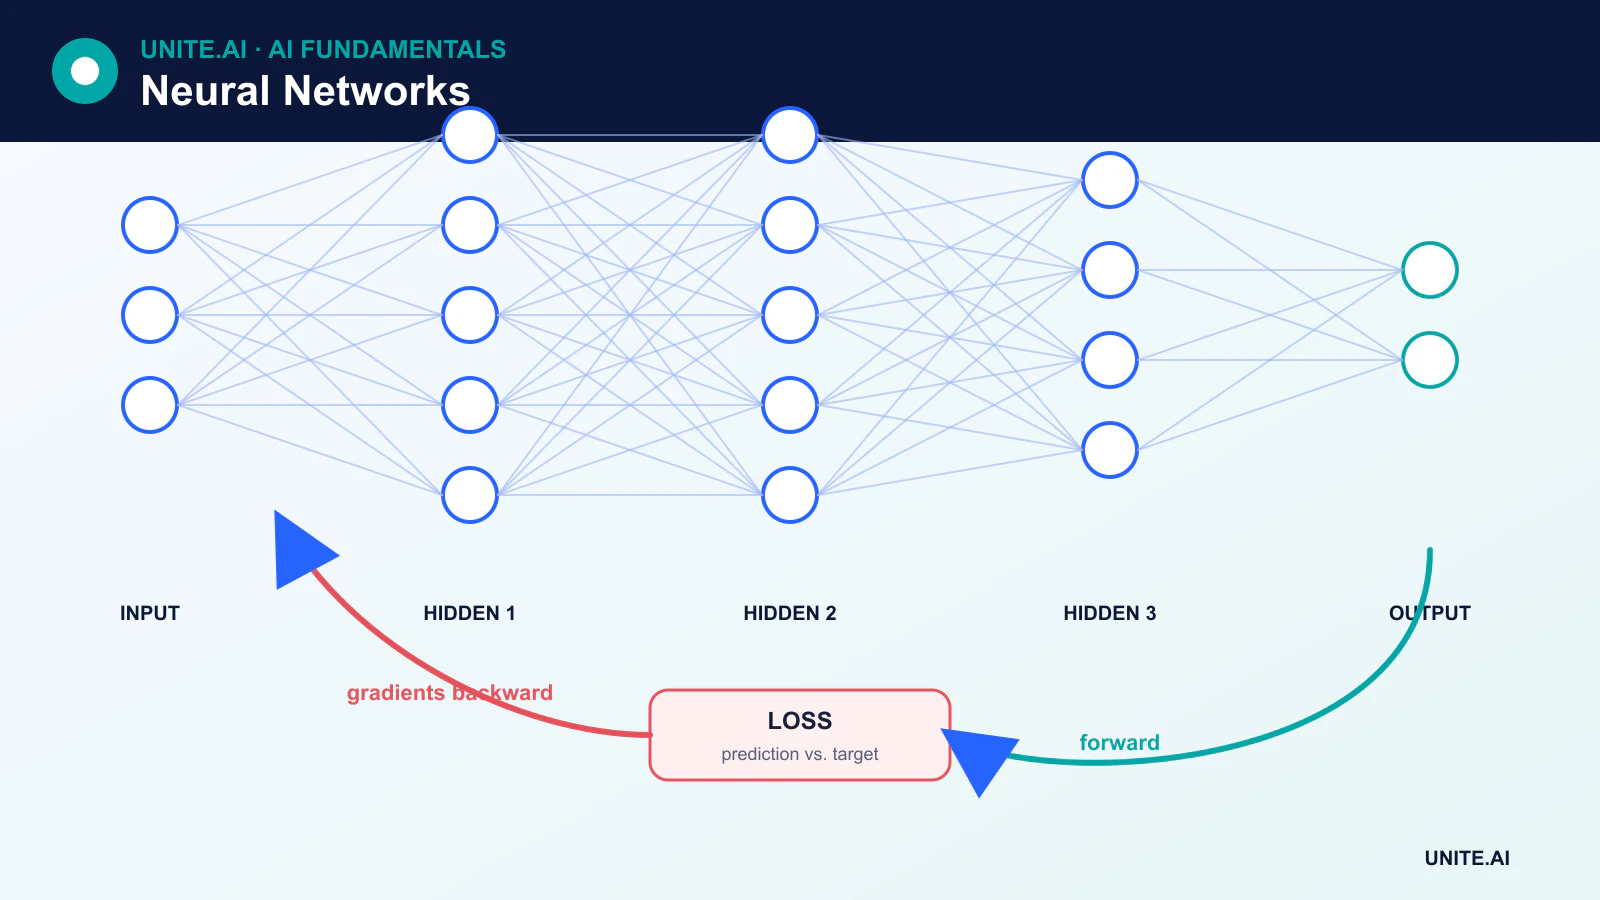
- Et fremoverpass genererer prediksjoner; et tap måler feil; tilbakepropagering beregner gradienter; en optimaliserer oppdaterer parametere.
- MLP‑er, CNN‑er, RNN‑er og transformere organiserer forbindelser på ulike måter.
- Flere lag eller parametere gir ikke automatisk en bedre eller mer pålitelig modell.
Fra ett enkelt kunstig nevron til et nettverk
For en input‑vektor x beregner en grunnleggende enhet:
z = Wx + boutput = activation(z)
W inneholder trenbare vekter og b er en trenbar bias. Aktiveringsfunksjonen introduserer ikke‑linearitet. Vektene “går ikke gjennom” aktiveringen på egen hånd; aktiveringen anvendes på den vektede summen og biasen.
En flerskikts perseptron (MLP) stabler tette lag. Inngangslaget representerer funksjonene, skjulte lag transformerer dem, og utgangslaget er designet for oppgaven – for eksempel klasse‑logits eller en regresjonsverdi.
Hvordan nevrale nettverk lærer
- Modellen initialiserer trenbare parametere.
- Et fremoverpass behandler en batch og produserer prediksjoner.
- En tap‑funksjon sammenligner prediksjoner med treningsmålet.
- Backpropagation bruker kjerneregelen for å beregne gradienter.
- En optimaliserer som stokastisk gradientnedstigning eller AdamW oppdaterer vekter og biaser.
Backpropagation ble sentral i trening av nevrale nettverk gjennom arbeid som ble utviklet og popularisert over flere tiår; den ble ikke først laget i den nylige dyp‑læringsepoken. Moderne rammeverk implementerer automatisk differensiering i reversmodus slik at brukere ikke trenger å derivere hver gradient manuelt.
Hvorfor aktiveringsfunksjoner er viktige
Uten ikke‑lineære aktiveringer vil flere vanlige lineære lag smelte sammen til én lineær transformasjon. ReLU er mye brukt fordi den er enkel og effektiv. GELU og SiLU er vanlige i moderne arkitekturer. Sigmoid og softmax er fortsatt nyttige for spesifikke utgangstolkninger, men sigmoid kan mette i skjulte lag og bidra til forsvinnende gradienter.
Store nevrale nettverksarkitekturer
Konvolusjonelle nevrale nettverk
CNNs bruker lærte filtre over lokale nabolag og deler parametere på tvers av posisjoner. Disse egenskapene gjør dem effektive for bilder og andre rutenett‑lignende signaler.
Rekurrente nettverk
RNNs, LSTMs, and GRUs oppdaterer en skjult tilstand over en sekvens. De er fortsatt nyttige for streaming‑ og tidsserie‑oppgaver, selv om rekurrens begrenser parallell prosessering og kan ha problemer med lange avhengigheter.
Transformere
Transformers bruker oppmerksomhet for å lage kontekst‑avhengige representasjoner. Residual‑forbindelser, normalisering, posisjonsinformasjon og feed‑forward‑blokker er kjernekomponenter i arkitekturen. Transformere danner nå grunnlaget for mange store språk‑ og multimodale modeller.
Autoenkodere og generative nettverk
Autoencoders lærer representasjoner gjennom rekonstruksjon. GAN‑er, diffusionsmodeller og autoregressive nettverk genererer nye prøver ved å bruke ulike mål og treningsprosedyrer.
Komponenter som gjør dype nettverk trenbare
Moderne systemer bruker mer enn lag og aktiveringer. Residual‑forbindelser lar informasjon og gradienter omgå blokker. Normalisering stabiliserer aktiveringer. Regularisering, data‑augmentering, dropout og vekt‑nedbrytning kan redusere overtilpasning. Embedding‑lag kartlegger diskrete elementer som token til vektorer. Oppmerksomhet gjør at en representasjon kan avhenge dynamisk av andre elementer.
Styrker og begrensninger
Nevrale nettverk kan lære funksjoner fra høy‑dimensjonal rådata og skaleres med data og beregning. De kan også kreve store datasett, spesialisert maskinvare og nøye justering. Prediksjonene deres kan være dårlig kalibrerte, skjøre ved distribusjonsendring, sårbare for adversarial‑manipulasjon, eller vanskelige å forklare.
Arkitekturen bør følge oppgaven og distribusjonsbegrensningene. For mange tabular‑problemer kan en tre‑ensemble eller lineær modell være raskere og lettere å validere. For høy‑risiko‑applikasjoner må modellens ytelse evalueres per undergruppe og feilsituasjon, ikke bare via et samlet benchmark.
Lag, aktiveringer og informasjonsflyt
Et nevralt nettverk komponerer parametriserte funksjoner. Hver enhet lager en vektet kombinasjon av innganger, legger til en bias, og sender resultatet gjennom en aktivering som ReLU, sigmoid, tanh eller GELU. Å stable lag gjør det mulig med hierarkiske funksjoner og ikke‑lineære beslutningsgrenser. Bredde styrer antall enheter per lag; dybde styrer påfølgende transformasjoner; tilkobling og vekt‑deling koder arkitekturen. Nettverkets utgang avhenger av forhåndsbehandling, parametere, normalisering og inferensmodus sammen. Et nevron er en matematisk operasjon, ikke et bokstavelig biologisk nevron eller et uavhengig meningsfullt konsept.
Fremoverpropagering beregner prediksjoner; et tap kvantifiserer feil; tilbakepropagering anvender kjerneregelen på gradienter; en optimaliserer oppdaterer parametere. Initialisering, læringsrate, batch‑statistikk, residual‑veier og normalisering påvirker om gradienter forsvinner, eksploderer eller forblir nyttige. Regularisering inkluderer vekt‑nedbrytning, dropout, augmentering, tidlig stopp og arkitektoniske begrensninger. Plot trening‑ og valideringsatferd, inspiser gradient‑ og aktiveringsstatistikk, og sammenlign gjentatte kjøringer. Et stort nettverk kan memorere treningsdata, mens et lite kan under‑tilpasse eller gå glipp av nødvendig struktur.
Valg av arkitektur, evaluering og distribusjon
Flerskikts perseptroner behandler faste vektorer; konvolusjonelle nettverk utnytter lokal struktur; rekurrente og state‑space‑modeller behandler sekvenser; transformere bruker oppmerksomhet; graf‑nettverk utveksler informasjon langs kanter. Hybrider er vanlige. Velg basert på induktiv bias, data, sekvens‑ eller bildestørrelse, latenstid, minne, tolkbarhet og tilgjengelig maskinvare. Evaluer mot en lineær‑ eller tre‑baseline og utfør ablasjoner for å lære hvilken kompleksitet som er viktig. Antall parametere alene forutsier ikke kvalitet, inferenskostnad eller datakrav.
Distribusjon krever frosset forhåndsbehandling, en eksportert eller kompilert graf, numerisk validering og ressurs‑tester under realistisk belastning. Kvantisering og beskjæring kan redusere størrelse, men kan endre oppførsel for sjeldne klasser. Overvåk innganger, utganger, kalibrering, latenstid og bekreftede resultater; test adversarial‑ og skiftet data. Beskytt modeller, avhengigheter og data gjennom signerte artefakter, tilgangskontroll og leverandørkjede‑gjennomgang. Forklaringer fra individuelle aktiveringer eller saliens krever kausal og atferdsverifisering. Nevrale nettverk er fleksible funksjons‑approksimanter, ikke garantier for forståelse, sannhet eller robusthet.
Arbeidseksempel: en nevralt basert etterspørselsprognostiker
En forhandler forutsier ukentlig vareetterspørsel basert på salg, kampanjer, pris, helligdager, tilgjengelighet og vær. Nettverket sammenlignes med sesong‑naive, lineære og tre‑baselines ved bruk av rullende tids‑splitt. Fremtidige kampanjer inkluderes kun når de virkelig er kjent på prognosetidspunktet, mens lager‑utsolgt modelleres fordi observerte salg kan undervurdere etterspørselen. Evalueringen bruker vektet absolutt feil, bias, intervalldekning og resultater etter vare‑hastighet og butikk.
Distribusjons‑pipeline‑versjonene inkluderer funksjons‑tilgjengelighet, modell og horisont og avviser en prognose når nødvendige innganger er utdaterte. Planleggere ser intervaller og kan overstyre med registrerte begrunnelser. Overvåkning oppdager manglende datastrømmer, endrende feil, bias og uvanlige prognoser; forretningsresultater skilles fra prognosenøyaktighet fordi bestillingspolitikk også påvirker lager. En modelloppdatering er skyggelagt over flere sykluser, og den tidligere prognostikeren forblir tilgjengelig for tilbakeføring under sesong‑ eller leverandør‑forstyrrelser.
Implementasjonsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, innganger, utganger, avhengigheter, eier og konsekvensen av hver viktig feil. Etabler en reproduserbar baseline og et versjonert evalueringssett før tuning. Test vanlige tilfeller, grensebetingelser, feil‑ eller manglende inngang, distribusjonsendring, avhengighets‑nedbrudd, misbruk, og gruppene eller miljøene som mest sannsynlig blir underbetjent. Mål oppgavens kvalitet sammen med kalibrering eller usikkerhet, latenstid, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig vurderer kan reprodusere resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåkning med bevisst injiserte feil. Operasjonell telemetri bør avdekke inngangskvalitet, utgangsatferd, modell‑ eller regelversjon, avhengighets‑helse, menneskelige overstyringer og bekreftede resultater uten å samle unødvendige sensitive data. Definer varslings‑terskler og en ansvarlig for respons, og gjennomgå virkelige bevis etter distribusjon i stedet for å anta at offline‑ytelse vedvarer. Revurder når datakilder, brukere, modeller, leverandører, retningslinjer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelses‑læring, slettings‑ og lagringsprosedyrer, og et klart punkt hvor det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Er hvert nevralt nettverk dyp læring?
Nei. Et lite nettverk med ett skjult lag er et nevralt nettverk, mens dyp læring vanligvis refererer til arkitekturer med flere lærte behandlingsstadier. Grensen er konvensjonell snarere enn en streng vitenskapelig terskel.
Lagrer nevrale nettverk treningsdataene sine?
De lagrer lærte parametere, ikke en vanlig søkbar kopi av datasettet. Likevel kan store modeller memorere og gjenskape individuelle trenings‑eksempler, noe som skaper personvern‑ og opphavsrettsrisikoer som må testes.
Primære referanser