
Grunnleggende AI
Hva er et beslutningstre?

 Legg til Unite.AI blant dine foretrukne kilder på Google
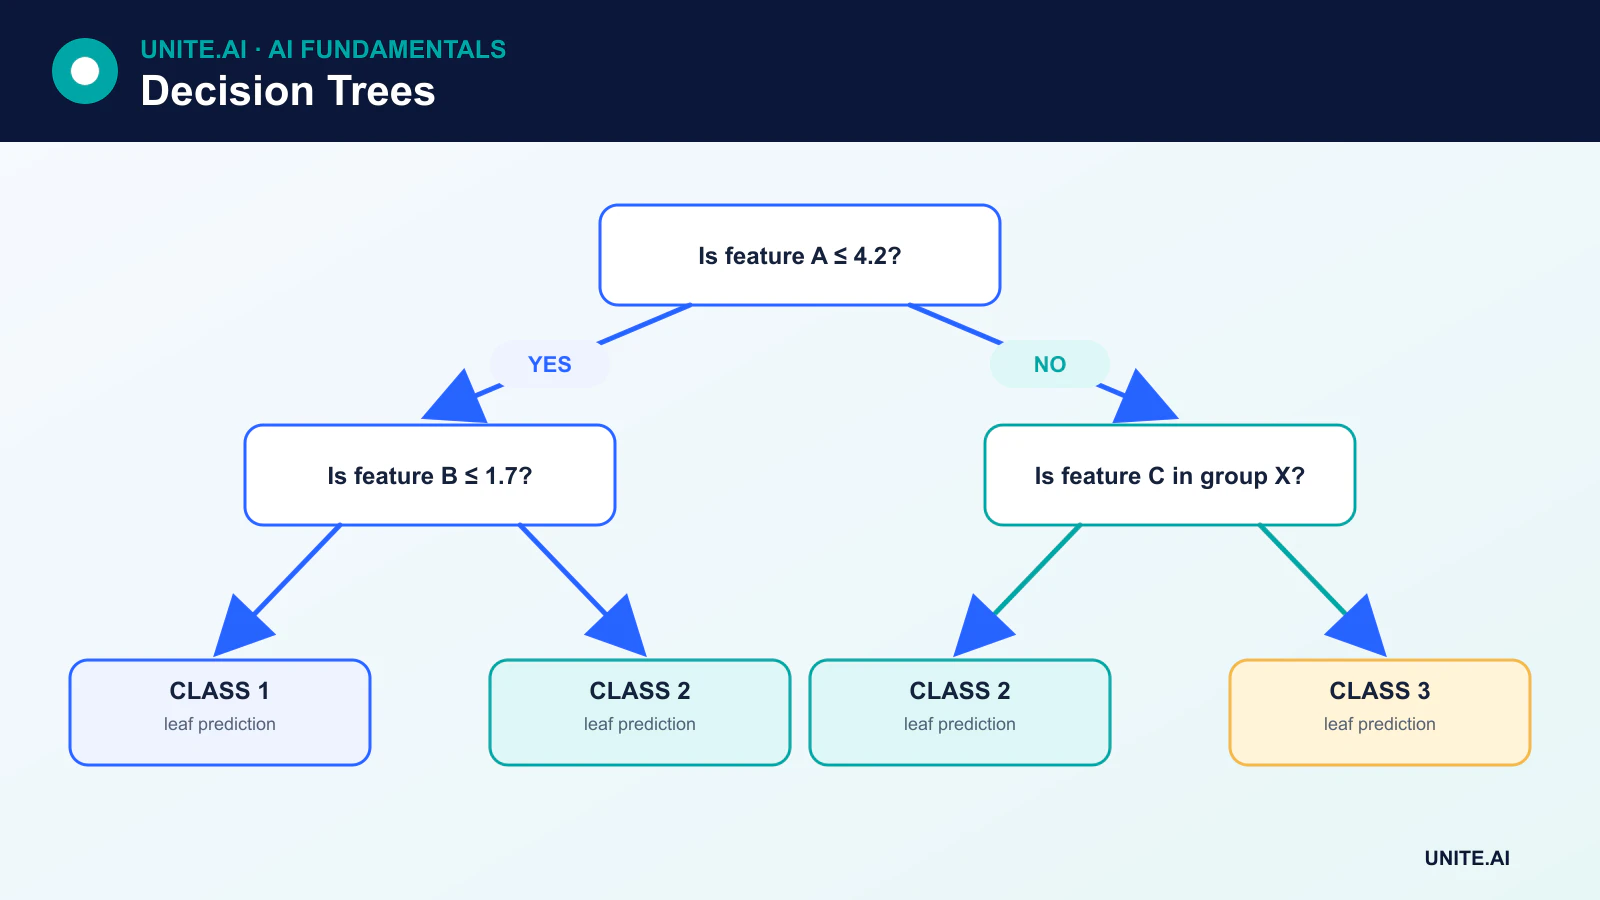
Et beslutningstre er en overvåket læringsmodell som gjør en prediksjon ved å anvende en sekvens av hvis‑så‑regler. Hvert internt node tester en funksjon, hver gren representerer utfallet av den testen, og hvert blad produserer en klasseprediksjon, sannsynlighet eller numerisk verdi.
Beslutningstrær brukes til klassifisering og regresjon. Deres appell er praktisk: de kan representere ikke‑lineære interaksjoner, krever relativt lite forhåndsbehandling, og produserer en sti som en person kan inspisere. Deres svakhet er ustabilitet — små endringer i treningsdataene kan skape et annet tre.
Viktige punkter
- Et tre deler rekursivt funksjonsrommet; det trenger ikke isolere hver treningsobservasjon.
- Klassifiseringssplitt bruker vanligvis Gini‑impuritet eller entropi, mens regresjonssplitt reduserer prediksjonsfeil eller varians.
- Dybde, minimum bladstørrelse og beskjæring kontrollerer kompleksitet og overtilpasning.
- Tilfeldige skoger og gradient‑boostede trær forbedrer prediksjonskraften ved å kombinere mange trær.
Hvordan et beslutningstre gjør en prediksjon
Anta at en modell forutsier om en maskin sannsynligvis vil svikte. Rotnoden kan spørre om vibrasjonen overstiger en lært terskel. En gren kan deretter teste driftstemperatur. Observasjonen når et blad som inneholder den estimerte svikt‑sannsynligheten blant treningseksempler som fulgte samme sti.
For regresjon kan bladet returnere gjennomsnittsverdien for målet til observasjonene i den regionen. For klassifisering kan det returnere majoritetsklassen eller en fordeling av klassefrekvenser. Et blad kan inneholde mange observasjoner; å fullstendig separere treningsdataene er vanligvis uønsket fordi det kan produsere et overtilpasset tre.
Hvordan et tre velger en splitt
Trening vurderer kandidat‑funksjoner og terskler, og velger deretter den splittingen som forbedrer et definert mål mest. Forbedringen må vektes etter hvor mange observasjoner som går til hvert barnenode.
Gini‑impuritet
For klassifisering måler Gini‑impuritet hvor blandet klassene er i en node:
Gini = 1 - Σ p(k)²
En node som inneholder kun én klasse har impuritet null. En kandidat‑splitt er nyttig når den vektede impuriteten til dens barn er lavere enn impuriteten til forelderen.
Entropi og informasjonsgevinst
Entropi er et annet mål på klasseusikkerhet:
Entropy = -Σ p(k) log₂ p(k)
Informasjonsgevinst er forelder‑entropi minus den vektede barn‑entropien. Gini og entropi gir ofte lignende trær, selv om de ikke alltid er identiske.
Regresjonstap
Regresjonstrær velger vanligvis splitt som reduserer kvadrert feil, absolutt feil eller et annet regresjonskriterium. Hvert blad forutsier deretter en verdi basert på treningsmålene i den regionen.
CART og andre tre‑algoritmer
CART, eller Classification and Regression Trees, bruker binære splitt og ligger til grunn for vanlige implementasjoner som scikit-learn sine beslutningstrær. Andre algoritmer inkluderer ID3, C4.5 og C5.0. Implementasjoner varierer i støttede splitt‑typer, håndtering av manglende verdier, beskjæring og mål.
Kategoriske variabler kan kreve koding, direkte delmengde‑splitt eller implementasjonsspesifikk håndtering. Manglende verdier kan imputeres eller håndteres gjennom lærte standardretninger eller surrogat‑splitt. Det er viktig å forstå oppførselen til det spesifikke biblioteket i stedet for å anta at alle tre‑implementasjoner fungerer på samme måte.
Kontroll av trekompleksitet
Et dypt tre kan memorere støy. Vanlige kontroller inkluderer:
- Maksimum dybde: begrenser lengden på en prediksjonssti.
- Minimum antall prøver per splitt eller blad: forhindrer små regioner.
- Minimum impuritetsreduksjon: krever at en splitt gir tilstrekkelig gevinst.
- Maksimalt antall blader: setter en grense for total kompleksitet.
- Kostnad‑kompleksitet beskjæring: fjerner grener hvis forbedring ikke rettferdiggjør økt kompleksitet.
Beskjæring er en strukturert optimaliseringsprosess, ikke tilfeldig sletting. Hyperparametere bør velges med valideringsdata eller kryssvalidering, mens det endelige testsettet forblir urørt.
Styrker og begrensninger
Beslutningstrær kan modellere interaksjoner og terskeleffekter uten funksjonsskalaering. De godtar numeriske og, avhengig av implementasjonen, kategoriske innganger. Prediksjon er rask, og et lite tre er lett å visualisere.
Imidlertid kan et enkelt tre ha høy varians, skape brå prediksjonsendringer nær en splitt, og favorisere funksjoner med mange mulige splitt‑punkter. Trær ekstrapolerer også dårlig i regresjon: utenfor de observerte regionene returnerer et blad fortsatt en verdi lært fra sine treningsprøver. Et stort tre kan være like vanskelig å forstå som en annen kompleks modell.
Fra ett tre til ensembler
Ensemble‑læring kombinerer flere modeller. En tilfeldig skog trener mange trær på omprøvede observasjoner og delmengder av funksjoner, og gjennomsnitter deretter deres prediksjoner. Gradient‑boosting bygger trær sekvensielt slik at hvert nytt tre adresserer resterende feil. Disse tilnærmingene overgår vanligvis ett tre, men de gir avkall på noe tolkbarhet og legger til beregningskostnad.
Funksjons‑vikt fra et tre eller en ensembel bør tolkes nøye. Impuritet‑basert vikt kan være skjev, og en funksjons vikt beviser ikke kausalitet. Permutasjons‑vikt, delvis‑avhengighets‑verktøy og domenegjennomgang gir ekstra kontekst.
Hvordan et tre lærer splitt og prediksjoner
Et beslutningstre deler rekursivt funksjonsrommet. På hver node evaluerer en treningsalgoritme kandidat‑funksjonsterskler eller kategoripartisjoner og velger en splitt som mest reduserer impuritet, som Gini‑impuritet eller entropi for klassifisering og kvadrert feil for regresjon. Blader lagrer en klassedistribusjon eller numerisk prediksjon basert på treningsobservasjoner som når dem. Grådig splitt er beregningsmessig praktisk, men garanterer ikke det globale beste treet, og ulike prøver eller tie‑breaking kan gi ulike strukturer.
Kontinuerlige, ordinale, kategoriske og manglende funksjoner krever eksplisitt håndtering. One‑hot‑koding kan skape mange kandidat‑splitt; innebygde kategoriske metoder kan bruke ordnede statistikker men krever lekkasjesikker implementering. Trær krever ikke skalering, men de kan favorisere variabler med høy kardinalitet og isolere små grupper. Dybde, minimum bladstørrelse, minimum impuritetsreduksjon og kostnad‑kompleksitet beskjæring kontrollerer varians. Velg dem med valideringsdata og evaluer kalibrering, fordi en blad‑sannsynlighet basert på få tilfeller kan være ekstrem og ustabil.
Tolkning, feilmoduser og produksjonsbruk
En sti fra rot til blad er en eksakt regel for én modellprediksjon, men den er ikke automatisk en kausal forklaring. Korrelerte variabler kan erstatte hverandre, små dataendringer kan endre øvre splitt, og en tilsynelatende enkel sti kan avhenge av skjeve etiketter. Global funksjons‑vikt basert på impuritet kan være misvisende; permutasjons‑vikt, delvis avhengighet og kontrafaktiske sjekker gir kontekst, men har også forutsetninger. Rapporter usikkerhet og test om en påstått regel holder på uavhengige data og relevante undergrupper.
Enkle trær er nyttige når åpenhet, lav latens og moderat ikke‑lineær struktur er viktig, men ensembler gir vanligvis sterkere prediksjonsytelse. Valider grensetilstand, sjeldne kategorier, manglende verdier og innganger utenfor treningsområdet. Eksporterte regler må reprodusere trenings‑forbehandling og numerisk sammenligning nøyaktig. Overvåk blad‑okkupasjon, utgangsfordeling, feil og fremvoksende kategorier. Et tre som ruter mange nye tilfeller inn i et lite eller tidligere tomt område bør utløse en gjennomgang selv om samlet drift forblir liten. Ha en reserve for ugyldige skjemaer og dokumenter hver beskjærings‑ eller terskelbeslutning.
Arbeids eksempel: et tolkbart lånetriage‑tre
En utlåner bruker et tre kun for å prioritere ufullstendige søknader for manuell gjennomgang, ikke for å godkjenne eller avslå kreditt. Målet er et dokumentert fullstendighetsutfall, og funksjoner tilgjengelige ved innsamling ekskluderer senere beslutninger. Grupperte tidsmessige valideringer sammenligner et grunt beskjært tre med regler og logistisk regresjon. Minimum bladstørrelse forhindrer regler basert på noen få søkere, mens kalibrering og klasse‑spesifikke feil rapporteres på tvers av kanaler og relevante beskyttede grupper.
Gjennomgangere ser den eksakte stien og kildeverdiene, men kan korrigere feilaktige data og overstyre rutingen. Organisasjonen tester korrelerte proxy‑variabler og kontrafaktiske endringer, overvåker blad‑okkupasjon og manglende verdier, og behandler plutselig trafikk inn i et lite blad som en datakvalitets‑hendelse. Policy‑endringer skaper en ny modellversjon og validering, ikke en udokumentert splitt‑redigering. Fordi bruken påvirker tilgang og belastning, får søkere en menneskelig kanal, og treet presenteres aldri som en kausal forklaring på kredittverdighet.
Implementeringsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, innganger, utganger, avhengigheter, eier og konsekvensen av hver viktig feil. Etabler en reproducerbar basislinje og et versjonert evalueringssett før justering. Test vanlige tilfeller, grensetilstander, feilformede eller manglende innganger, distribusjons‑skift, avhengighets‑nedbrudd, misbruk, og gruppene eller miljøene som mest sannsynlig blir underbetjent. Mål oppgavekvalitet sammen med kalibrering eller usikkerhet, latens, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig reviewer kan reprodusere resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåking med bevisst injiserte feil. Operasjonell telemetri bør avdekke inndata‑kvalitet, utdata‑atferd, modell‑ eller regelversjon, avhengighets‑helse, menneskelige overstyringer og bekreftede resultater uten å samle unødvendige sensitive data. Definer varslings‑terskler og en ansvarlig for respons, og gjennomgå virkelige bevis etter utrulling i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, policyer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelses‑læring, sletting‑ og lagringsprosedyrer, og et klart punkt hvor det skal deaktiveres eller erstattes.
Primære referanser












