
Grunnleggende AI
Hva er forklarbar AI?

 Legg til Unite.AI blant dine foretrukne kilder på Google
Forklarbar AI (XAI) omfatter metoder og praksiser som hjelper folk å forstå en AI‑systems oppførsel eller output. En forklaring kan beskrive påvirkende innganger, vise et lignende eksempel, presentere en kontrafaktisk endring, oppsummere en global regel eller kommunisere når systemet ikke vet.
Ingen forklaring er universelt best. En utvikler som feilsøker en modell, en revisor som tester etterlevelse av retningslinjer og en person som påvirkes av en beslutning trenger ulike bevis. Forklaringer må derfor evalueres for nøyaktighet, mening og tiltenkt bruk – ikke bare visuell appell.
Nøkkelpunkter
- Åpenhet beskriver tilgjengelig informasjon; tolkbarhet handler om mening; forklaring kommuniserer bevis eller begrunnelser.
- Globale metoder oppsummerer en modell, mens lokale metoder tar for seg én prediksjon eller et lite område.
- Etterfølgende forklaringer kan være nyttige, men kan være ustabile eller ikke trofaste mot den underliggende modellen.
- En forklaring beviser ikke rettferdighet, kausalitet, robusthet eller korrekthet.
Fire prinsipper for nyttige forklaringer
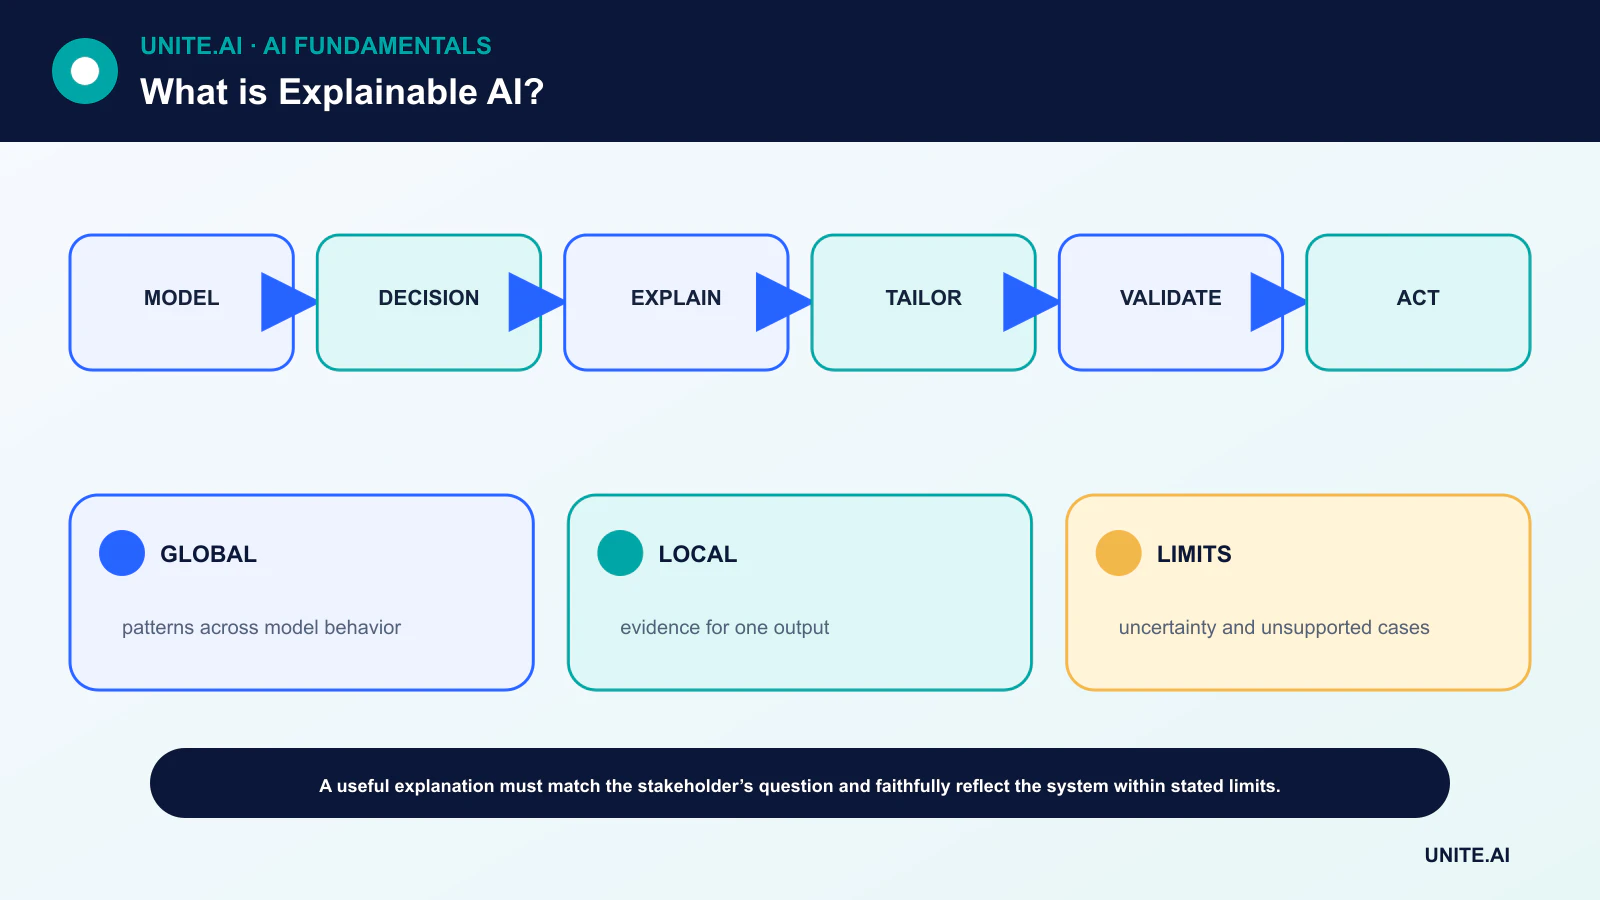
NIST foreslår at et system skal gi en forklaring, gjøre den meningsfull for den tiltenkte brukeren, sikre at den nøyaktig gjenspeiler systemets prosess, og kommunisere kunnskapsbegrensningene. Disse prinsippene skiller eksistensen av en forklaring fra dens kvalitet.
Mening er publikums‑spesifikk. En kort begrunnelseskode kan hjelpe en søker, mens en modellutvikler kan trenge fordelinger, funksjonsatferd og feil‑klustre. Begge bør knyttes til det samme dokumenterte systemet og beslutningskonteksten.
Intrinsiske og etterfølgende metoder
En sparsom lineær modell eller en begrenset beslutningstre kan være direkte tolkbar innen sitt gyldige område. En kompleks modell kan i stedet bruke etterfølgende funksjonsattributtering, en lokal surrogat, eksempler, salienstabeller eller kontrafaktiske forklaringer.
Intrinsisk enkelhet er ikke automatisk trofast når funksjonene er dårlig definert eller pipeline er skjult. Etterfølgende kompleksitet er ikke automatisk misvisende. Metoden må testes mot spørsmålet den er ment å besvare.
Funksjonsattributtering og korrelerte innganger
Attributteringsmetoder tildeler deler av en output til inngangsfunksjoner under eksplisitte antakelser. LIME tilpasser en enkel lokal surrogat rundt en prediksjon; SHAP‑relaterte metoder knytter additive attributter til Shapley‑verdikonsepter.
Korrelerte funksjoner kan dele eller bytte attributter, og en høy attributt er ikke en kausal effekt. Å endre en funksjon isolert kan skape en umulig person, bilde eller transaksjon. Forklaringer bør oppgi deres basislinje, utvalgs‑ og avhengighetsantakelser.
Kontrafaktiske forklaringer, eksempler og global atferd
En kontrafaktisk forklaring spør hvilken gjennomførbar endring som ville endre et resultat. Begrensninger er essensielle: en handlingsbar forklaring bør ikke anbefale uforanderlige, ulovlige eller urealistiske endringer. Eksempeldrevne metoder viser prototyper eller påvirkende treningseksempler, men kan avsløre private data.
Global analyse undersøker ytelse, delvis avhengighet, monotoni, interaksjoner og subgruppe‑atferd. For ensembler som gradient boosting, kombiner oppsummeringer med lokal evidens og direkte tester av forventede begrensninger.
Valider forklaringen og systemet
Test trofasthet, stabilitet under små forstyrrelser, konsistens på tvers av like innganger, brukerforståelse og om forklaringen støtter en passende beslutning. Adversarietester bør sjekke om en overbevisende forklaring kan følge med en feil eller manipulert output.
XAI inngår i en bredere evaluering: hold‑out‑kvalitet, kalibrering, rettferdighet, personvern, sikkerhet, overvåking og klage‑mekanismer. En forklaring kan støtte ansvarlighet, men den kan ikke erstatte ansvarlig styring.
Forklaringsmål og metodfamilier
Forklarbar AI bør starte med et spørsmål og publikum: hvorfor en beslutning ble tatt, hvordan modellen generelt oppfører seg, hvilke bevis som påvirket den, hva som ville endre resultatet, eller om en policy ble fulgt. Lokale forklaringer tar for seg én prediksjon; globale forklaringer oppsummerer bredere atferd. Intrinsisk tolkbare modeller viser koeffisienter, regler eller strukturer, mens etterfølgende metoder tilnærmer komplekse modeller. En forklaring på modellens atferd er ikke automatisk en kausal forklaring på verden eller en begrunnelse for at en beslutning er rettferdig.
Funksjonsattributteringsmetoder inkluderer gradienter, integrerte gradienter, SHAP‑lignende verdier, permutasjon og lokale surrogatmodeller. Eksempeldrevne forklaringer henter innflytelsesrike eller lignende tilfeller; kontrafaktiske forklaringer foreslår endringer knyttet til en annen output; konseptmetoder relaterer interne representasjoner til menneskelige kategorier. Hver har antakelser om basislinjer, funksjonsuavhengighet, lokal linearitet eller modelltilgang. Korrelerte variabler, interaksjoner og forhåndsbehandling kan gjøre attributter ustabile eller misvisende. Sammenlign metoder og forstyrre innganger for å teste om en forklaring forutsier atferd.
Evaluering og menneskelige faktorer
Evaluer trofasthet – om forklaringen samsvarer med modellen – separat fra plausibilitet for en person. Test stabilitet, sensitivitet, fullstendighet, sparsitet og nytteverdi for en definert oppgave som feilsøking eller klage. Menneskelige studier trenger representative deltakere og bør måle beslutningskvalitet, feiloppdagelse, avhengighet og tid, ikke om brukere sier at et diagram ser tydelig ut. En overbevisende forklaring kan øke tilliten til en feil modell, så grensesnitt må vise usikkerhet, alternativer og begrensninger.
Kontrafaktiske forklaringer bør være gjennomførbare, handlingsbare og ikke anbefale endring av beskyttede eller uforanderlige egenskaper. Forklaringer kan lekke modell‑ eller personlig informasjon og hjelpe angripere med å reversere beslutninger. Bruk tilgangskontroller og minimalisering av output. For regulerte eller høy‑påvirknings‑bruk, behold dataproveniens, modellversjon, terskel og faktisk beslutningslogikk; en generell funksjons‑viktighetsgrafikk kan ikke erstatte en juridisk meningsfull begrunnelse eller menneskelig gjennomgang.
Bruke forklaringer ansvarlig
Velg den enkleste modellen som oppfyller ytelses‑ og driftsbehov, men ikke ofre gyldighet for overfladisk tolkbarhet. Kombiner forklaringer med subgruppe‑testing, robusthetstester, kausal analyse der det er relevant, og resultat‑overvåking. Dokumenter tiltenkt publikum og ugyldige slutninger. Hvis en forklaring endres etter en harmløs forstyrrelse, undersøk før utrulling. Forklarbarhet er bevis om et system under en metode; den er verdifull for feilsøking, tilsyn og kommunikasjon, men den bekrefter ikke sannhet, rettferdighet, sikkerhet eller forståelse.
Arbeidseksempel: forklare en kreditt‑risikomodell
En långiver definerer først publikum og nødvendig begrunnelse: søkere trenger nøyaktige beslutningsfaktorer og en korrigeringsvei, mens utviklere trenger diagnostikk. En kalibrert tolkbar basislinje sammenlignes med en boosted‑modell. Lokale attributter, kontrafaktiske forklaringer og global feil‑analyse testes for trofasthet, stabilitet, korrelert‑funksjons‑atferd og nytteverdi. Forklaringer kan ikke anbefale endring av alder, funksjonshemming eller annen uforanderlig egenskap, og de presenteres ikke som kausale effekter.
Produksjonsbeslutningsregisteret bevarer kilde‑data, funksjonstransformasjon, modell, terskel, policy og menneskelig handling. Søkere kan utfordre feilaktige data og få en meningsfull gjennomgang. Overvåking sjekker resultat‑ og forklaringsstabilitet på tvers av grupper og modelloppdateringer. Hvis en plausibel forklaring endres ved en harmløs funksjons‑forstyrrelse eller utelater en avgjørende policy‑regel, stoppes utrullingen. Forklarbarhet supplerer validering og prosedyre‑rettigheter; den unnskylder ikke et ugyldig mål, diskriminerende resultater eller mangel på ansvarlig menneskelig myndighet.
Implementeringsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer tiltenkte brukere, driftsmiljø, innganger, utganger, avhengigheter, eier og konsekvensen av hver viktig feil. Etabler en reproduserbar basislinje og et versjonert evalueringssett før justering. Test vanlige tilfeller, grensetilstander, feil‑ eller manglende inngang, distribusjons‑skifte, avhengighets‑nedbrudd, misbruk, og gruppene eller miljøene som mest sannsynlig blir underbetjent. Mål oppgavekvalitet sammen med kalibrering eller usikkerhet, latens, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig reviewer kan reprodusere resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåking med bevisst injiserte feil. Operasjonell telemetri bør avdekke inngangskvalitet, output‑atferd, modell‑ eller regelversjon, avhengighets‑helse, menneskelige overstyringer og bekreftede resultater uten å samle unødvendige sensitive data. Definer varslings‑terskler og en ansvarlig for respons, og gjennomgå virkelige bevis etter utrulling i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, policies, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelses‑læring, sletting‑ og lagringsprosedyrer, samt et klart tidspunkt for når det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Er oppmerksomhetskart forklaringer?
De kan være diagnostiske signaler, men oppmerksomhetsvekter alene er ikke garantert å trofast representere årsakene til en models output.
Krever forklarbar AI en enkel modell?
Ikke alltid. Komplekse modeller kan analyseres med etterfølgende metoder, men disse forklaringene krever uavhengig validering og tydelig angitte begrensninger.
Primære referanser












