Grunnleggende AI
Hva er en forvirringsmatrise?

 Legg til Unite.AI blant dine foretrukne kilder på Google
En forvirringsmatrise er en tabell som teller hvor ofte en klassifiserers prediksjoner er i samsvar med eller avviker fra kjente etiketter. Den viser hvilke klasser som forveksles og gir antallene som brukes til å beregne måleverdier som presisjon, tilbakekalling, spesifisitet og F1. Den er et av de viktigste diagnostiske verktøyene for overvåket læring klassifiseringsproblemer.
Matrisa i seg selv er ikke en enkelt ytelsespoengsum. Den er en strukturert visning av utfall ved et bestemt beslutningsgrense, datasett og klassedefinisjon.
Nøkkelpunkter
- For binær klassifisering er de fire resultatene sann positiv, falsk positiv, falsk negativ og sann negativ.
- Merk alltid aksene: biblioteker og publikasjoner plasserer ikke alltid faktiske og predikerte klasser i samme orientering.
- Nøyaktighet kan skjule alvorlige feil når klassene er ubalanserte.
- Endring av klassifiseringsgrensen endrer forvirringsmatrisen og avveiningen mellom presisjon og tilbakekalling.
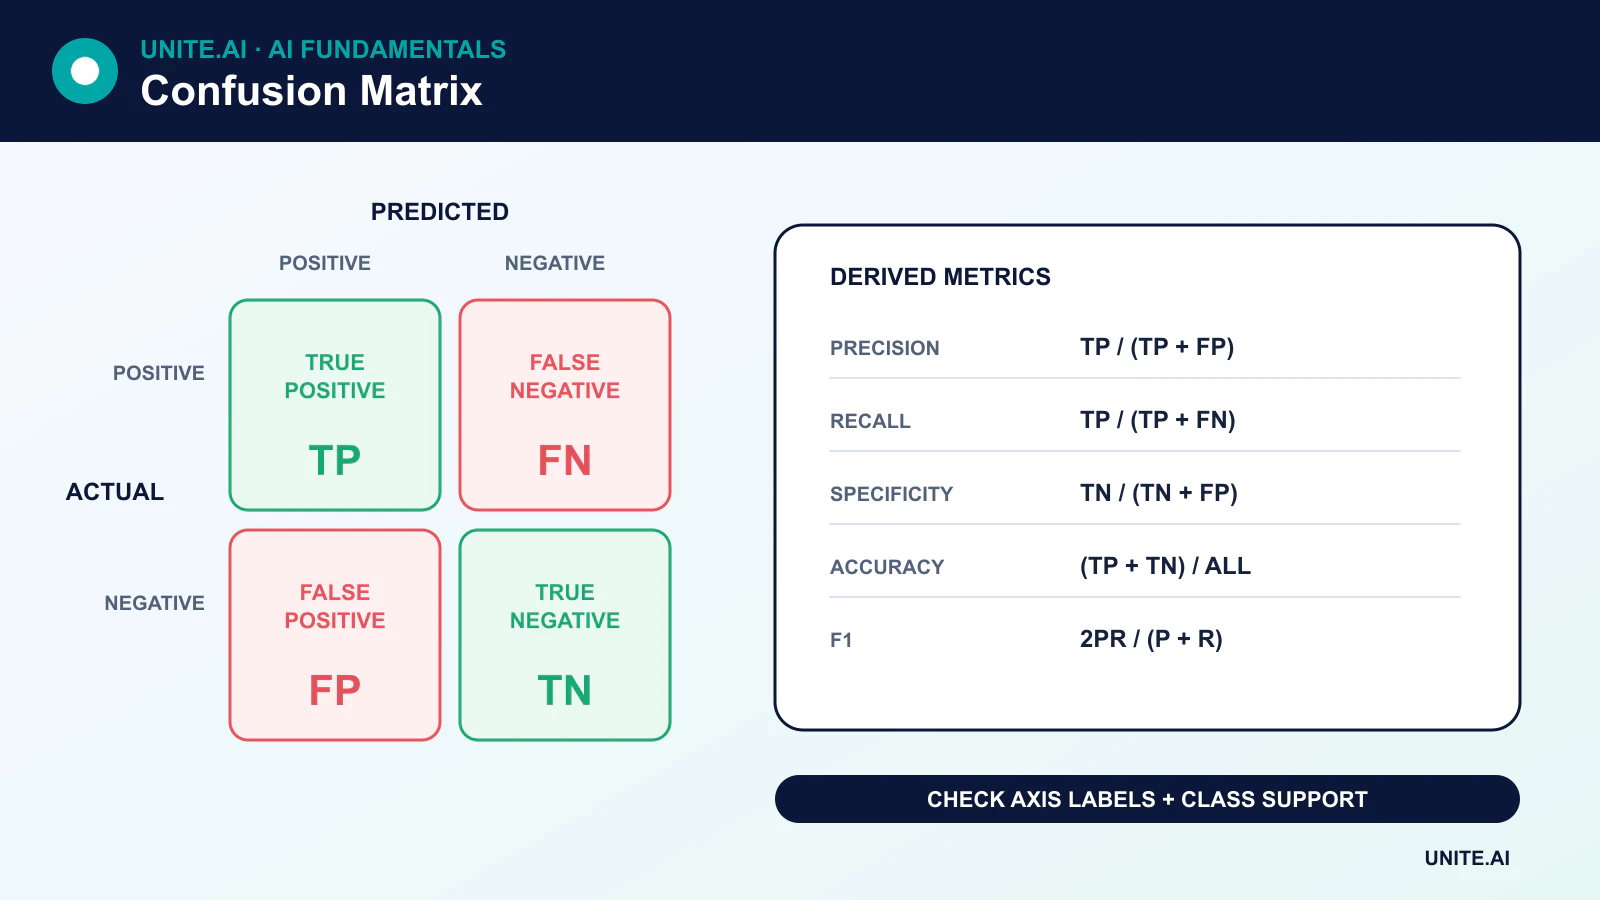
De fire binære klassifiseringsutfallene
- Sann positiv (TP): eksemplet er positivt og modellen predikerer positivt.
- Falsk positiv (FP): eksemplet er negativt, men modellen predikerer positivt.
- Falsk negativ (FN): eksemplet er positivt, men modellen predikerer negativt.
- Sann negativ (TN): eksemplet er negativt og modellen predikerer negativt.
I scikit-learns konvensjon er rader de sanne klassene og kolonner de predikerte klassene. Andre visualiseringer kan transponere dette oppsettet, så etikettene – ikke hjørneposisjonene – bør styre tolkningen.
Måleverdier avledet fra en forvirringsmatrise
Presisjon
Precision = TP / (TP + FP)
Presisjon svarer: blant eksempler som er predikert som positive, hvilken andel var faktisk positive?
Tilbakekalling eller sensitivitet
Recall = TP / (TP + FN)
Tilbakekalling svarer: blant alle faktiske positive eksempler, hvilken andel identifiserte modellen? I binær klassifisering kalles tilbakekalling for den positive klassen også sensitivitet eller sann‑positiv‑rate.
Spesifisitet
Specificity = TN / (TN + FP)
Spesifisitet er tilbakekalling for den negative klassen: blant faktiske negative, hvilken andel avviste modellen korrekt?
Nøyaktighet
Accuracy = (TP + TN) / (TP + TN + FP + FN)
Nøyaktighet er nyttig når klasser og feilkostnader er rimelig balanserte. Den kan være misvisende når én klasse dominerer.
F1‑score
F1 = 2 × (Precision × Recall) / (Precision + Recall)
F1‑score oppsummerer presisjon og tilbakekalling med et harmonisk gjennomsnitt. Den ignorerer sanne negative, så den er ikke den rette oppsummeringen for alle oppgaver.
Et gjennomført eksempel
Anta at et testsett inneholder 1 000 transaksjoner. Femti er svindel. En modell finner 40 av disse svindlene, men flagger 30 legitime transaksjoner:
- TP = 40
- FN = 10
- FP = 30
- TN = 920
Modellen har 96 % nøyaktighet, men presisjonen er omtrent 57 % og tilbakekallingen 80 %. Den høye nøyaktigheten skyldes i stor grad de mange legitime transaksjonene. Om denne modellen er akseptabel avhenger av kostnaden ved savnet svindel, etterforskningskapasiteten og hvor godt risikoscorene er kalibrert.
Grenser endrer matrisen
Mange klassifikatorer gir en score i stedet for et uunngåelig ja/nei-svar. Å senke den positive grensen øker vanligvis tilbakekalling og falske positive; å heve den øker vanligvis presisjon eller spesifisitet samtidig som flere positive går tapt. Grensen bør velges ved hjelp av valideringsdata og reelle feilkostnader, ikke automatisk fastsatt til 0,5.
Presisjon‑tilbakekalling‑ og ROC‑kurver oppsummerer ytelse på tvers av grenser. Presisjon‑tilbakekalling‑kurver er ofte mer informative når den positive klassen er sjelden.
Multiklasse‑forvirringsmatriser
For K klasser er matrisen K × K. Korrekte prediksjoner ligger på diagonalen; celler utenfor diagonalen viser hvilke klassepar som forveksles. Per‑klasse‑måleverdier kan gjennomsnittsberegnes på ulike måter:
- Makro‑gjennomsnitt: gir hver klasse lik vekt.
- Vektet gjennomsnitt: veier hver klasse etter antall eksempler.
- Mikro‑gjennomsnitt: aggregerer resultatantall før beregning av måleverdien.
Å rapportere kun ett gjennomsnitt kan skjule dårlig ytelse på mindre klasser. Inkluder støtteantall og per‑klasse‑resultater der forskjellene er viktige.
Vanlige feil
- Å lese en transponert matrise uten å sjekke akseetikettene.
- Å beregne måleverdier fra treningsdata i stedet for et passende hold‑out‑sett.
- Å ignorere klasseforekomst, prøvetakingsstrategi eller dupliserte enheter på tvers av delinger.
- Å sammenligne matriser laget ved ulike grenser uten å merke endringen.
- Å behandle alle falske positive og falske negative som like kostbare.
En forvirringsmatrise er derfor et diagnostisk verktøy, ikke en fullstendig evaluering. Kalibrering, undergruppeanalyse, robusthet og etterfølgende konsekvenser hører også til i en klassifiseringsgjennomgang.
Lese hver celle og avlede nyttige måleverdier
For binær klassifisering teller forvirringsmatrisen sanne positive, falske positive, falske negative og sanne negative for en valgt positiv klasse og grense. Nøyaktighet deler korrekte prediksjoner på alle tilfeller; presisjon spør hvilken andel av predikerte positive som var korrekte; tilbakekalling spør hvilken andel av faktiske positive som ble funnet; spesifisitet måler faktiske negative som ble korrekt avvist. F1 er det harmoniske gjennomsnittet av presisjon og tilbakekalling. Ingen er iboende best: svindelfiltrering, medisinsk triage og spam‑filtrering tilordner ulike konsekvenser til de samme cellene.
For flerklasse‑problemer representerer rader vanligvis faktiske klasser og kolonner predikerte klasser, selv om konvensjonene varierer, så etikettene må være eksplisitte. En‑mot‑rest‑tellinger gir per‑klasse‑presisjon og tilbakekalling. Makro‑gjennomsnitt veier klasser likt; mikro‑gjennomsnitt aggregerer beslutninger og favoriserer vanlige klasser; vektet gjennomsnitt følger klasse‑støtte. Multietikett‑oppgaver tillater flere etiketter per element og krever etikett‑vise eller prøve‑vise definisjoner. Normaliser etter rad for å inspisere tilbakekallingsmønstre eller etter kolonne for å inspisere prediksjonssammensetning, men behold råtall slik at sjeldne grupper ikke blir visuelt overdrevet.
Grenser, usikkerhet og operative beslutninger
En forvirringsmatrise oppsummerer harde beslutninger ved én grense. Bruk presisjon‑tilbakekalling‑ eller ROC‑kurver for å sammenligne grenser, og velg deretter et operasjonspunkt basert på kapasitet, forekomst og feilkostnad. Kalibrering spør om de predikerte sannsynlighetene samsvarer med observerte frekvenser og er adskilt fra rangering. Når forekomsten endres, kan presisjonen endres selv om sensitivitet og spesifisitet forblir stabile. Rapporter konfidensintervaller eller bootstrap‑variasjon, og unngå å trekke konklusjoner fra noen få feil i en liten undergruppe.
Revider matriser etter tid, sted, enhet, språk og relevante berørte grupper for å finne konsentrerte feil. Sammenlign modellen med den eksisterende beslutningsprosessen, inkludert menneskelig gjennomgang. For kjeder, registrer feil på hvert stadium: innhenting, klassifisering, grensefastsettelse og handling. Overvåk levende resultatetiketter med deres forsinkelse og korrigeringsprosess. En tilsynelatende forbedret F1 kan fortsatt øke skadelige falske negative eller overskride gjennomgangskapasiteten. Forvirringsmatrisen er en beslutningsbok; koble hver celle til hvem som opplever feilen og hvilken respons som følger.
Gjennomført eksempel: valg av medisinsk screening‑grense
En maskinlærings-screeningsmodell gir en risikoscore for en tilstand med lav forekomst. Teamet lager forvirringsmatriser på tvers av grenser og rapporterer sensitivitet, spesifisitet, presisjon, falske henvisninger og savnede tilfeller med konfidensintervaller. Siden positiv prediktiv verdi avhenger av forekomst, modellerer den den tiltenkte befolkningen i stedet for å sitere én datasett‑presisjon. Resultatene er segmentert etter enhet, sted, alder, kjønn og andre klinisk begrunnede grupper.
Klinikere velger et operasjonspunkt som bevarer nødvendig sensitivitet uten å overvelde bekreftende tester. Matrisen oversettes til forventede antall per 10 000 screenede personer slik at konsekvensene er forståelige. Score utenfor validerte forhold gir ingen automatisert konklusjon. Overvåking sammenligner prediksjoner med forsinkede bekreftede diagnoser, sporer kapasitet og kalibrering, og utløser gjennomgang når forekomst eller innhenting endres. Forvirringsmatrisen forblir knyttet til den eksakte modellen, grensen og befolkningen.
Implementeringsbevis og operativ beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, innganger, utganger, avhengigheter, eier og konsekvensen av hver viktig feil. Etabler en reproducerbar basislinje og et versjonert evalueringssett før justering. Test vanlige tilfeller, grensetilstander, feilformet eller manglende input, distribusjonsendring, avhengighetsnedbrudd, misbruk, og gruppene eller miljøene som mest sannsynlig blir underbetjent. Mål oppgavens kvalitet sammen med kalibrering eller usikkerhet, latency, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og grense slik at en uavhengig vurderer kan reprodusere resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, behold en sikker tilbakefallsløsning, og verifiser overvåkning med bevisst injiserte feil. Operativ telemetri bør avsløre inndata‑kvalitet, utdata‑atferd, modell‑ eller regelversjon, avhengighetshelse, menneskelige overstyringer og bekreftede resultater uten å samle unødvendige sensitive data. Definer varselgrenser og en ansvarlig for respons, og gjennomgå virkelige bevis etter utrulling i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, retningslinjer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelseslæring, slettings‑ og lagringsprosedyrer, og et klart punkt der det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Hva er en normalisert forvirringsmatrise?
Normalisering deler antallene på totalen for den sanne klassen, den predikerte klasse‑totalen eller alle observasjoner. Det gjør rater lettere å sammenligne på tvers av klasser, men rapporten bør også beholde rå støtte‑antall slik at små grupper ikke forveksles med like store.
Kan en forvirringsmatrise evaluere regresjon?
Ikke direkte. En forvirringsmatrise krever diskrete klasser. Å gruppere et kontinuerlig mål i binner kaster bort informasjon; regresjon bør normalt bruke residualanalyse og måleverdier designet for kontinuerlige verdier, som MAE eller RMSE.
Primære referanser