
Grunnleggende AI
Hva er lineær regresjon?

 Legg til Unite.AI blant dine foretrukne kilder på Google
Lineær regresjon modellerer et kontinuerlig mål som en lineær kombinasjon av én eller flere inndata‑funksjoner. Den brukes til prediksjon, estimering og som en gjennomsiktig basis for å forstå om en mer komplisert modell tilfører meningsfull verdi.
Ordene uavhengig variabel og avhengig variabel beskriver roller i modellen, ikke påvist årsak‑virkning. En regresjon kan identifisere en assosiasjon mens konfunderende faktorer, seleksjonsbias, omvendt årsakssammenheng eller målefeil forklarer forholdet.
Viktige poeng
- Målet y modelleres fra inndata‑funksjoner X; artikkelens eldre versjon snudde disse etikettene i en formelforklaring.
- Vanlige minste kvadrater minimerer summen av kvadrerte residualer.
- Residualdiagnostikk og antakelser er viktige for inferens og usikkerhet.
- Ridge‑ og lasso‑regularisering hjelper når prediktorene er mange eller korrelerte.
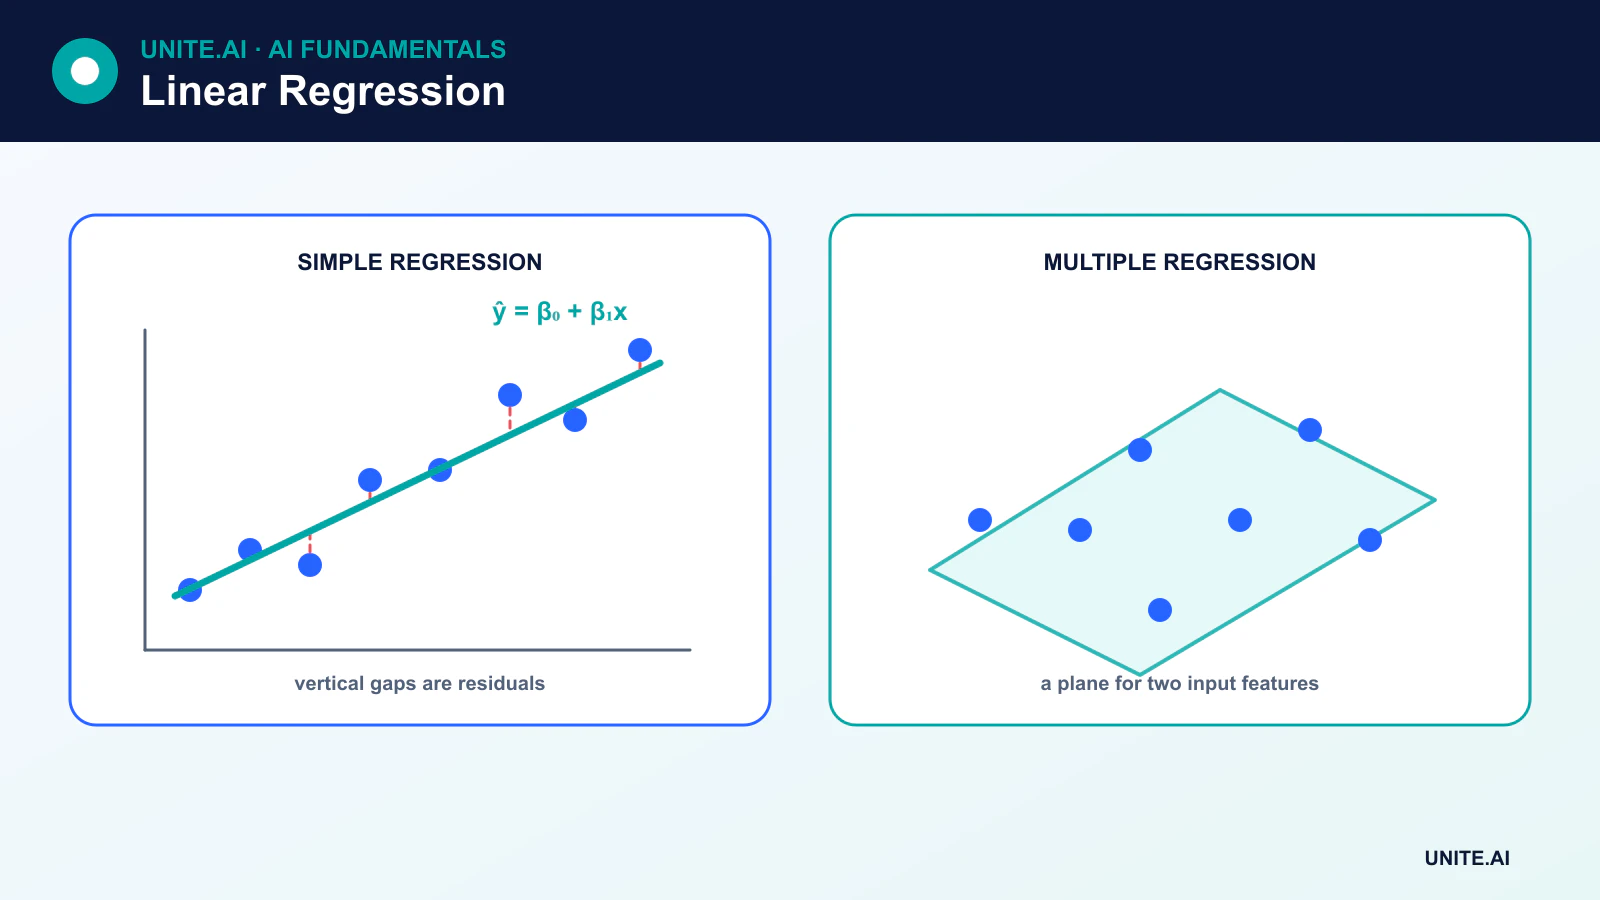
Enkel lineær regresjon
Med én funksjon er modellen:
ŷ = β₀ + β₁x
β₀ er skjæringspunktet og β₁ er stigningen. Residualen for observasjon i er yᵢ - ŷᵢ. Vanlige minste kvadrater (OLS) velger koeffisienter som minimerer summen av kvadrerte residualer.
Stigningen estimerer den forventede endringen i målet som er assosiert med en enhetsendring i funksjonen under den tilpassede modellen. Den bør ikke beskrives som en kausal effekt med mindre studiedesign og antakelser støtter kausal identifikasjon.
Multipel lineær regresjon
Med p funksjoner:
ŷ = β₀ + β₁x₁ + β₂x₂ + … + βₚxₚ
Hver koeffisient tolkes betinget på de andre inkluderte funksjonene. Multipel regresjon kan innlemme kategoriske variabler gjennom koding, polynomiale termer og interaksjoner. Den forblir «lineær» fordi den er lineær i koeffisientene, selv om transformerte funksjoner som x² er inkludert.
Antakelser og diagnostikk
For prediksjon er hovedspørsmålet hvor godt modellen generaliserer. For klassiske koeffisienttester og intervaller blir ytterligere antakelser viktige:
- Linearitet: den betingede gjennomsnittet representeres av den valgte lineære formen.
- Uavhengige eller korrekt modellerte feil: gjentatte, grupperte, romlige eller tidsseriedata kan kreve en annen feilstruktur.
- Konstant feilvarians: heteroskedastisitet påvirker standardfeil og usikkerhetsestimater.
- Begrenset multikollinearitet: sterkt korrelerte prediktorer gjør individuelle koeffisienter ustabile.
- Residualfordeling: normalitet er relevant for noen småprøve‑inferenser, men ikke et krav om at hver funksjon er normalfordelt.
Residualplott, leveranse‑ og påvirkningsmål, og domenegjennomgang kan identifisere avvik, ikke‑linearitet, varierende varians eller observasjoner som dominerer tilpasningen.
Evaluering av prediksjoner
- Mean absolute error (MAE): gjennomsnittlig absolutt residualstørrelse.
- Mean squared error (MSE): gir større feil mer vekt.
- Root mean squared error (RMSE): returnerer kvadrert feil til målenheter.
- R²: sammenligner residualvariasjon med en konstant basislinje på de evaluerte dataene.
R² er ikke nøyaktighet, etablerer ikke kausalitet, og kan være negativ på hold‑out‑data. Validering bør tilsvare den faktiske prediksjonsinnstillingen, inkludert tids‑ eller gruppe‑bevisste oppdelinger når nødvendig.
Ridge, lasso og elastic net
Ridge‑regresjon legger til en L2‑straff som krymper koeffisienter og stabiliserer korrelerte prediktorer. Lasso legger til en L1‑straff og kan sette koeffisienter til null. Elastic net kombinerer begge. Funksjoner trenger vanligvis kompatibel skalering før disse straffene sammenlignes.
Regularisering introduserer bias i bytte for lavere varians og kan redusere overfitting. Straffens styrke velges med validering, ikke med det endelige testsettet.
Når lineær regresjon er feil verktøy
En lineær modell kan svikte når forhold er sterkt ikke‑lineære, feil avhenger av tidligere verdier, målfordelinger krever spesialisert modellering, eller noen få avvik dominerer kvadratisk tap. Decision trees, generaliserte lineære modeller, tidsseriemodeller, robust regresjon, eller ikke‑lineære metoder kan passe bedre.
Selv når en kompleks modell vinner, forblir lineær regresjon et verdifullt grunnlag. Hvis et stort system ikke kan overgå den pålitelig, kan den ekstra kompleksiteten være uberettiget.
Modellantakelser, estimering og diagnostikk
Lineær regresjon modellerer den betingede gjennomsnittet av et numerisk utfall som et skjæringspunkt pluss vektede prediktorer. Vanlige minste kvadrater velger koeffisienter som minimerer kvadrerte residualer. Koeffisienter beskriver den forventede endringen i utfallet for en enhetsendring i prediktoren mens andre inkluderte variabler holdes konstante, under den spesifiserte modellen. Dette er en assosiasjon med mindre kausale identifikasjonsantakelser og studiedesign rettferdiggjør mer. Enheter, koding, transformasjoner, interaksjoner og referansekategorier bestemmer tolkning, så koeffisienter uten en datadictionary er ufullstendige.
Klassisk inferens baserer seg på antakelser om funksjonsform, uavhengige feil, konstant varians og feilfordeling for spesifikke tester og intervaller. Residual‑versus‑tilpassede plott avslører ikke‑linearitet eller heteroskedastisitet; Q–Q‑plott vurderer hale‑atferd; leveranse‑ og påvirkningsdiagnostikk identifiserer observasjoner som sterkt påvirker estimater. Korrelerte prediktorer øker usikkerhet og gjør individuelle koeffisienter ustabile selv om prediksjoner forblir tilstrekkelige. Robuste standardfeil, transformasjoner, splines, hierarkisk struktur eller en annen modell kan være nødvendig i stedet for å slette upraktiske datapunkter.
Regularisering, evaluering og ansvarlig bruk
Ridge‑regresjon krymper koeffisienter med en L2‑straff, mens lasso kan sette noen til null med en L1‑straff; elastic net kombinerer dem. Standardiser prediktorer når straffeskalaen skal være sammenlignbar og velg styrke ved hjelp av validering eller kryss‑validering. Evaluer mean absolute error, root mean squared error, residualfordeling, kalibrering på tvers av områder, og usikkerhet, med tids‑ eller gruppe‑oppdelinger som reflekterer bruk. Sammenlign med en gjennomsnittlig basislinje og ikke‑lineære alternativer, men behold lineære modeller når gjennomsiktighet og stabilitet er verdifullt.
Ekstrapolasjon utenfor det observerte prediktorrange følger den tilpassede linjen uten bevis og kan være farlig. Overvåk funksjonsområder, manglende verdier, residualer og undergruppefeil i produksjon. Prediksjonsintervaller beskriver individuell resultatusikkerhet og er bredere enn konfidensintervaller for gjennomsnittet; begge krever antakelser. Unngå å kontrollere for variabler som introduserer kausal bias når målet er effektestimering. Lineær regresjon er et presist verktøy for et definert forhold, ikke en universell garanti for at verden er lineær eller at en koeffisient representerer en intervensjon.
Arbeidseksempel: estimering av leveringstid
Et logistikkteam modellerer leveringstid fra avstand, servicenivå, region, ukedag og kjent vær. De inspiserer ikke‑lineære residualmønstre og legger til begrunnede splines og interaksjoner i stedet for å behandle en lineær ligning som bokstavelig fysikk. Transportør‑ og rutegrupper definerer valideringsfold. Mean absolute error, tail error, interval coverage og systematisk bias rapporteres. Avlyste leveranser og data registrert etter ankomst ekskluderes eller modelleres eksplisitt.
Koeffisienter dokumenteres i enheter og sjekkes for ustabilitet under korrelerte prediktorer. Modellen nekter ekstrapolasjon utenfor validerte avstands‑ og regionområder. Prediksjonsintervaller følger estimatene, og nedstrøms planlegging bruker deres usikkerhet. Overvåking sporer funksjonsområder, residualer, intervalldekning og bias etter nettverksendringer. Et kausalt påstand om transportør eller vær gjøres ikke fra prediktive koeffisienter; operative eksperimenter eller sterkere identifikasjon ville være nødvendig for å støtte intervensjon.
Implementasjonsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, inndata, utdata, avhengigheter, eier, og konsekvensen av hver viktig feil. Etabler en reproduserbar basislinje og et versjonert evalueringssett før tuning. Test vanlige tilfeller, grensebetingelser, feilformatert eller manglende inndata, distribusjonsendring, avhengighetsnedbrudd, misbruk, og gruppene eller miljøene som mest sannsynlig er underbetjent. Mål oppgavekvalitet sammen med kalibrering eller usikkerhet, latenstid, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig gjennomleser kan reprodusere resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåking med bevisst injiserte feil. Operasjonell telemetri bør avdekke inndatakvalitet, utdataatferd, modell‑ eller regelversjon, avhengighetshelse, menneskelige overstyringer og bekreftede resultater uten å samle unødvendige sensitive data. Definer varslingsgrenser og en responsansvarlig, og gjennomgå virkelige bevis etter distribusjon i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, retningslinjer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelseslæring, sletting‑ og oppbevaringsprosedyrer, og et klart punkt hvor det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Krever lineær regresjon kun én inndata‑variabel?
Nei. En enkel regresjon har én prediktor, mens multipel lineær regresjon kan bruke mange numeriske, kodede kategoriske, transformerede og interaksjons‑funksjoner.
Kan lineær regresjon bevise kausalitet?
Nei. Kausal tolkning krever et forsvarlig forskningsdesign og antakelser om konfunderende faktorer, seleksjon, måling og intervensjon. En prediktiv koeffisient alene beskriver en assosiasjon i den tilpassede modellen.
Primære referanser












