
Grunnleggende AI
Hva er Bayes’ teorem?

 Legg til Unite.AI blant dine foretrukne kilder på Google
Bayes’ teorem beskriver hvordan man oppdaterer sannsynligheten for en hypotese etter å ha observert bevis. Den knytter sannsynligheten for bevis gitt en hypotese til sannsynligheten for hypotesen gitt det beviset.
Dette skillet er sentralt i statistisk resonnering og maskinlæring. En test kan være svært nøyaktig når en tilstand er tilstede, mens et positivt resultat fortsatt har en beskjeden sannsynlighet for å indikere tilstanden dersom tilstanden er sjelden.
Viktige punkter
- Posterioren kombinerer en a priori‑tro med sannsynligheten for observerte bevis.
- Bevisleddet normaliserer de mulige hypotesene.
- Basisrater kan dominere tilsynelatende sterk bevis.
- Naiv Bayes antar at funksjonene er betinget uavhengige gitt klassen, ikke uavhengige i alle situasjoner.
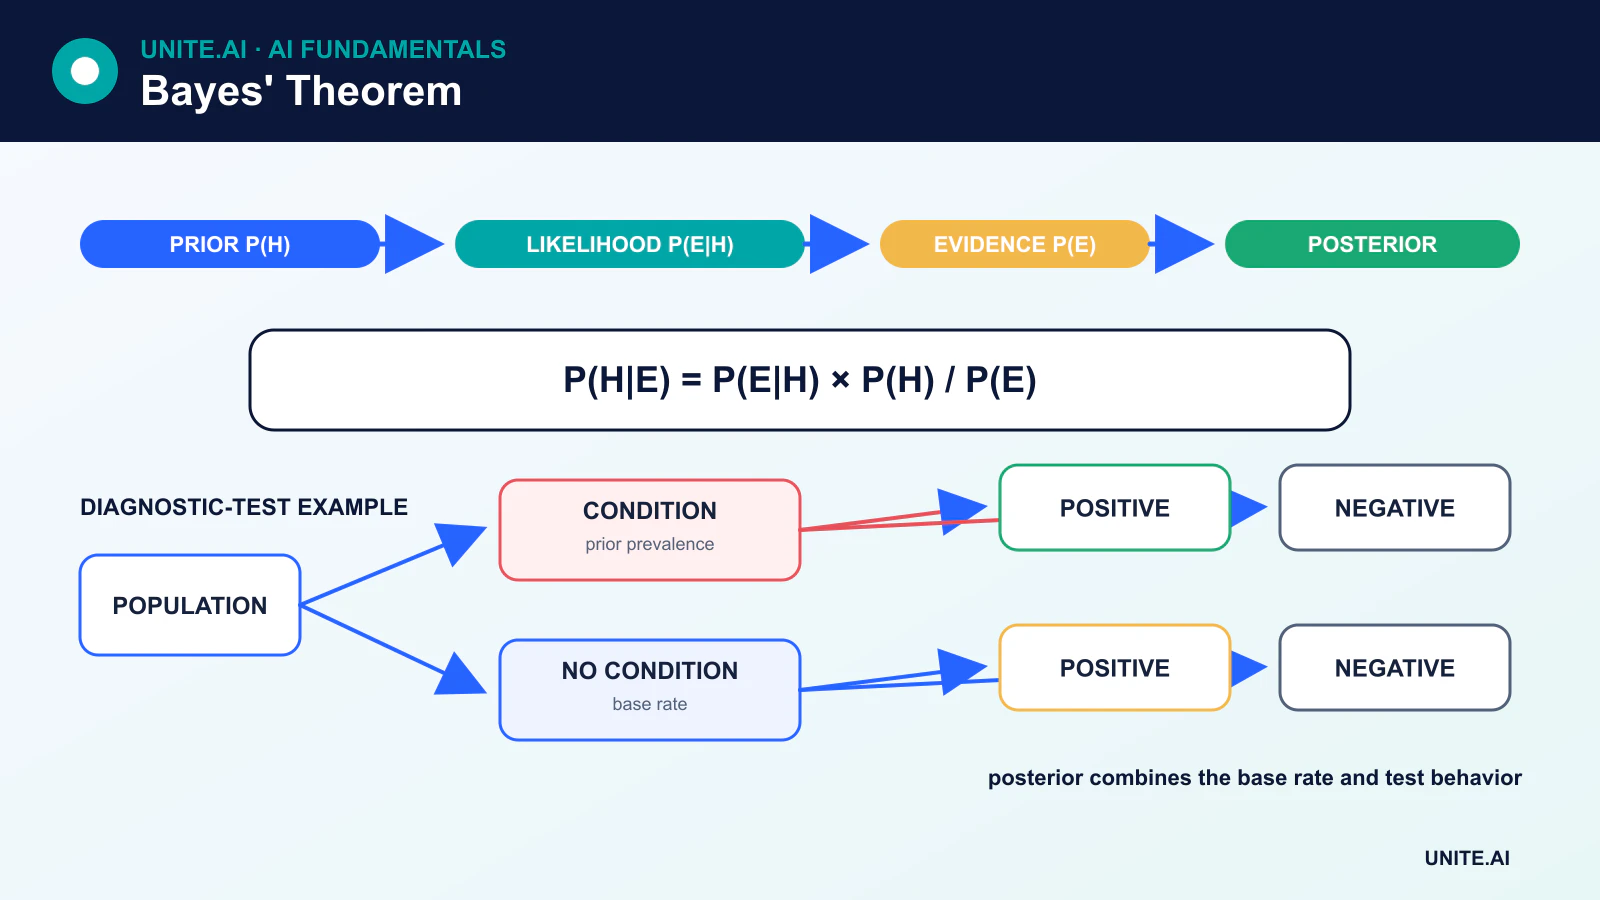
Formelen
P(A|B) = P(B|A)P(A) / P(B)
- P(A) er den a priori‑sannsynligheten for hypotese A.
- P(B|A) er sannsynligheten for å observere bevis B dersom A er sann.
- P(B) er den samlede sannsynligheten for beviset.
- P(A|B) er posterior‑sannsynligheten for A etter å ha observert B.
Teoremet følger fra to ekvivalente uttrykk for felles sannsynlighet: P(A ∩ B) = P(B|A)P(A) og P(A ∩ B) = P(A|B)P(B).
Et numerisk basisrate‑eksempel
Anta at en tilstand påvirker 1 % av en befolkning. En test har 90 % sensitivitet og 5 % falsk‑positiv rate. Betrakt 1 000 personer:
- Omtrent 10 har tilstanden; testen markerer korrekt 9.
- Omtrent 990 har den ikke; en falsk‑positiv rate på 5 % markerer omtrent 50.
- Det blir derfor omtrent 59 positive resultater, hvorav 9 er sanne positive.
Sannsynligheten for tilstanden etter et positivt resultat er omtrent 9 / 59 ≈ 15%, ikke 90 %. Testens sensitivitet svarer på P(positiv | tilstand); brukeren ønsker vanligvis P(tilstand | positiv). Bayes’ teorem knytter dem sammen ved hjelp av basisraten.
Bayesisk oppdatering
Etter hvert som ny bevis kommer inn, kan en posterior bli a priori for neste oppdatering. En fullstendig Bayesisk modell spesifiserer mulige hypoteser, a priori‑fordelinger, en likelihood og den mengden som skal estimeres. Usikkerhet representeres med en posterior‑fordeling i stedet for kun et punktestimat.
A priori‑fordelingen bør dokumenteres og testes for sensitivitet. En svakt informativ a priori‑fordeling kan regulere urimelige verdier, mens en dårlig valgt sterk a priori‑fordeling kan dominere begrensede data.
Naiv Bayes‑klassifikatorer
Naiv Bayes forutsier en klasse y fra funksjonene x₁ … xₙ ved bruk av Bayes’ teorem og antagelsen:
P(x₁, …, xₙ | y) = Π P(xᵢ | y)
Funksjonene antas å være betinget uavhengige etter at klassen er kjent. Dette er ofte urealistisk, men klassifikatoren kan fungere godt når de resulterende klassetallene fortsatt er nyttige.
Vanlige varianter
- Multinomial Naive Bayes modellerer telle‑lignende funksjoner og er vanlig i dokumentklassifisering.
- Bernoulli Naive Bayes modellerer binær tilstedeværelse av funksjoner.
- Gaussian Naive Bayes modellerer hver kontinuerlig funksjon med en klasse‑betinget Gaussisk fordeling.
- Categorical Naive Bayes modellerer diskrete kategorier.
Glatting og numerisk stabilitet
Hvis en funksjonsverdi aldri forekommer med en klasse i treningen, kan et usmurt sannsynlighetsestimat bli null og eliminere hele produktet. Additiv eller Laplace‑lignende glatting forhindrer dette. Implementasjoner beregner log‑sannsynligheter slik at multiplikasjon av mange små verdier blir addisjon av stabile log‑verdier.
Sannsynligheter, poeng og kalibrering
Naiv Bayes‑sannsynlighetsutdata kan være dårlig kalibrert fordi korrelerte funksjoner effektivt telles flere ganger. En klassifikator kan rangere klasser godt samtidig som den overvurderer selvtilliten. Kalibrering bør evalueres på hold‑out‑data når sannsynligheter styrer beslutninger.
Bayes utover Naiv Bayes
Bayesisk inferens støtter hierarkiske modeller, A/B‑tester, vitenskapelig parameterestimering, prognostisering, usikkerhetsbevisst beslutningstaking og probabilistiske grafiske modeller. Approximate metoder som Markov‑kjede‑Monte‑Carlo og variational inference brukes når en posterior ikke kan beregnes i lukket form.
Vanlige resonneringsfeil
- Forveksle
P(A|B)medP(B|A). - Ignorere en sjelden eller vanlig basisrate.
- Behandle en a priori‑fordeling som objektiv eller la den være udokumentert.
- Anta at en høy likelihood automatisk innebærer en høy posterior.
- Tolke en prediktiv assosiasjon som årsakssammenheng.
Betinget sannsynlighet, odds og bevis
Bayes’ teorem knytter sannsynligheten for en hypotese etter bevis til dens a priori‑sannsynlighet, likelihooden for å observere beviset under hypotesen, og den totale sannsynligheten for beviset. I odds‑form er posterior‑odds lik a priori‑odds multiplisert med en likelihood‑ratio. Dette skiller hva som ble antatt før en test fra hvor sterkt testen skiller hypotesene. En tilsynelatende svært nøyaktig test kan fortsatt gi mange falske positive når tilstanden er sjelden, fordi basisraten påvirker posterioren.
Likelihood er en funksjon av hypotesen for faste observerte data og skal ikke forveksles med sannsynligheten for hypotesen. Normalisering av bevis summerer eller integrerer over konkurrerende hypoteser. Antakelser om betinget uavhengighet kan forenkle beregning, som i Naiv Bayes, men må kontrolleres mot konsekvensene. Flere bevisstykker kan ikke multipliseres som uavhengige når de deler årsaker eller dupliserer informasjon. Kausal retning spiller også inn: P(bevis|hypotese) er ikke generelt P(hypotese|bevis), den klassiske invers‑sannsynlighetsfeilen.
Modelleringsvalg, beregning og beslutningsbruk
Bayesisk analyse spesifiserer en a priori‑fordeling, en likelihood og en posterior‑prediktiv fordeling. A priori‑fordelinger kan kode etablert kunnskap, regulere små utvalg, eller være svakt informative; de bør begrunnes og testes gjennom sensitivitetsanalyse. Konjugerte modeller gir analytiske oppdateringer, mens Markov‑kjede‑Monte‑Carlo, variational inference og sekvensielle metoder tilnærmer komplekse posteriorer. Diagnostiser konvergens, effektiv prøvestørrelse, tilnærmingsfeil og plausibiliteten til den a priori‑prediktive fordelingen i stedet for kun å rapportere et posterior‑tall uten beregningskontroller.
En posterior‑sannsynlighet informerer, men velger ikke handlingen alene. Beslutninger krever tap, gevinster, begrensninger og tilgjengelige alternativer. Evaluer probabilistiske modeller med kalibrering, riktige scoringsregler og posterior‑prediktive sjekker på nye data. Oppdater kun med bevis samlet under en modellert prosess; seleksjonsbias og datasett‑skift kan ugyldiggjøre likelihooden. Kommuniser kredible intervaller og antakelser uten å behandle dem som garanterte frekvensintervaller. Bayes’ teorem er eksakt sannsynlighetsalgebra, mens kvaliteten på en Bayesisk konklusjon avhenger av modellen og bevisene som leveres.
Arbeidseksempel: tolke en diagnostisk test
En test har 95 % sensitivitet og 90 % spesifisitet, men tilstanden påvirker kun 1 % av den screenede befolkningen. For 10 000 personer forventes omtrent 95 sanne positive og 990 falske positive, noe som gir en positiv prediksjonsverdi under 9 %. Bayes’ teorem gjør basisrate‑effekten eksplisitt. Beregningen angir befolkning, testterskel og usikkerhet i stedet for å reklamere med sensitivitet som sjansen for at et positivt resultat er korrekt. Dette skillet er også grunnleggende for nøye datavitenskap.
Klinikere oppdaterer sannsynligheten med ekstra bevis kun når avhengighet mellom tester er modellert. En beslutningsterskel innlemmer skade ved oversettelse av sykdom, risiko ved bekreftende test, kostnad og pasientpreferanser. Kalibrering sjekkes i den lokale befolkningen, og endringer i prevalens utløser gjennomgang. Posterioren støtter diskusjon og neste steg; den erstatter ikke bekreftende diagnose. Rapportering bruker naturlige frekvenser og sensitivitetsanalyse slik at pasienter og utøvere kan se hvordan konklusjonen endres under plausible antakelser.
Implementeringsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, innganger, utganger, avhengigheter, eier og konsekvensen av hver viktig feil. Etabler en reproduserbar basislinje og et versjonert evalueringssett før tuning. Test vanlige tilfeller, grensetilstander, feil‑ eller manglende input, distribusjons‑skift, avhengighets‑nedbrudd, feilbruk, og gruppene eller miljøene som mest sannsynlig vil bli underbetjent. Mål oppgavekvalitet sammen med kalibrering eller usikkerhet, latenstid, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig vurderer kan reprodusere resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåkning med bevisst injiserte feil. Operasjonell telemetri bør avdekke input‑kvalitet, output‑adferd, modell‑ eller regelversjon, avhengighets‑helse, menneskelige overstyringer og bekreftede utfall uten å samle unødvendige sensitive data. Definer varslings‑terskler og en responsansvarlig, og gjennomgå virkelige bevis etter distribusjon i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, retningslinjer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelses‑læring, sletting‑ og oppbevaringsprosedyrer, samt et klart punkt hvor det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Hva er forskjellen mellom en likelihood og en sannsynlighet?
Med parametere fastsatt, tildeler en modell sannsynlighet til mulige data. Med observerte data fastsatt, kan det samme uttrykket sees på som en likelihood‑funksjon over mulige parameterverdier. Den numeriske formelen kan stemme mens tolkningen er forskjellig.
Er Naiv Bayes fullstendig Bayesisk inferens?
Den bruker Bayes’ teorem for klassifisering under en sterk betinget‑uavhengighetsmodell. Bredere Bayesisk inferens plasserer fordelinger over ukjente størrelser og resonnerer med en posterior‑fordeling.
Primære referanser












