Grunnleggende AI
Hva er gradientnedstigning?

 Legg til Unite.AI blant dine foretrukne kilder på Google
Gradientnedstigning er en optimaliseringsmetode som justerer modellparametere for å redusere en mål‑funksjon. I trening av nevrale nettverk er dette målet vanligvis et tap beregnet over eksempler. Gradientvektoren peker i retningen av den bratteste lokale økningen, så gradientnedstigning tar et steg i motsatt retning.
Gradienten beskriver lokal sensitivitet; dens størrelse er ikke en direkte måling av hvor raskt en modell «lærer». Faktisk fremdrift avhenger også av læringsraten, krumningen, støy, parametrisering, optimalisererens tilstand og data.
Viktige punkter
- Tilbakepropagering beregner gradienter, mens gradientnedstigning bruker dem til å oppdatere parametere.
- Mini‑batch‑optimalisering er den vanlige praktiske tilnærmingen for dyp læring.
- Læringsraten styrer oppdateringsskalaen og kan følge en plan i stedet for å krympe etter hvert steg.
- Momentum, AdamW, clipping og normalisering adresserer ulike optimaliseringsproblemer.
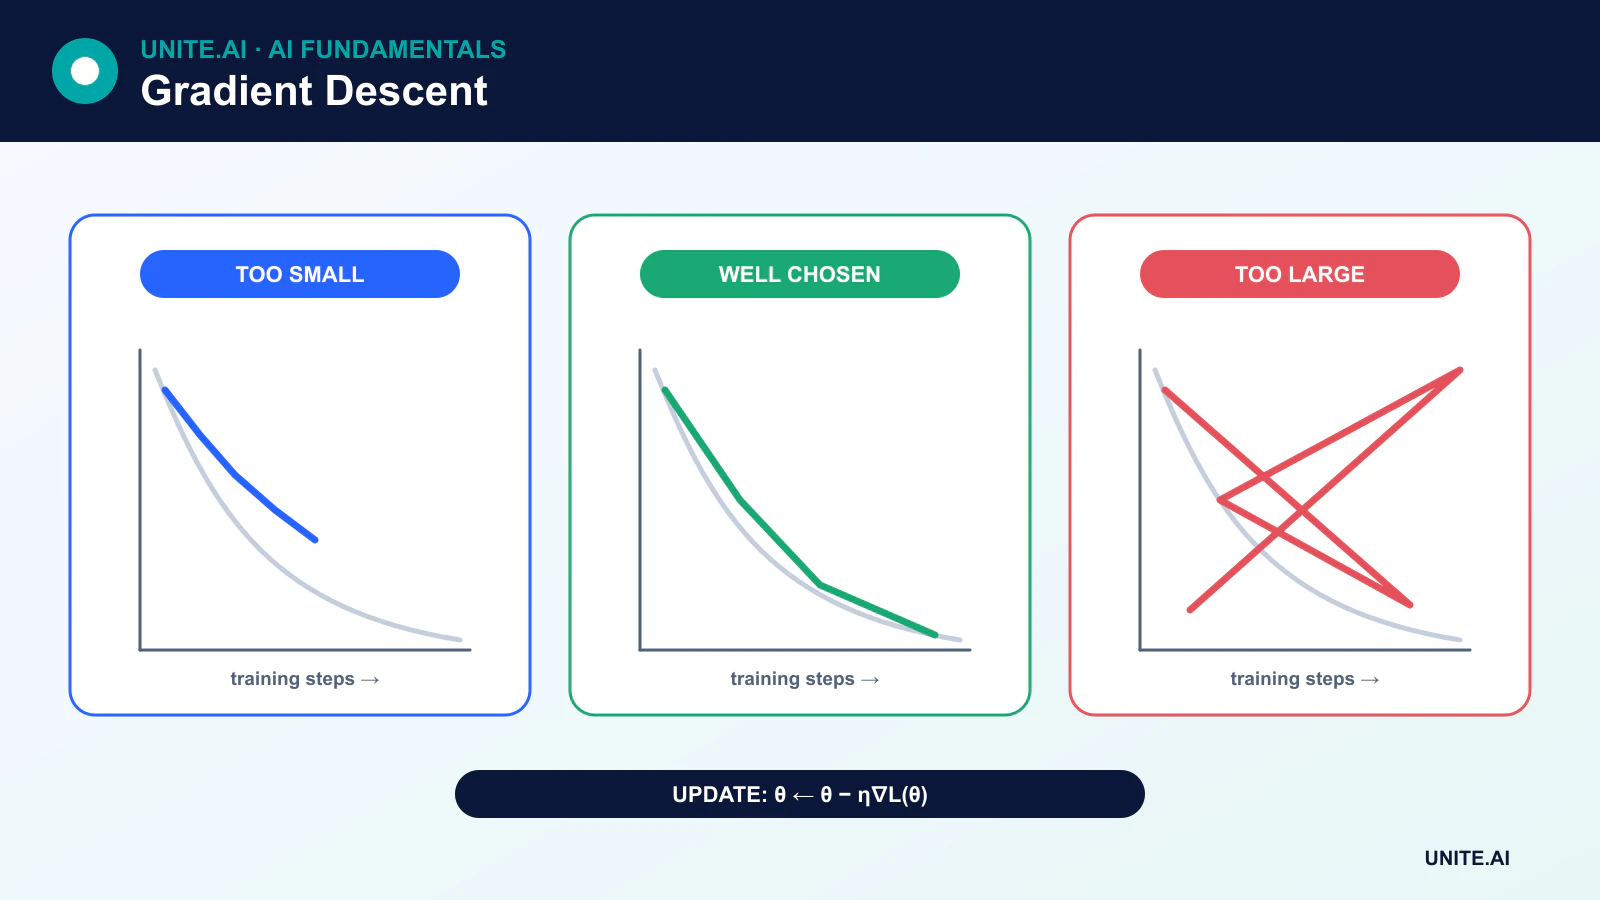
Den grunnleggende oppdateringsregelen
For parametervektor θ, læringsrate η og tap L:
θ ← θ - η∇L(θ)
Gradienten ∇L(θ) inneholder én partiell derivert per parameter. Å trekke den fra flytter lokalt nedover. Et stationært punkt har gradient lik null, men det kan være et minimum, maksimum, sadelpunkt eller en flat region. Tap‑overflater i dyp læring er ikke‑konvekse, så trening garanterer ikke å finne et unikt globalt minimum eller null tap.
Batch‑, stokastisk‑ og mini‑batch‑metoder
Batch‑gradientnedstigning
Batch‑gradientnedstigning beregner en gradient ved å bruke hele treningssettet for hver oppdatering. Estimatet er stabilt, men kan være kostbart i tid og minne, og én oppdatering kan underutnytte moderne akseleratorer.
Stokastisk gradientnedstigning
Streng stokastisk gradientnedstigning bruker ett tilfeldig valgt eksempel per oppdatering. Gradientene er støyende, noe som kan hjelpe utforskning av tapslandskapet, men operasjoner med ett enkelt eksempel kan være ineffektive på parallelt maskinvare.
Mini‑batch‑gradientnedstigning
Mini‑batch‑trening estimerer gradienten fra et delsett av eksempler. Den balanserer statistisk støy med effektive matriseoperasjoner og er den vanlige tilnærmingen i deep learning. Batch‑størrelsen påvirker minne, gjennomstrømning, gradientstøy, normalisering og noen ganger generalisering.
Valg av læringsrate
En rate som er for stor kan overskride nyttige områder eller forårsake divergens. En rate som er for liten kan gjøre treningen upraktisk treg eller sette den fast i flate regioner. Den beste skalaen avhenger av optimalisatoren, batch‑størrelsen, modellen, initialiseringen og målet.
Planer kan varme opp gradvis, avta ved milepæler, følge en cosinuskurve, eller reagere på valideringsfremdrift. Raten trenger ikke å krympe monotont etter hver oppdatering. Varme omstarter og sykliske planer øker den bevisst i deler av treningen.
Momentum
Momentum opprettholder et eksponentielt glidende gjennomsnitt av tidligere gradienter. Det kan akselerere fremdrift langs konsistente retninger og redusere oscillasjon over bratte, smale retninger. Nesterov‑stil momentum evaluerer eller tilnærmer gradienten etter å ha sett fremover langs momentum‑retningen.
Adaptiv optimalisatorer
RMSProp skalerer oppdateringer ved hjelp av et glidende gjennomsnitt av kvadrerte gradienter. Adam kombinerer moment‑lignende første momenter med skalering av andre moment. AdamW frakobler vekt‑nedbrytning fra den adaptive gradient‑oppdateringen og er mye brukt for transformere.
Adaptiv optimalisatorer gjør ofte tidlig trening enklere, men de er ikke automatisk overlegne for hver modell eller slutt‑generalisering. Sammenligninger av optimalisatorer krever matchede planer og nøye justering.
Gradient‑klipping og akkumulering
Gradient‑klipping begrenser en gradientens norm eller verdier for å redusere virkningen av eksploderende gradienter, spesielt i rekurrent eller ustabil trening. Gradient‑akkumulering legger sammen gradienter fra flere mindre batcher før en oppdatering, og etterligner en større effektiv batch når minnet er begrenset.
Overvåking av optimalisering
Følg med på trenings‑ og valideringstap, oppgave‑metrikker, læringsrate, gradientnormer, parameternormer og numeriske feil. Synkende treningstap med forverret valideringsytelse indikerer overtilpasning, ikke en optimaliseringssucces som automatisk bør fortsette.
Optimalisering minimerer målet den får. Et lavt tap beviser ikke at dataene, metrikken eller virkelighetsadferden er passende. Lekkasje, dårlige etiketter og et feiljustert mål kan gi en godt optimalisert, men skadelig modell.
Optimaliseringsgeometri og oppdateringsregler
Gradientnedstigning oppdaterer parametere i motsatt retning av gradienten til et tap. Full‑batch‑nedstigning bruker hvert trenings‑eksempel per steg; stokastisk nedstigning bruker ett; mini‑batch‑metoder estimerer gradienten fra et delsett og dominerer dyp læring. Læringsraten bestemmer stegstørrelsen. For liten sløser med beregning eller stopper; for stor fører til oscillasjon eller divergens. Momentum akkumulerer en bevegelig retning, mens adaptive metoder som Adam skalerer koordinater ved hjelp av gradient‑momenter. Deres ulike implisitte skjevheter kan gi modeller med likt treningstap men ulik generalisering.
Tap‑overflater i nevrale nettverk inneholder flate og skarpe regioner, saddelpunkter, symmetrier og dårlig kondisjonerte retninger. Funksjonsskalering, normalisering, initialisering, residual‑koblinger og pre‑kondisjonering endrer geometrien som optimalisatoren ser. Planer kan varme opp, avta, sykle eller reagere på platåer. Vekt‑nedbrytning er forskjellig fra kun å legge til en L2‑straff i enkelte adaptive optimalisatorer. Batch‑størrelsen påvirker støy, minne, parallellitet og læringsrate‑regimet, så sammenligninger av optimalisatorer krever matchede treningsbudsjetter og nøye justering.
Diagnostikk, reproduserbarhet og stopp
Følg med på trenings‑ og valideringstap, oppgave‑metrikker, gradient‑ og parameternormer, læringsrate, gjennomstrømning og numeriske advarsler. Divergens kan skyldes korrupte batcher, ugyldige etiketter, ustabil blandet presisjon, eller en feilaktig tap‑reduksjon. Platåer kan indikere underkapasitet, mettet aktivering, dårlige funksjoner, overdreven regularisering eller et plan‑problem. Overtilpasning krever data, augmentering, regularisering eller tidlig stopp – ikke en påstand om at optimalisatoren feilet. Undersøk representative feil og sammenlign med en enkel baseline før du øker treningskompleksiteten.
Reproduserbarhet krever frø, datarekkefølge, kode, konfigurasjon, maskinvare‑ og biblioteksversjoner, selv om enkelte akselerator‑kjerner forblir ikke‑deterministiske. Lagre sjekkpunkter med optimaliserer‑ og planlegger‑tilstand slik at treningen kan gjenopptas konsistent. Velg et sjekkpunkt basert på valideringskriterier fastsatt på forhånd og sett av en ubrukt testsett. I distribuert trening, bekreft effektiv batch‑størrelse, gradient‑gjennomsnitt og håndtering av mislykkede arbeidere. Optimalisering minimerer det valgte målet på tilgjengelige data; den garanterer ikke kalibrerte sannsynligheter, kausal resonnering, rettferdighet, sikkerhet eller virkelighetsnytte.
Arbeidseksempel: finjustering av en optimalisator for en språkmodell
Et team fastsetter tokeniserer, datarekkefølge, modell, effektiv batch og budsjett for trenings‑token, og sammenligner deretter SGD med momentum og AdamW over forsvarlige læringsrate‑planer. Oppvarming, avtagning, vekt‑nedbrytning, klipping og presisjon loggføres. Hver kandidat kjøres med flere frø, og valideringen bruker et hold‑ut tidsintervall pluss oppgave‑evalueringer. Gjennomstrømning og energi rapporteres sammen med tap, slik at en litt bedre optimalisator ikke velges til en uforholdsmessig høy kostnad.
Diagnostikk avslører om ustabilitet stammer fra en dataskive, for stor steg‑størrelse, underflyt eller modellarkitektur. Sjekkpunkter bevarer optimaliserer‑ og planlegger‑tilstand og gjenopptas i en test. Det endelige valget baseres på valideringskvalitet og robusthet, ikke lavest treningstap. Et lukket testsett kjøres én gang etter utvelgelse. Produksjons‑infernse er separat kalibrert og overvåket fordi optimaliserer‑suksess under forhåndstrening ikke etablerer sikker eller sannferdig oppførsel.
Implementeringsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, innganger, utganger, avhengigheter, eier og konsekvensen av hver viktig feil. Etabler en reproduserbar basislinje og et versjonert evalueringssett før finjustering. Test vanlige tilfeller, grenseforhold, feil‑ eller manglende inndata, distribusjons‑skifte, avhengighets‑nedbrudd, misbruk, og gruppene eller miljøene som mest sannsynlig blir underbetjent. Mål oppgavekvalitet sammen med kalibrering eller usikkerhet, latens, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig vurderer kan reprodusere resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåkning med bevisst injiserte feil. Operasjonell telemetri bør avsløre inndatakvalitet, utdata‑adferd, modell‑ eller regelversjon, avhengighets‑helse, menneskelige overstyringer og bekreftede resultater uten å samle unødvendige sensitive data. Definer varslings‑terskler og en ansvarlig for respons, og gjennomgå virkelige bevis etter distribusjon i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, policyer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelses‑læring, slettings‑ og lagrings‑prosedyrer, samt et tydelig punkt hvor det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Kommer gradientnedstigning alltid til å nå det globale minimumet?
Nei. For konvekse mål gir passende betingelser sterke garantier. Mål for dype nettverk er ikke‑konvekse, og praktiske optimalisatorer søker vanligvis en nyttig løsning i stedet for å bevise at de har funnet det unike globale minimumet.
Hvorfor kan en null‑gradient være misvisende?
En null‑ eller svært liten gradient kan indikere et minimum, maksimum, sadelpunkt, metning eller flatt platå. Treningsdiagnostikk må ta hensyn til tap‑historikk, krumning, parameter‑skala og valideringsytelse.
Primære referanser