
Grunnleggende AI
Ferdigkjøpte vs. Tilpassede maskinlæringsmodeller

 Legg til Unite.AI blant dine foretrukne kilder på Google
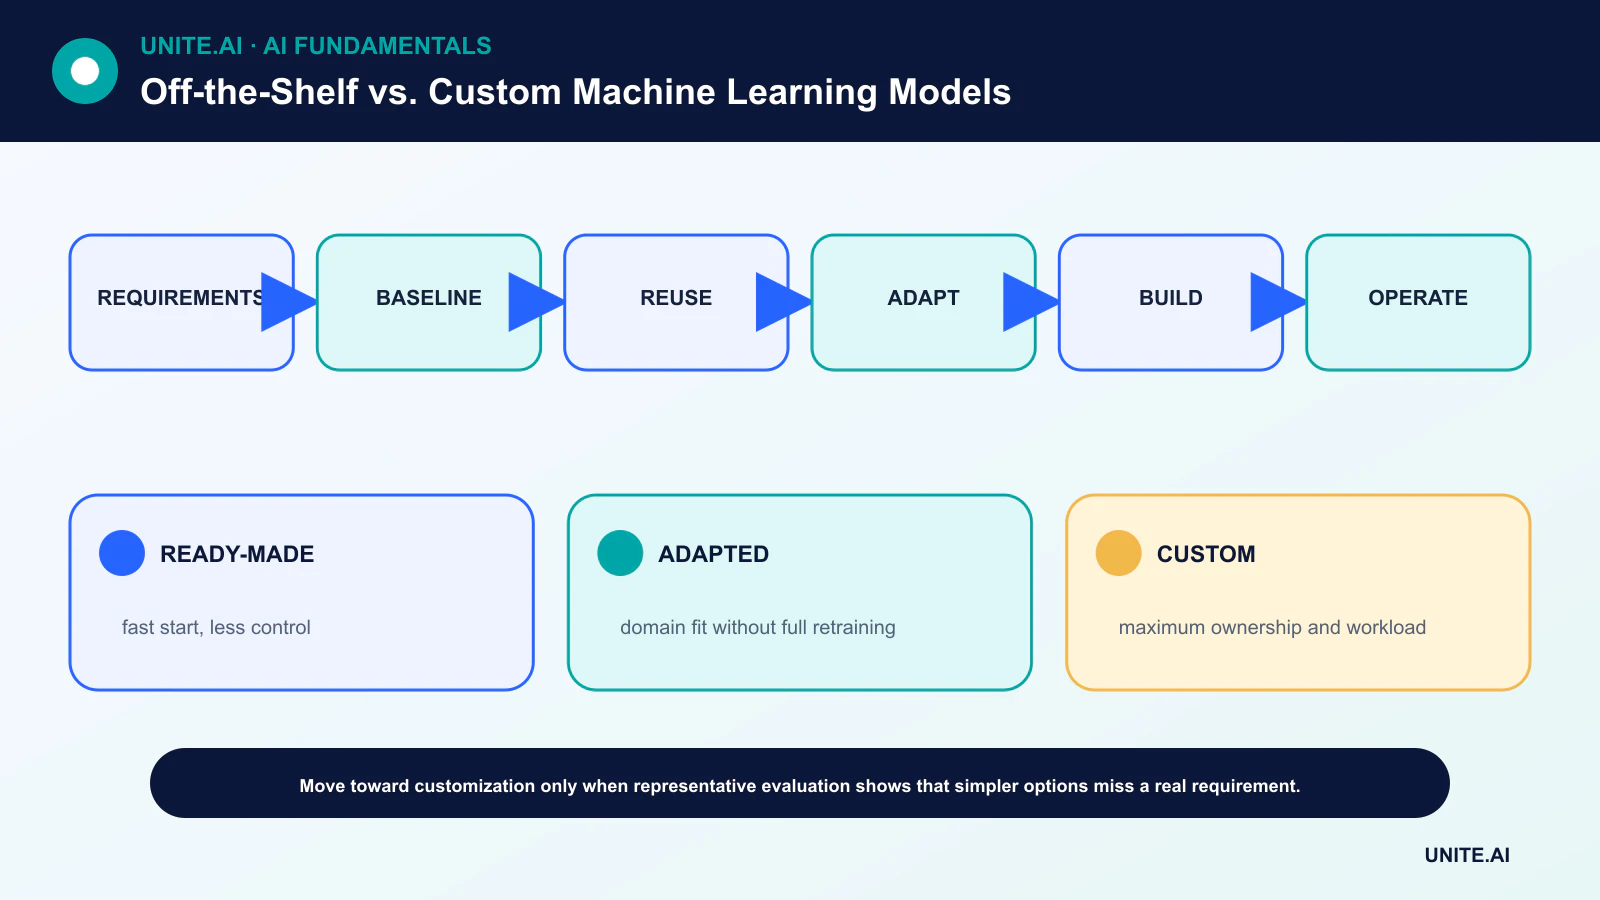
Å velge en maskinlæringsløsning er sjelden en enkel kjøp‑vs‑bygg‑beslutning. Det faktiske kontinuumet spenner fra en hostet API eller pakke‑modell, gjennom prompting, gjenfinning og fin‑tuning, til en fullstendig tilpasset arkitektur trent på organisasjonsspesifikke data.
Den beste løsningen er den minst komplekse tilnærmingen som oppfyller et verifisert produktkrav. En tilpasset modell kan gi kontroll og differensiering, men den medfører også en pågående forpliktelse til å drifte datapipelines, evalueringer, overvåking, sikkerhet, oppdateringer og tilbakeføring.
Viktige punkter
- Start med en målbar oppgave, en ikke‑ML‑baseline og akseptgrenser.
- Evaluer kandidatmodeller på representativ privat data i stedet for kun offentlige benchmark‑resultater.
- Inkluder integrasjon, latens, gjennomgang, om‑trening og hendelseskostnader i total eierkostnad.
- Foretrekk reversible trinn: baseline, gjenfinning eller prompting, fin‑tune, og kun tren fra bunnen av når bevisene støtter det.
Definer beslutningen før du velger en modell
Spesifiser bruker, beslutning, input, output, feilkostnader, latensbudsjett, trafikkmønster og eskaleringsvei. Fastslå om en deterministisk regel eller søkesystem løser tilstrekkelig av problemet. Googles Rules of ML anbefaler enkle baselines og pålitelig infrastruktur før kompleks modellering.
Lag et offline evalueringssett som gjenspeiler produksjon, inkludert sjeldne og adversarielle tilfeller. Når beslutninger påvirker mennesker, definer undergruppe‑kontroller og regler for menneskelig gjennomgang. Disse portene gjør sammenligninger konkrete i stedet for å gjøre arkitekturvalget til en preferanse.
Kontinuum for gjenbruk og tilpasning
En hostet API gir rask integrasjon og administrert skalering, men begrenset kontroll over modellens interne, versjoner og databehandling. En åpen forhåndstrent modell øker distribusjonskontrollen. Gjenfinning eller prompt‑engineering kan legge til domenekontekst uten å endre vekter.
Fin‑tuning eller parameter‑effektive adaptere kan spesialisere oppførselen. Trening fra bunnen av er kun begrunnet når data, mål, skala eller eierskapskrav ikke kan oppfylles gjennom gjenbruk. Transfer‑learning fanger ofte mesteparten av verdien med betydelig mindre data og beregning.
Kvalitet, kontroll og innlåsing
Mål oppgavekvalitet, kalibrering, latens, gjennomstrømning, tilgjengelighet og feil‑konsistens. En leverandørmodell kan forbedres automatisk, men kan også endre oppførsel; en selv‑hostet modell kan låses, men krever at teamet håndterer oppgraderinger og sårbarheter.
Kontraktsvilkår bør dekke datalagring, bruk av trening, regional behandling, immaterielle rettigheter, servicenivåer, eksportveier og avvikling. Portabilitet forbedres når applikasjonen skiller modellspesifikke adaptere fra forretningslogikk og lagrer reproducerbare evalueringsartefakter.
Personvern, sikkerhet og drift
Kartlegg hver datastrøm og trusselgrense. Sensitive input kan kreve privat nettverk, on‑premise‑inferenz eller edge AI. Selv‑hosting gjør ikke automatisk et system trygt; det overfører sikkerhets‑ og etterlevelsesansvar til operatøren.
Produksjonseierskap inkluderer observabilitet, driftskontroller, misbruks‑overvåking, hendelsesrespons og tilbakeføring. Driftsteamet må kunne svare hvilken modell, prompt, dataversjon og policy som produserte et resultat.
Bruk trinnvis bevis, ikke ideologi
Kjør et tidsavgrenset benchmark med samme datasett og akseptkriterier på tvers av alternativer. Estimer ingeniørtid, annotering, akseleratorbruk, leverandøravgifter, gjennomgangsarbeid, feil‑kostnader og forventet endringsfrekvens.
Velg den enkleste kandidaten som passerer portene, og evaluer deretter på nytt når krav eller priser endres. Tilpasning er verdifull når den gir målbar gevinst eller nødvendig kontroll – ikke bare fordi en skreddersydd modell virker strategisk viktig.
Krav- og totalkostnadssammenligning
En ferdigkjøpt modell, API eller pakke‑system gir forhåndsbygget funksjonalitet med leverandørstøtte og raskere første utrulling. En tilpasset modell er trent eller vesentlig tilpasset for en spesifikk oppgave, data og driftsmiljø. Valget begynner med krav: ønsket resultat, kvalitet per undergruppe og kanttilfelle, latens, gjennomstrømning, tilgjengelighet, forklarbarhet, datalokalitet, oppdateringskontroll, integrasjon, sikkerhet og feilkonsekvens. Et generisk benchmark eller demo kan ikke svare på om et produkt oppfyller disse kravene.
Totalkostnad inkluderer evaluering, datapreparering, merking, integrasjon, lisenser eller bruk, infrastruktur, overvåking, gjennomgang, hendelsesrespons, oppgraderinger og exit. Ferdigkjøpte senker initial ingeniørarbeid, men kan skape variable kostnader, innlåsing, endringer i oppførsel og begrenset observabilitet. Tilpasset utvikling legger til ansvar for data og MLOps og kan fortsatt avhenge av forhåndstrente vekter og leverandører. Modellkostnad bør måles per vellykket oppgave med nødvendig kvalitet, ikke per token eller treningskjøring alene.
Evaluering, anskaffelse og tilpasning
Bygg et representativt privat testsett før leverandørvalg og kjør hver kandidat under identiske prompts, forhåndsbehandling, terskler og driftsgrenser. Inkluder tvetydige, adversarielle, ikke‑støttede, flerspråklige og høy‑konsekvens‑tilfeller. Mål nøyaktighet, kalibrering, latens, kostnad, avslag, sikkerhet og påvirkning på menneskelig arbeidsflyt. Test API‑nedetid, hastighetsbegrensninger, regional oppførsel og versjonsendring. Leverandørpåstander krever dokumentasjon for trening, rettigheter, personvern, lagring, underleverandører, sikkerhet, støtte og hendelsesvarsling.
Tilpasningsalternativer danner et spekter: konfigurasjon, gjenfinning, prompting, fin‑tuning, parameter‑effektive oppdateringer, tilpassede hoder eller trening fra bunnen av. Bruk den minst komplekse metoden som oppfyller bevisene. Gjenfinning er egnet for hyppig endrende kunnskap; tuning kan forme format‑ eller domenebehov; deterministisk kode bør håndtere eksakte regler. Valider kombinerte systemer fordi en sterk basismodell fortsatt kan svikte gjennom dårlig gjenfinning, tillatelser eller integrasjon.
Livssyklus og exit-planlegging
Hostede produkter kan endres eller forsvinne, mens tilpassede modeller blir teknisk gjeld uten eiere. Versjonsavhengigheter, overvåk oppførsel og resultater, definer triggere for om‑trening eller revurdering, og oppretthold tilbakeføring. Bevar data og grensesnitt som trengs for migrering, forhandle sletting og eksport, og unngå å eksponere én leverandørs proprietære skjema gjennom hele applikasjonen. Det beste valget kan være hybrid: kommersiell kapasitet for standardoppgaver og tilpassede komponenter der domeneytelse, kontroll eller risiko skaper varig verdi.
Arbeidseksempel: valg av dokumentuttrekksmodell
Et selskap lager et privat testsett av fakturaer fra ulike leverandører, språk, skanninger, håndskrift og kanttilfeller, og sammenligner deretter en administrert API, åpen forhåndstrent modell, tilpasset modell og regel‑baseline. Det vurderer feltnøyaktighet, økonomisk feil, ikke‑støttede dokumenter, latens, gjennomstrømning, personvern, datalokalitet, integrasjon og kostnad per korrekt behandlet faktura. Leverandør‑demoer og offentlige benchmarks erstatter ikke denne matchede evalueringen.
Den valgte hybridløsningen bruker en kommersiell OCR‑tjeneste med lokal validering og menneskelig gjennomgang for lav tillit eller store beløp. Kontrakter definerer lagring, underleverandører, oppdateringer og sletting; arkitekturen bevarer kildefiler og en exit‑vei. En skyggperiode oppdager skjema‑ og leverandørhull. Overvåking skiller OCR, uttrekk, validering og korrektur fra gjennomgangere. Hvis leverandørens oppførsel endres, kan teamet fryse, bytte eller flytte mer arbeid til sin tilpassede komponent uten å omskrive den finansielle arbeidsflyten.
Implementeringsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, input, output, avhengigheter, eier og konsekvensen av hver viktig feil. Etabler en reproducerbar baseline og et versjonert evalueringssett før fin‑tuning. Test vanlige tilfeller, grensebetingelser, feilformatert eller manglende input, distribusjonsendring, avhengighetsnedetid, misbruk, og gruppene eller miljøene som mest sannsynlig blir underbetjent. Mål oppgavekvalitet sammen med kalibrering eller usikkerhet, latens, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig reviewer kan gjenskape resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåking med bevisst injiserte feil. Operasjonell telemetri bør avdekke input‑kvalitet, output‑oppførsel, modell‑ eller regelversjon, avhengighetshelse, menneskelige overstyringer og bekreftede resultater uten å samle unødvendige sensitive data. Definer varsel‑terskler og en ansvarlig for respons, og gjennomgå virkelige bevis etter utrulling i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, policyer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelseslæring, sletting‑ og lagringsprosedyrer, samt et tydelig punkt hvor det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Når bør et team trene en modell fra bunnen av?
Når forhåndstrente eller hostede alternativer ikke kan oppfylle validerte krav og teamet har tilstrekkelig proprietær data, beregningskraft, ekspertise og langsiktig operasjonell kapasitet.
Er en ferdigkjøpt modell vedlikeholdsfrie?
Nei. Integrasjon, evaluering, versjonsendringer, overvåking, personvernkontroller og fallback‑oppførsel forblir adopterens ansvar.
Primære referanser











