
Grunnleggende AI
Hva er overføringslæring?

 Legg til Unite.AI blant dine foretrukne kilder på Google
Overføringslæring gjenbruker kunnskap som er lært for ett problem for å forbedre læring på et relatert problem. I stedet for å initialisere hver parameter tilfeldig, starter en praktiker fra en forhåndstrent modell eller representasjon og tilpasser den til en måloppgave.
Denne tilnærmingen er spesielt nyttig når mål‑datasettet er lite, merking er kostbart, eller forhåndstrening krever mer beregning enn målteamet kan rettferdiggjøre. Å trene en modell fra bunnen av er alternativet til overføringslæring – ikke en type overføringslæring.
Viktige punkter
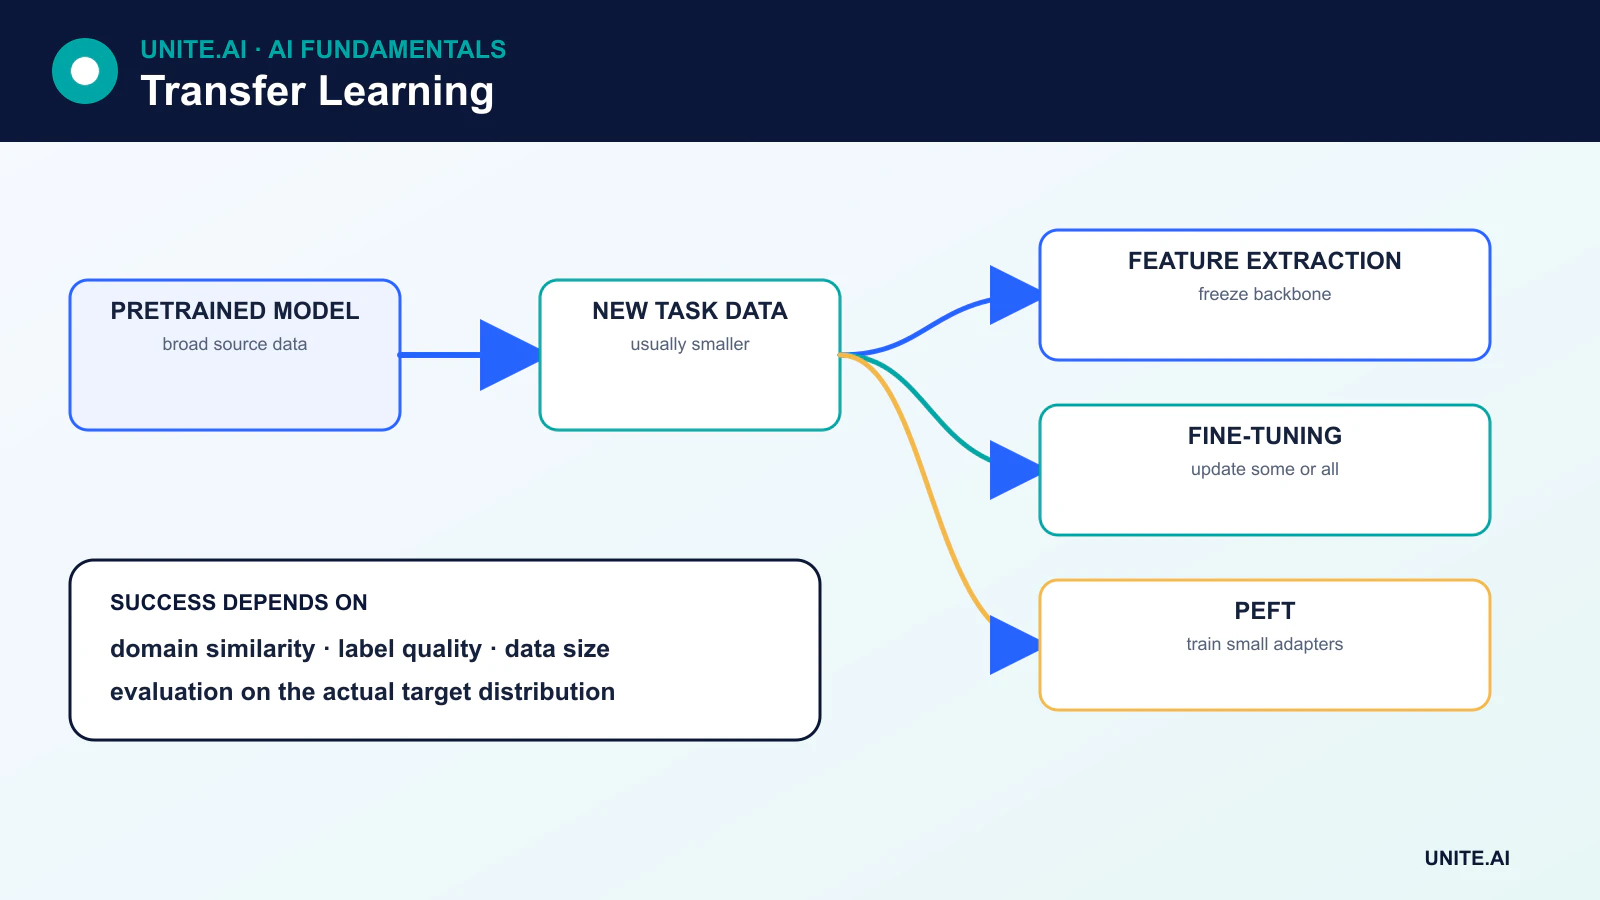
- Funksjonsekstraksjon holder en forhåndstrent base frosset og trener et nytt oppgavespesifikt hode.
- Finjustering oppdaterer noen eller alle forhåndstrente parametere ved hjelp av data fra mål‑domene.
- Parameter‑effektive metoder som adaptere og LoRA oppdaterer en liten del av modellen.
- Overføring kan mislykkes når kilde‑ og måldomener er forskjellige, lisenser er i konflikt, eller kilde‑modellen inneholder upassende skjevhet.
Hvorfor overføringslæring fungerer
Modeller lærer ofte representasjoner som er nyttige utover de eksakte dataene de ble trent på. Tidlige lag i en bildemodell kan fange gjenbrukbare lokale mønstre; en språkmodell kan lære syntaks, semantikk og brede assosiasjoner fra selv‑overvåket prediksjon. En måloppgave kan bygge på disse representasjonene i stedet for å lære alt på nytt fra begrensede eksempler.
Fordelen avhenger av likheten mellom kilde‑ og måloppgaver, omfanget og kvaliteten på forhåndstreningen, og hvordan modellen tilpasses. Gjenbruk er ikke garantert: overførte funksjoner kan være irrelevante eller aktivt skadelige.
Funksjonsekstraksjon
I funksjonsekstraksjon er den forhåndstrente basen frosset slik at dens parametere ikke endres. Dens output blir input til en ny klassifikator, regresor eller annet oppgavespesifikt hode. Kun det nye hodet trenes.
Dette er raskt og data‑effektivt, og det reduserer risikoen for å ødelegge nyttige forhåndstrente representasjoner. Det kan også under‑fitte når måldomenet avviker betydelig fra forhåndstreningen. Lag som batch‑normalisering krever spesiell oppmerksomhet fordi deres lagrede statistikker og treningsatferd kan påvirke tilpasning selv når de fleste vekter er frosset.
Finjustering
Finjustering oppdaterer forhåndstrente parametere på mål‑data. En vanlig arbeidsflyt er:
- Last inn den forhåndstrente modellen og erstatt eller legg til output‑hodet.
- Frys basen og tren det nye hodet.
- Frigjør valgte lag – eller hele modellen – og fortsett med en lavere læringsrate.
- Valider for overtilpasning, glemsel og ytelse i måldomenet.
Det finnes ingen universell regel om at kun de siste lagene skal tunes. Det beste valget avhenger av arkitektur, størrelse på mål‑data, domene‑likhet, normaliseringslag, minne og beregning. Full finjustering kan gi mer kapasitet, men krever flere ressurser og kan forårsake katastrofal glemsel.
Parameter‑effektiv finjustering
Store transformere gjør full finjustering kostbar. Parameter‑effektiv finjustering (PEFT) endrer eller legger til et lite sett med parametere mens de fleste av basismodellen forblir frosset.
- Adaptere setter inn små trenbare moduler i nettverket.
- LoRA representerer vektoppdateringer med lav‑rang matriser, noe som reduserer trenbare parametere og optimaliseringsminne.
- Prompt‑ og prefiks‑tuning lærer kontinuerlige oppgavespesifikke innganger eller interne prefikser.
PEFT kan lagre mange oppgave‑tilpasninger rundt én basismodell, selv om inferens‑tjeneste, adapter‑kompatibilitet og håndtering av sammenslåtte vekter fortsatt krever nøye ingeniørarbeid.
Overføringslæring på tvers av datatyper
Bildeklassifikatorer starter ofte fra modeller som er forhåndstrent på store bildedatasett. Språksystemer starter fra en grunnmodell og tilpasser den gjennom veiledet finjustering, preferanseoptimalisering, gjenfinning eller verktøybruk. Tale‑, lyd‑, protein‑ og multimodale modeller følger lignende mønstre.
Overføring kan også skje uten å endre den opprinnelige modellen. En frossen modell kan generere innebygginger for en nedstrøms klassifikator, et vektor‑likhetssøk‑system eller en gjenfinning‑pipeline.
Domene‑skift og negativ overføring
Domene‑skift oppstår når mål‑inputene avviker fra kilde‑dataene. En medisinsk bildemodell kan for eksempel møte utstyr, befolkninger eller innhentingsprotokoller som mangler i forhåndstreningen. Negativ overføring betyr at gjenbruk gjør mål‑ytelsen dårligere enn en passende fra‑bunnen‑av‑grunnlinje.
Team bør sammenligne tilpasningsstrategier, evaluere meningsfulle undergrupper, og holde et testsett for måldomenet. Hvis kildeoppgaven er dårlig tilpasset, kan en mindre domene‑spesifikk modell overgå en større generell modell.
Lisensiering, opprinnelse og sikkerhet
En nedlastbar modell er ikke automatisk trygg å sette i produksjon. Gå gjennom lisensen, tillatte bruksområder, opplysninger om treningsdata, begrensninger i modell‑kortet og avhengighetskjeden. Modeller kan reprodusere skjevhet, memorere sensitiv data eller inneholde ondsinnet serialisert kode. Bruk pålitelige formater, skann artefakter, og last inn upålitelige vekter i et isolert miljø.
Når man bør bruke overføringslæring
Overføringslæring er et sterkt standardvalg når en relevant forhåndstrent modell finnes og mål‑data er begrenset. Å trene fra bunnen av kan være å foretrekke når domenet er svært spesialisert, lisensiering er inkompatibel, modellstørrelsen overskrider distribusjonsgrenser, eller en enkel oppgave ikke drar nytte av en stor forhåndstrent representasjon. Beslutningen bør valideres empirisk i stedet for å antas ut fra modellstørrelse.
Hva som overføres og hvordan man tilpasser det
Overføringslæring gjenbruker representasjoner som er lært på en kildeoppgave eller datasett for en måloppgave. Innen datavisjon fanger tidlige funksjoner ofte kanter og teksturer; innen språk koder forhåndstrente modeller statistiske mønstre over token og kontekster. Overføring fungerer når kilde‑representasjonene inneholder informasjon som er relevant for målet, men domene‑, etikett‑, modalitets‑ og innhentingsforskjeller kan føre til negativ overføring. Start med en forhåndstrent basislinje, undersøk dens treningslisens og dokumentasjon, og sammenlign med å trene en liten mål‑spesifikk modell fra bunnen av.
Funksjonsekstraksjon fryser ryggraden og trener et nytt hode; delvis finjustering frigjør valgte lag; full finjustering oppdaterer hele modellen. Parameter‑effektive metoder legger til adaptere eller lav‑rang oppdateringer, noe som reduserer trenbare parametere men ikke nødvendigvis inferens‑minne. Bruk en lavere læringsrate for forhåndstrente vekter, bevar normaliseringsatferd, og unngå katastrofal glemsel med tidsplaner, regularisering, repetisjon eller begrensede oppdateringer etter behov. Velg sjekkpunkter på mål‑valideringsdata og test flere frø fordi små mål‑datasett gir høy varians.
Data, evaluering og distribusjons‑avveier
Mål‑data bør representere distribusjonsforhold og viktige undergrupper, ikke bare være et praktisk merket utvalg. Del etter emne, kilde, tid eller sted for å hindre at relaterte eksempler krysser partisjoner. Test både i‑domene og skiftede forhold. Sammenlign frosne, delvis tunede og fullt tunede varianter på kvalitet, kalibrering, treningskostnad, latens og robusthet. En forbedring i gjennomsnittlig score kan skjule et tap på sjeldne klasser som er arvet fra kilde‑skjevhet. Gå gjennom feil‑eksempler for kilde‑spesifikke snarveier, vokabularhull eller sensorforskjeller.
Følg basismodellen, vektene, tokenisereren eller forhåndsbehandlingen, adapteren, dataene og lisensen som ett avhengighets‑graf. Vertede basismodeller kan endre oppførsel; åpne vekter kan introdusere forsyningskjede‑ og oppdateringsansvar. Valider den sammenslåtte eller eksporterte artefakten og skann modell‑filer fra upålitelige kilder. I produksjon, overvåk mål‑drift og ytelse, og behold muligheten til å rulle tilbake både tilpasningen og basisversjonen. Overføring reduserer nødvendig mål‑data; det eliminerer ikke merking, evaluering, personvern eller domene‑ekspertise.
Arbeidseksempel: tilpasse en visuell modell til en ny klinikk
En klinikk tilpasser en forhåndstrent bilde‑enkoder for å klassifisere bildekvalitet før diagnostisk gjennomgang. Den verifiserer kilde‑modellens lisens og tiltenkte modalitet, samler inn lokale enheter og innhentingsforhold, og deler etter pasient. Varianten med frosne funksjoner, adapter, delvis og full finjustering sammenlignes med en liten lokal basislinje. Metrikker inkluderer klasserecall, kalibrering, undergruppe‑atferd, beregning og sensitivitet for enhet, sted og sjeldne artefakter.
Den tilpassede modellen kan ikke stille en diagnose og videresender bilder med lav tillit eller uten støtte til teknologer. Eksportvalidering bekrefter lokal forhåndsbehandling og numerisk ekvivalens. Modell‑, adapter‑, enhets‑ og datasett‑versjoner er knyttet i registeret. Overvåking oppdager nye skannere, protokollendringer og output‑drift, mens periodiske gjennomgåtte prøver estimerer reell ytelse. En oppgradering av kilde‑modellen behandles som en ny avhengighet som krever validering; overføringslæring rettferdiggjør ikke automatisk gjenbruk av gammel evidens.
Implementeringsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, innganger, utganger, avhengigheter, eier og konsekvensen av hver viktig feil. Etabler en reproduserbar basislinje og et versjonert evalueringssett før justering. Test vanlige tilfeller, grenseforhold, feil‑ eller manglende input, distribusjons‑skift, avhengighets‑nedbrudd, misbruk, og gruppene eller miljøene som mest sannsynlig blir underbetjent. Mål oppgavekvalitet sammen med kalibrering eller usikkerhet, latens, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig vurderer kan reprodusere resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåking med bevisst injiserte feil. Operasjonell telemetri bør avdekke input‑kvalitet, output‑atferd, modell‑ eller regelversjon, avhengighets‑helse, menneskelige overstyringer og bekreftede resultater uten å samle unødvendig sensitiv data. Definer varslings‑terskler og en ansvarlig for respons, og gjennomgå virkelige bevis etter distribusjon i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, retningslinjer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelses‑læring, slettings‑ og oppbevaringsprosedyrer, samt et tydelig punkt hvor det skal deaktiveres eller erstattes.
Primære referanser











