Grunnleggende AI
Hva er store språkmodeller (LLM‑er)?

 Legg til Unite.AI blant dine foretrukne kilder på Google
En stor språkmodell (LLM) er et nevralt nettverk som er trent på store samlinger av sekvenser for å forutsi token‑er eller relaterte språkoppgaver. De fleste nåværende LLM‑ene bruker transformer‑arkitekturer og kan generere, klassifisere, oppsummere, oversette, hente og transformere språk via et felles grensesnitt.
En LLM er ikke en database eller en garantert resonneringsmaskin. Dens output er en betinget prediksjon formet av treningsdata, etter‑trening, kontekst, verktøy og dekoding. Flyt kan sameksistere med faktuelle feil, usikkerhet, skjevhet eller usikker atferd.
Viktige punkter
- Tokenisering konverterer tekst til diskrete enheter; innbygginger og oppmerksomhet bygger kontekstuelle representasjoner.
- For‑trening lærer brede mønstre, mens fin‑justering og preferansemetoder former oppgaveadferd.
- Henting og verktøy kan legge til oppdatert bevis eller handlinger, men krever separate tillatelser og validering.
- Evaluer det distribuerte systemet for kvalitet, forankring, sikkerhet, latenstid, kostnad og driftsavvik.
Token, transformere og for‑trening
Tekst deles inn i token‑er. En transformer kartlegger dem til vektorer, blander informasjon gjennom oppmerksomhets‑ og fremover‑matingslag, og produserer en sannsynlighetsfordeling over den neste eller manglende token.
Selv‑overvåkede mål lager treningssignaler fra rå sekvenser. Skala i parametere, data og beregning kan forbedre tapet på forutsigbare måter over ulike områder, men datasettkvalitet, arkitektur, optimalisering og evaluering bestemmer hvilke evner som faktisk dukker opp.
Etter‑trening og inferens
Instruksjons‑tuning bruker demonstrasjoner; preferanse‑optimalisering kan få output til å bedre samsvare med menneskelige vurderinger eller en policy. Under inferens definerer en prompt og samtalehistorikk konteksten, mens temperatur‑ og sampling‑innstillinger påvirker variasjonen.
RLHF og lignende metoder former atferd i stedet for å installere en fullstendig faktasjekker. Modellen kan fortsatt generere et plausibelt, men uunderbygget svar.
Henting, verktøy og agenter
Retrieval‑forsterket generering leverer utdrag valgt fra en ekstern samling. Verktøy‑kalling lar applikasjonskode spørre databaser, beregne, søke eller utføre handlinger. Disse mønstrene skiller noe kunnskap og utførelse fra modellens vekter.
Applikasjonen må validere verktøyargumenter, håndheve tillatelser, bevare sitater, og behandle hentet innhold som upålitelig input. Vektorsøk etter likhet hjelper med henting, men beviser ikke at et utdrag støtter svaret.
Begrensninger og evaluering
LLM‑er kan hallusinere, avsløre lagret innhold, følge ondsinnede instruksjoner, reprodusere skjevhet, og feile på oppgaver som ser like ut som trenings‑eksempler. Lang kontekst garanterer ikke at hver fakta blir brukt eller korrekt avstemt.
Evaluer på representative private oppgaver med dokumenterte prompts og versjoner. Mål støtte fra kilder, avslag, kalibrering, sikkerhet, undergruppe‑resultater, menneskelig arbeidsbelastning, latenstid og kostnad. Overvåk etter lansering fordi modeller, data og brukeradferd endres.
Treningsdata og modellutvikling
For‑trenings‑korporasjoner kombinerer nettsider, bøker, kode, akademisk materiale, samtaler og lisensierte eller kuraterte kilder. Pipelines oppdager språk, fjerner duplikater, filtrerer kvalitet og usikkert innhold, håndterer persondata, og velger blandingsvekter. Disse valgene former kunnskap, språkdekning, stil, skjevhet og memorering.
Optimaliseringsprosesser batcher token‑sekvenser og minimerer prediksjonstap med gradientnedstigning. Distribuert trening deler data, modell‑tensorer, pipeline‑stadier eller eksperter over akseleratorer. Kontrollpunkt‑lagring, numerisk stabilitet, nettverkskommunikasjon og feilgjenoppretting blir store ingeniørutfordringer i stor skala.
Evaluering under trening sporer tap og kapabilitets‑sett, men benchmark‑kontaminasjon kan oppblåse resultater. Hold tilbake tidsperioder og proprietære oppgaver, søk etter overlapp, og rapporter eksakte prompts, dekoding, verktøy og poengsetting. En modell kan forbedre gjennomsnittlig tap mens regresjoner oppstår i sikkerhet eller i et språk med få ressurser.
Kontekstvinduer, dekoding og inferens
Under inferens lagrer nøkkel‑verdi‑bufferen oppmerksomhets‑projeksjoner for tidligere token‑er slik at de ikke må beregnes på nytt ved hvert steg. Buffer‑minnet vokser med lag, sekvens, batch og representasjon. Kvantisering og paging reduserer presset, men kan endre kvalitet eller latenstid.
Grådig dekoding velger token‑en med høyest sannsynlighet; temperatur justerer sannsynligheter; top‑k og top‑p begrenser kandidatsettet; beam‑søk følger flere sekvenser. Den beste strategien avhenger av om oppgaven verdsetter determinisme, mangfold, strukturert output eller sekvens‑sannsynlighet. Valider alltid skjema etter generering.
Lang kontekst øker mengden tilgjengelig informasjon, men garanterer ikke gjenkalling eller resonnering. Posisjon, distraktorer, motstrid og prompt‑struktur påvirker bruken. Henting kan velge et mindre evidenssett, mens oppsummering komprimerer historikken med risiko for tap av detaljer. Mål ytelse på tvers av kontekstlengde og -plassering.
Tilpasning, distribusjon og økonomi
Full fin‑justering oppdaterer alle parametere; parameter‑effektive metoder oppdaterer adaptere eller lav‑rang‑matriser; fortsettende for‑trening tilpasser domenefordelingen; instruksjons‑ og preferanse‑tuning former svar. Henting er ofte bedre for hyppig endrende fakta, mens tuning er bedre for atferd og oppgaveformat. Metodene kan kombineres.
Distribusjonsvalg inkluderer hostede API‑er, administrerte endepunkter, selv‑hostede åpne vekter, modeller på enheten og hybrider. Sammenlign databehandling, versjonskontroll, latenstid, gjennomstrømning, regioner, tilgjengelighet, modellportabilitet, support og total kostnad. Selv‑hosting overfører ansvar for sikkerhet, skalering, oppdateringer og misbruksovervåking.
Kostnad per token er ufullstendig. En svak modell kan kreve gjentakelser, lengre prompts, mer gjennomgang eller dyre feil. Mål kostnad per vellykket fullført oppgave ved nødvendig kvalitet og risikonivå. Bruk caching, batch‑behandling, mindre rutede modeller og deterministisk kode der de forbedrer hele arbeidsflyten.
Arbeidseksempel: forankre en LLM i bedriftsdokumenter
En dokumentassistent bør starte med et tillatelses‑bevisst korpus, stabile dokumentidentifikatorer, versjons‑ og ikrafttredelsesdatoer, parsbar struktur, og et evalueringssett med svarbare, ubesvarbare, tvetydige og motstridende spørsmål. Hentings‑indekser deler opp i biter og metadata, men bit‑størrelse og overlapp må tilpasses dokumentstrukturen. Søkkvalitet måles uavhengig før generering, slik at en flytende modell ikke kan skjule manglende bevis.
Ved kjøring autentiseres brukeren, henting filtreres etter tilgang, bevis hentes og re‑rangert, en avgrenset prompt konstrueres, et sitert svar genereres, og påkrevd output valideres. Modellen bør oppgi når kilder er i konflikt eller ikke støtter et svar. Verktøybruk og eksterne handlinger krever separat autorisasjon. Beskytt mot instruksjoner innebygd i hentede dokumenter ved å behandle innholdet som data i stedet for en høyere‑prioritert systempolicy.
Evaluer henting‑gjenkalling, siterings‑presisjon, svar‑korrekthet, forankring, avslag, latenstid og kostnad på tvers av roller og dokumenttyper. Spor modell‑, prompt‑, indeks‑, parser‑ og korpus‑versjoner for hver test. I produksjon logges bevis‑ID‑er og tilbakemeldinger uten å eksponere privat tekst, overvåk nye ubesvarbare spørsmål etter innholdsendringer, og oppretthold en sikker reserve. Et LLM‑grensesnitt erstatter ikke arkivstyring, tilgangskontroll eller ansvarlig faglig gjennomgang.
Kapasitetsplanlegging bør modellere fordeling av prompt‑ og output‑lengde, samtidige brukere, cache‑adferd, verktøy‑latenstid og gjentakelses‑rater. Strømming forbedrer oppfattet latenstid, men kompliserer moderering og avbryting fordi usikkert eller feil innhold kan nå brukeren før hele svaret er sjekket. Sett token‑ og verktøy‑budsjetter, isoler leietakere, beskytt leverandør‑legitimasjon, og øv på failover mellom modell‑versjoner uten stille å endre atferden brukerne er avhengige av.
Praktisk implementeringssjekkliste
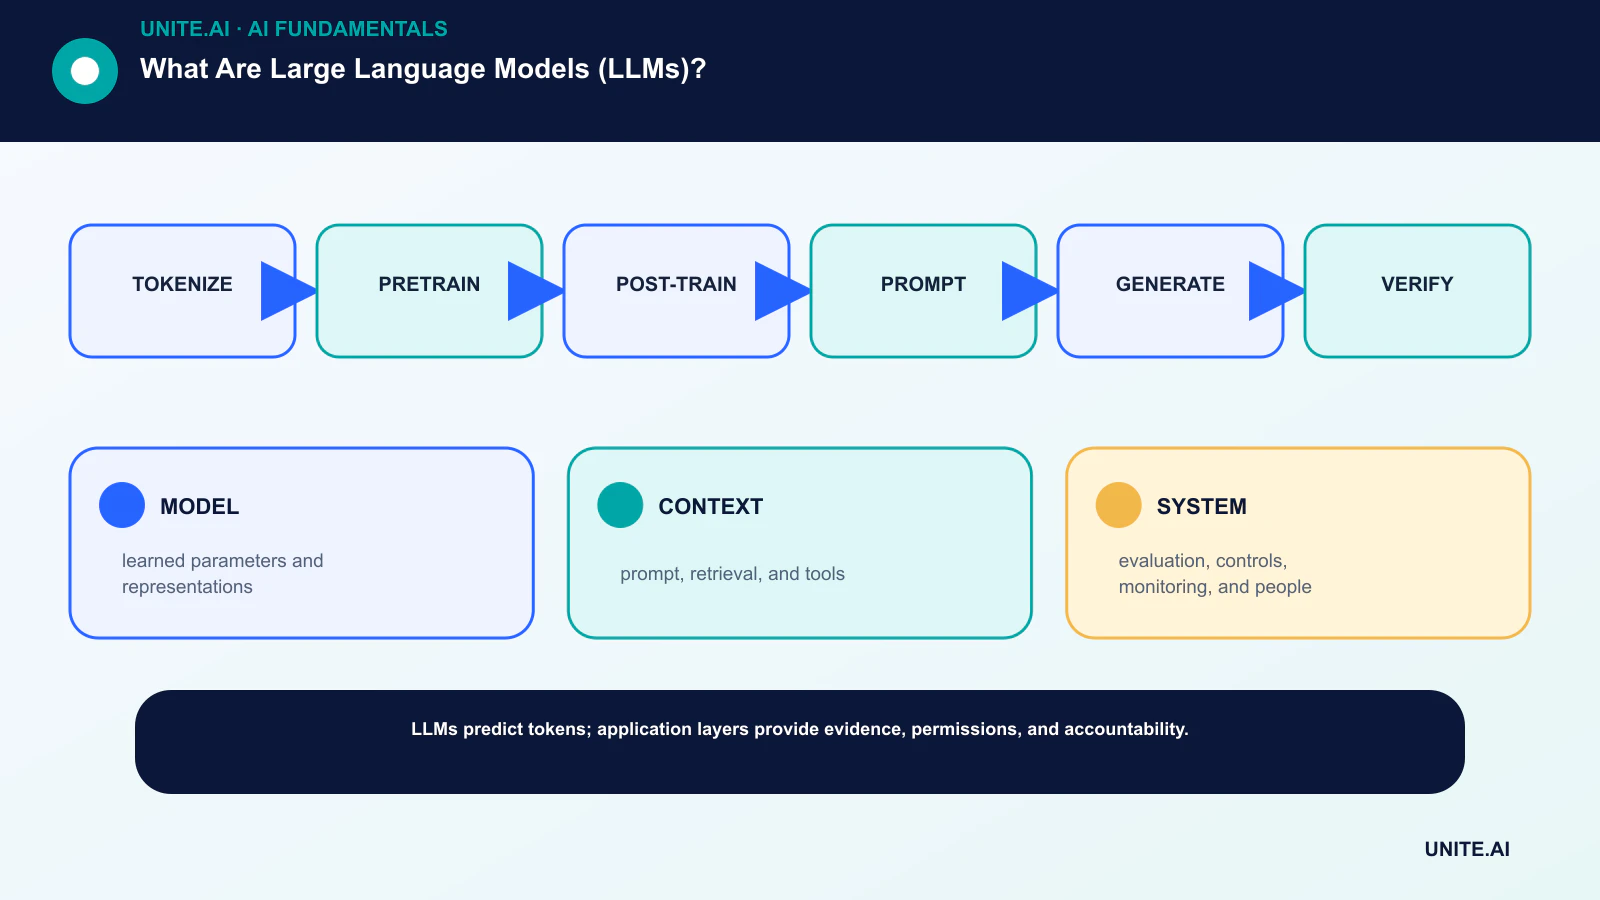
Gjør konseptet til en avgrenset, testbar arbeidsflyt: tokeniser → for‑trening → etter‑trening → prompt → generer → verifiser. Navngi en ansvarlig eier, dokumenter data og avhengigheter, etabler en enkel basislinje, sett aksept‑ og stopp‑kriterier, test representative feil, og definer overvåking, tilbakeføring og gjennomgang før du utvider omfanget. Registrer versjoner og antakelser slik at et annet team kan gjenskape resultatet og forstå hva som har endret seg.
Før lansering, gjennomfør en dokumentert beredskapsgjennomgang med personene som bygger, drifter, sikrer og påvirkes av systemet. Test normale tilfeller, grensetilstander, avhengighets‑feil og misbruk; bevar bevisene og uløste risikoer. Definer hvem som kan godkjenne utgivelse, endre en terskel, overstyre en output eller stoppe driften. Revurder beslutningen etter at virkelige data kommer, fordi en teknisk vellykket pilot ikke garanterer pålitelig ytelse i større skala.
- MODEL: lærte parametere og representasjoner.
- CONTEXT: prompt, henting og verktøy.
- SYSTEM: evaluering, kontroller, overvåking og personer.
Ofte stilte spørsmål
Hvorfor kalles LLM‑er store?
Det finnes ingen universell parameter‑grense. ‘Store’ refererer til skala i forhold til tidligere språkmodeller, inkludert antall parametere, treningsdata, beregning og omfang av bruk.
Forstår LLM‑er språk?
De bygger nyttige interne representasjoner og viser kompleks atferd, men ordet ‘forstå’ har flere betydninger. Ytelse bør demonstreres oppgave for oppgave i stedet for å bli antatt ut fra flyt.
Primære referanser