
Grunnleggende AI
Hva er sentimentanalyse? Metoder, bruksområder og begrensninger

 Legg til Unite.AI blant dine foretrukne kilder på Google
Sentimentanalyse estimerer evaluerende språk i tekst, taletranskripsjoner eller annet innhold. Et system kan klassifisere polaritet som positiv, negativ eller nøytral; oppdage meninger på aspektnivå; estimere intensitet; eller identifisere holdning til et bestemt påstand.
Målet må defineres nøye. Sentiment er ikke det samme som følelser, intensjon, giftighet, tilfredshet eller sannhet. En positiv setning kan beskrive en skadelig hendelse sarkastisk, mens en negativ produktanmeldelse fortsatt kan anbefale produktet samlet sett.
Viktige punkter
- Definer enhet, mål, etiketter og kontekst før du samler inn eksempler.
- Leksikoner er transparente grunnlinjer; overvåkede modeller og transformermodeller kan fange mer kontekst, men krever representativ data.
- Negasjon, sarkasme, domeneordforråd, flerspråklig tekst og aspektgrenser er fortsatt utfordrende.
- Evaluer per klasse, undergruppe, domene og tidsperiode; inkluder menneskelig gjennomgang for konsekvensfulle bruksområder.
Nivåer og mål
Analyse på dokumentnivå gir én etikett for et helt element. Setningsnivåanalyse skiller utsagn, mens aspektbasert analyse knytter sentiment til en enhet eller egenskap – for eksempel positiv om bildekvalitet, men negativ om batterilevetid.
Holdning spør om en taler støtter et spesifikt påstand, noe som kan avvike fra den emosjonelle tonen. Disse forskjellene bør fastsettes i annotasjonsveiledningen før du bruker metoder for tekstklassifisering.
Leksikoner, klassiske modeller og transformere
Et leksikon tilordner poeng til ord og kombinerer dem med regler for negasjon eller intensitet. Det er tolkningsbart og billig, men sliter med kontekst. Klassiske overvåkede modeller bruker ord- eller n-gram-funksjoner, mens transformere lærer kontekstuelle representasjoner og kan finjusteres.
Few-shot‑prompting kan være praktisk, men resultatene avhenger av eksempler og formulering. Sammenlign hver kompleks tilnærming med en grunnlinje, og bruk few-shot‑læring kun med et hold‑out, versjonert evalueringssett.
Data‑ og språkutfordringer
Etiketter kan reflektere annotatorens perspektiv snarere enn en objektiv fakta. Domeneskifte er alvorlig: ‘uventet’ kan være ros for en film og kritikk for et kjøretøy. Kodeskifting, dialekt, emojis, sitert tale og ironi kompliserer token‑nivå‑signaler.
Balanser klasser bevisst og hindr relaterte forfattere, produkter eller samtaler fra å lekke mellom trening og testing. En modell som memoriserer et merke eller en taler kan virke nøyaktig uten å ha lært sentiment.
Evaluering og ansvarlig bruk
Rapporter presisjon, tilbakekalling, F1‑score og en forvirringsmatrise i stedet for kun nøyaktighet. Gå gjennom feil etter aspekt, lengde, dialekt og tid, og kalibrer terskler for den operative kostnaden ved hver feil.
Aggregert trend kan støtte forskning eller triage, men å trekke slutninger om en enkeltpersons tilstand eller ta beslutninger om ansettelse, kreditt, helse eller politiarbeid medfører større risiko. Gi usikkerhet, kilde‑kontekst, personvernkontroller og menneskelig gjennomgang.
Annotering og datasettkonstruksjon
Skriv en annotasjonsveiledning med mål‑enhet, analyseenhet, etikettdefinisjoner, håndtering av blandede og nøytrale tilfeller, siteringsregler, sarkasmepolitikk og eksempler fra domenet. Pilot med flere annotatorer, beregn enighet, diskuter uenigheter og revider oppgaven før du skalerer etikettene.
Utvalg bestemmer hva modellen lærer. En strøm fra sosiale medier kan overrepresentere svært aktive kontoer; support‑billetter kan utelate fornøyde kunder; stjernerangeringer kan ikke stemme overens med anmeldelsesteksten. Bevar kilde‑ og tidsmetadata, respekter plattformens vilkår og personvern, og lag et testsett fra den befolkningen der beslutninger vil bli tatt.
Etikett‑lekkasje kan oppstå via rangeringer, emojis satt inn av innsamlingssystemet, malbaserte signaturer eller produktnavn korrelert med sentiment. Fjern duplikater av nesten identiske innlegg og grupper samtaler eller forfattere slik at språket deres ikke vises på begge sider av en deling.
Modelleringsvalg og kalibrering
Leksikonsystemer summer ordpoeng og justerer for negasjon, intensiveringsord, tegnsetting eller emojis. De gir en nyttig sjekk og kan tilpasses med domenetermer. Lineære modeller med TF–IDF‑funksjoner er fortsatt konkurransedyktige på enkelte datasett og avslører påvirkningsfulle n‑grammer.
Kontekstuelle enkodere representerer ord i forhold til omgivende tekst og kan finjusteres for polaritet eller aspekter. Lange dokumenter kan trenge hierarkiske modeller, setningsaggregering eller henting av relevante spenner. Flerspråklige tilnærminger kan trene én delt modell, oversette til et pivot‑språk, eller opprettholde lokale modeller; hver har dekning og kulturelle avveininger.
Sannsynlighetskalibrering er viktig når poengsummer utløser handling. Pålitelighetsplott og forventet kalibreringsfeil viser om en rapportert 0,8‑tillit tilsvarer omtrent 80 % korrekthet. Terskler kan skape et avstå‑område for menneskelig gjennomgang, og separate terskler kan være begrunnet når feilkostnadene varierer – ikke for å skjule ulik kvalitet.
Applikasjoner og vanlige feiltolkninger
Aggregert sentiment kan hjelpe med å prioritere temaer, sammenligne kampanjereaksjoner eller rute presserende servicemeldinger. Aspektanalyse er ofte mer handlingsbar enn samlet polaritet fordi den identifiserer hva folk diskuterer. Trendanalyse krever stabilt utvalg og etikettdefinisjoner over tid.
Ikke likestill forekomsten av negative innlegg med befolkningens mening. Publiseringsatferd, roboter, moderering, plattformdemografi, kampanjer og innsamling‑spørringer former utvalget. En sentiment‑modell måler ikke den stille befolkningen, og en endring i formulering kan fremstå som en endring i holdning.
For individuelle beslutninger kan feilaktige etiketter være stigmatiserende og vanskelige å bestride. Unngå å bruke sentiment som en erstatning for medarbeiderengasjement, mental helse, kredittverdighet, intensjon eller bedrag. Når personer påvirkes, vis kilde‑kontekst, tillat korrigering, og krev en menneskelig beslutningstaker med reell skjønn.
Arbeids‑eksempel: sentimentanalyse for kundetilbakemeldinger
Et selskap som analyserer support‑kommentarer bør definere om det trenger dokument‑sentiment, aspekt‑sentiment, følelser, hastverk eller saksklassifisering. «Leveringen var rask, men produktet brøt» kan ikke representeres trofast med én positiv‑eller‑negativ etikett. Lag en annotasjonsveiledning for mål, negasjon, sarkasme, blandede utsagn, sitert tale og ukjente tilfeller, og mål deretter enighet før etikettene behandles som sannhetsgrunnlag.
Sammenlign et leksikon eller en lineær basislinje med en finjustert enkoder eller en prompted språkmodell. Del data etter tid eller kunde for å hindre lekkasje av nesten duplikater, og bevar klassefordeling. Rapporter presisjon, tilbakekalling, F1, kalibrering og forvirring etter språk, kanal, produkt og demografiske proxy‑er kun der det er lovlig og begrunnet. Gå gjennom feil med høy tillit fordi de er farligere i automatisert ruting enn usikre resultater som eskaleres.
Bruk sentiment som ett signal for aggregering eller prioritering, ikke som en udiskutabel måling av en persons tilstand. Overvåk ordforråd og produktdrift, tren på nytt med gjennomgåtte eksempler, og la agenter korrigere etiketter. Ikke noen gang avled beskyttede egenskaper eller disiplinér arbeidere basert på uvaliderte sentiment‑poengsummer. For lederrapportering, vis utvalgsstørrelse, usikkerhet, manglende data og temaene som driver endring, slik at en svingende score fører til undersøkelse i stedet for en forenklet konklusjon.
Flerspråklig utrulling bør ikke anta at oversettelse av innspill bevarer tone, negasjon, idiom eller kulturell konvensjon. Valider hver støttet språk og blandingsmønster med innfødte anmeldere, og gi et ukjent resultat når bevisene er svake. Domeneanpassning er også viktig: ord som høres negative ut i vanlig samtale kan være nøytrale tekniske beskrivelser. Oppretthold separate terskler eller modeller kun når operasjonelle bevis rettferdiggjør den ekstra kompleksiteten og styringsbyrden.
Praktisk implementeringssjekkliste
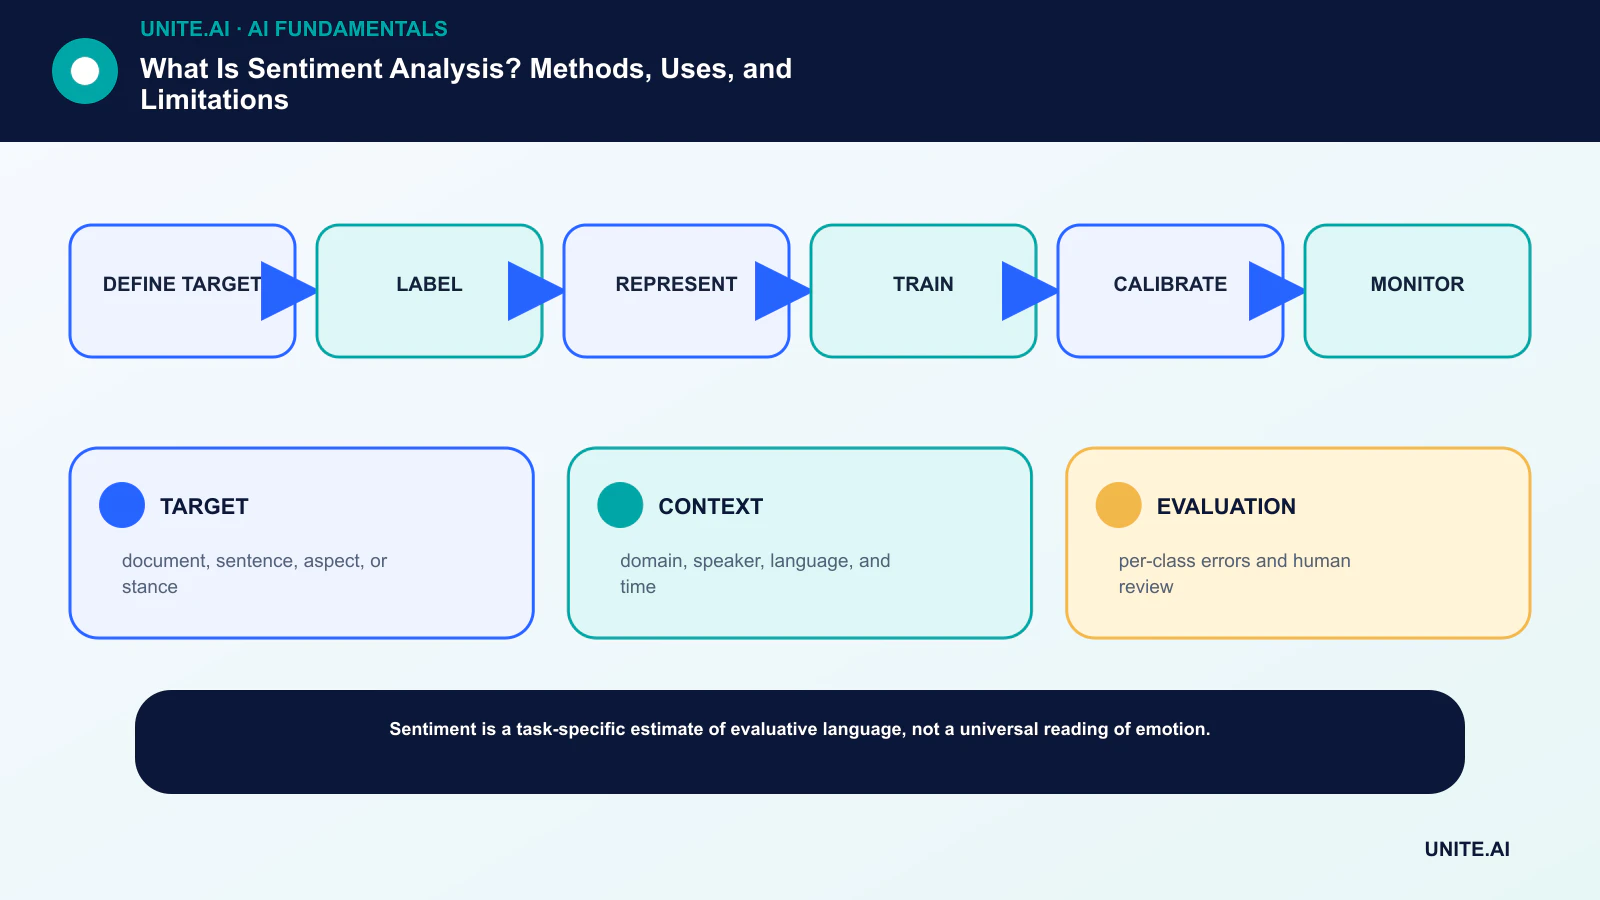
Gjør konseptet til en avgrenset, testbar arbeidsflyt: definer mål → etikett → representasjon → trening → kalibrering → overvåkning. Navngi en ansvarlig eier, dokumenter data og avhengigheter, etabler en enkel grunnlinje, sett aksept‑ og stoppkriterier, test representative feil, og definer overvåkning, tilbakeføring og gjennomgang før du utvider omfanget. Registrer versjoner og forutsetninger slik at et annet team kan gjenskape resultatet og forstå hva som har endret seg.
Før lansering, gjennomfør en dokumentert beredskapsgjennomgang med de som bygger, drifter, sikrer og påvirkes av systemet. Test normale tilfeller, grensetilstander, avhengighetsfeil og misbruk; bevar bevisene og uavklarte risikoer. Definer hvem som kan godkjenne utgivelse, endre en terskel, overstyre et resultat eller stoppe driften. Revurder beslutningen etter at virkelige data kommer, fordi en teknisk vellykket pilot ikke garanterer pålitelig ytelse i større skala.
- MÅL: dokument, setning, aspekt eller holdning.
- KONTEKST: domene, taler, språk og tid.
- EVALUERING: feil per klasse og menneskelig gjennomgang.
Ofte stilte spørsmål
Er sentimentanalyse objektiv?
Nei. Den estimerer etiketter definert av en oppgave og annotasjonsprosess. Noen tekster er virkelig tvetydige, blandede, kontekstavhengige, eller blir tolket ulikt av leserne.
Kan sentimentanalyse oppdage sarkasme?
Modeller kan lære noen mønstre, men sarkasme avhenger ofte av talerens historie, delt kunnskap og kontekst utenfor teksten. Det er fortsatt en vanlig feilmodus.
Primære referanser












