Grunnleggende AI
Hva er dyp forsterkningslæring?

 Legg til Unite.AI blant dine foretrukne kilder på Google
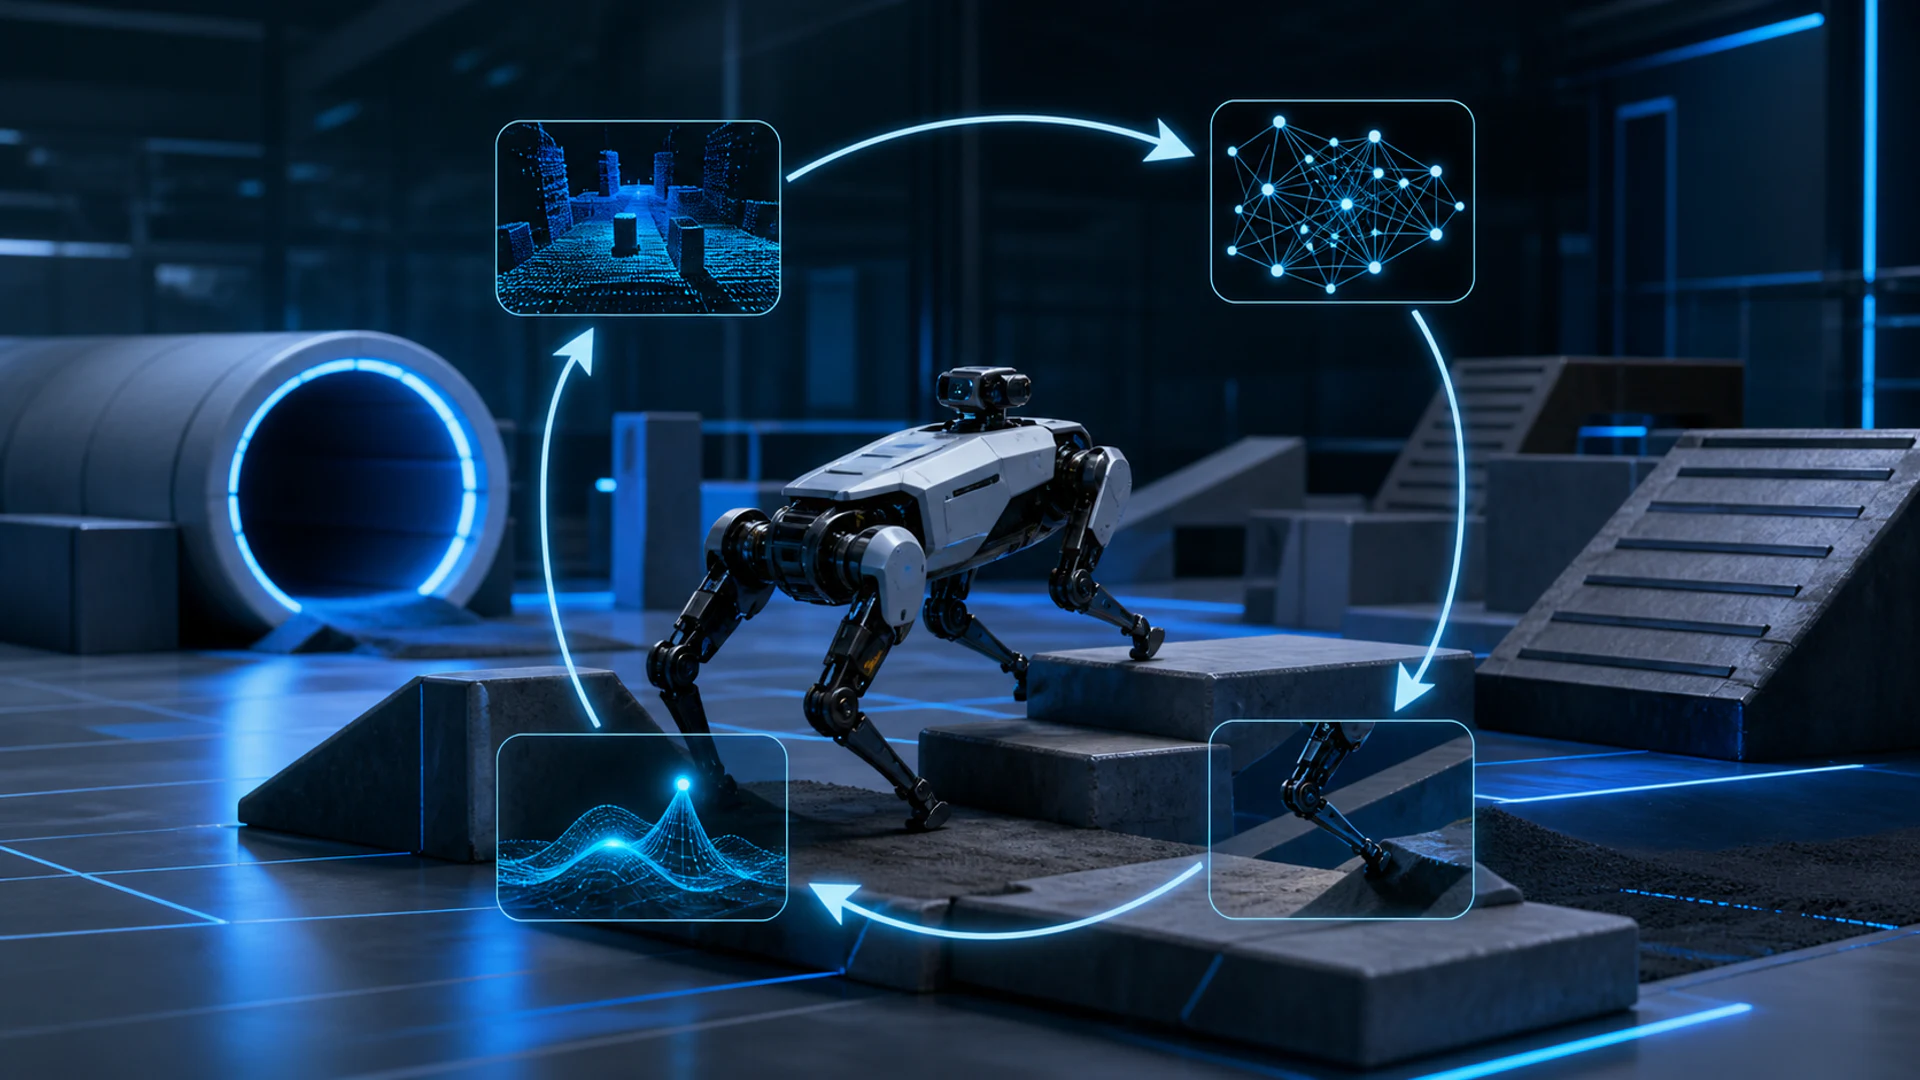
Dyp forsterkningslæring (deep RL) kombinerer forsterkningslæring med dype nevrale nettverk. En agent observerer en tilstand, velger en handling, mottar en belønning og en ny observasjon, og justerer deretter en policy eller verdi‑funksjon for å forbedre fremtidige beslutninger.
Det dype nettverket fjerner ikke de vanskelige delene av forsterkningslæring. Det gir en fleksibel måte å representere bilder, sensordata, store handlingsrom eller komplekse verdi‑funksjoner på. Utforskning, forsinket kreditt, ustabil trening og sikker evaluering i den virkelige verden forblir sentrale ingeniørproblemer.
Nøkkelpunkter
- Dyp RL lærer sekvensielle beslutninger fra interaksjon i stedet for en fast tabell med merkede eksempler.
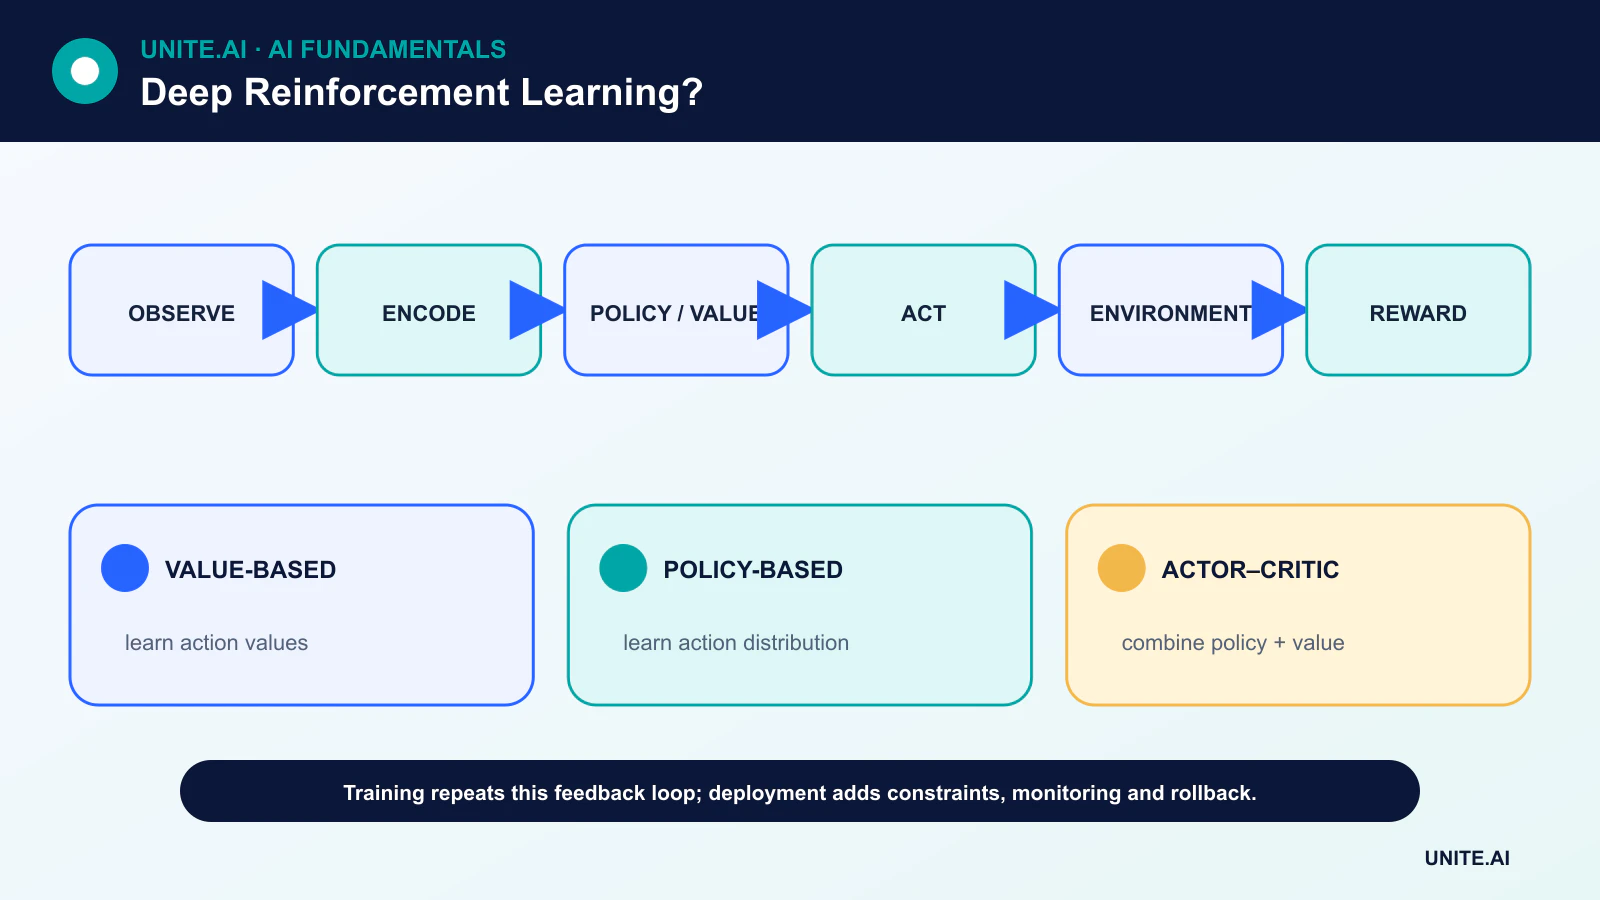
- Verdibasert metoder estimerer hvor gode handlinger er; policy‑metoder lærer handlingsfordelingen direkte; actor‑critic‑metoder kombinerer begge.
- Replay‑buffere, mål‑nettverk og nøye belønningsdesign kan forbedre treningen, men ingen av dem garanterer pålitelig oppførsel.
- En høy poengsum i en simulator er ikke bevis på robusthet, sikkerhet eller vellykket overføring til den fysiske verden.
Beslutningsproblemet: tilstander, handlinger og belønninger
Mange deep‑RL‑oppgaver modelleres som en Markov beslutningsprosess. På tidspunkt t mottar agenten en tilstand eller observasjon st, velger en handling at, og deretter mottar den belønning rt+1 og neste tilstand. Målet er den forventede diskonterte avkastningen, ikke nødvendigvis kun den neste belønningen.
Diskonteringsfaktoren styrer hvor sterkt fjerne belønninger påvirker. En belønningsfunksjon definerer hva optimaliseringsprosessen vil forfølge, så en ufullstendig proxy kan gi atferd som er teknisk vellykket, men operasjonelt uønsket. Dette er en av grunnene til at belønningsdesign og testing av begrensninger fortjener samme oppmerksomhet som modellarkitektur.
Verdibasert, policy‑basert og actor‑critic‑metoder
En verdibasert algoritme estimerer en tilstandsverdi eller handlingsverdi. Deep Q‑nettverk bruker et nevralt nettverk til å tilnærme Q‑verdier og velger vanligvis handlingen med den høyeste estimeringen samtidig som de bevarer noe utforskning. En policy‑gradient‑algoritme optimaliserer i stedet en parametrisk policy som produserer en handlingsfordeling.
Actor‑critic‑systemer opprettholder både en actor, som foreslår handlinger, og en critic, som estimerer deres verdi. Dette designet støtter kontinuerlig kontroll, men introduserer samvirkende kilder til estimeringsfeil. Dyp RL avhenger derfor av de samme grunnlagene som dyp læring, gradientnedstigning og tilbakepropagering.
Hvorfor replay‑buffere og mål‑nettverk hjelper
Påfølgende erfaringer er korrelerte, mens en nettverksoppdatering endrer målene som brukes av senere oppdateringer. Experience replay bryter noe av den tidsmessige korrelasjonen ved å sample eldre overganger. Et mål‑nettverk endres langsommere enn det online‑nettverket, noe som gjør bootstrapped‑mål mindre volatile.
Disse mekanismene forbedrer treningsstabiliteten, men justeringer er fortsatt viktige. Læringsrate, utforskningsplan, belønningsskala, replay‑sammensetning og nettverkskapasitet kan alle påvirke resultatet. Flere tilfeldige frø bør rapporteres fordi en enkelt kjøring kan være misvisende.
Offline RL, modellbasert RL og sim‑til‑virkelighet
Offline RL lærer fra et fast loggført datasett uten å samle inn nye interaksjoner. Det kan være nyttig når utforskning er kostbar eller usikker, men policyen må unngå handlinger som er dårlig representert i loggen. Modellbasert RL lærer eller bruker en overgangsmodell for å planlegge, og bytter ekstra antakelser for prøve‑effektivitet.
Robotikk trener ofte i simulering, randomiserer fysiske parametere, og finjusterer eller validerer deretter på maskinvare. Realitetsgapet kan fortsatt avdekke feil i persepsjon, timing, kontakt‑dynamikk og umodellert kant‑tilfeller. Et forsterknings‑lærings-system bør evalueres under forstyrrelser, distribusjonsendringer og eksplisitte sikkerhetsbegrensninger.
Evaluering og implementering
Nyttig evaluering skiller trenings‑ og testmiljøer, rapporterer avkastningsfordelinger i stedet for kun en beste poengsum, og sjekker brudd på begrensninger, intervensjonsfrekvens og verste‑tilfelle‑atferd. For reelle systemer trenger team også overvåking, tilbakeføringsprosedyrer, begrensede handlingsrom og en menneskelig overstyring.
Dyp RL er mest overbevisende når beslutninger er sekvensielle, tilbakemelding er tilgjengelig og håndskrevne kontrollregler er utilstrekkelige. Det er et dårlig valg når overvåkede etiketter er rikelige, en konvensjonell optimizer løser problemet, eller utforskning vil sette mennesker eller eiendeler i fare.
Deep RL‑arkitekturer og treningssignaler
Dyp forsterkningslæring bruker nevrale nettverk til å representere en verdi‑funksjon, policy, miljømodell eller en kombinasjon av disse. Et deep Q‑nettverk predikerer handlingsverdier og lærer fra tids‑differanse‑mål; experience replay reduserer korrelasjon mellom oppdateringer, mens et mål‑nettverk stabiliserer det bevegelige målet. Policy‑gradient‑metoder optimaliserer forventet avkastning direkte, og actor‑critic‑metoder bruker en lært critic for å redusere gradient‑varians. Kontinuerlige handlinger krever ofte deterministiske eller stokastiske actor‑critic‑varianter, mens diskrete høy‑dimensjonale handlinger trenger nøye utforskning og utformning av output.
Trening er ikke‑stasjonær fordi policyen endrer dataene den samler inn. Replay‑data blir off‑policy, bootstrapped‑mål avhenger av nåværende estimater, og funksjons‑approksimasjon kan forsterke feil – kombinasjonen kalles noen ganger den dødelige triaden. Doble estimater reduserer overestimering av verdi; fordelings‑funksjoner forbedrer kreditt‑tildeling; entropi‑bonuser oppmuntrer til utforskning; avkortede mål begrenser destruktive policy‑oppdateringer. Normaliser observasjoner og belønninger kun med lekkasjesikret tilstand, og registrer miljø, wrapper, handling‑gjentakelse, terminering og belønnings‑preprosessering fordi hver endrer problemet.
Evaluering, simulatorer og sikkerhet ved implementering
Rapporter avkastningsfordelinger på tvers av uavhengige frø og miljøinstanser, ikke den beste kjøringen. Evaluer prøve‑effektivitet, brudd på begrensninger, katastrofale utfall, følsomhet for belønningsskala, og robusthet mot observasjonsstøy, forsinkelse, aktuatort feil og endrede dynamikker. Sammenlign med skriptet kontroll, klassisk kontroll, overvåket imitasjon og enklere RL. Hold tilbake miljøvarianter og test resultat‑metrikker uten belønning, fordi en agent kan utnytte den programmerte belønningen mens den mislykkes i den tiltenkte oppgaven. Video‑ og trajektori‑inspeksjon avslører ofte atferd som er skjult av samlet avkastning.
Simulering muliggjør utforskning, men introduserer et realitetsgap. Randomiser relevant fysikk og persepsjon, kalibrer mot reelle målinger, og bruk konservativ overføring. Loggede data eller offline RL unngår online‑utforskning, men kan ikke pålitelig evaluere handlinger som ikke støttes av atferds‑policyen. Produksjonssystemer bør begrense handlingssettet, hastigheten, ressursene og driftsområdet; kreve godkjenning for handlinger med stor påvirkning; og inkludere en verifisert sikker kontroller eller stopp. Overvåk policy‑input, handlingsfordeling, belønning, reelle resultater og intervensjoner, med tilbakeføring til en testet policy‑versjon.
Et konkret kontroll‑eksempel
For lager‑robot‑ruting, definer tilstand ut fra posisjon, last, batteri, nærliggende trafikk og oppgavekø; handlinger ut fra tillatte bevegelser og lade‑beslutninger; og belønning ut fra fullført arbeid, energi, trafikkbelastning og sikkerhetsbegrensninger. Tren først i en kalibrert simulator med randomisert etterspørsel og sensorfeil, og deretter i skygge av reelle beslutninger. La aldri den lærte policyen omgå kollisjonsunngåelse. Evaluer gjennomstrømning sammen med nesten‑ulykker, dødlåser, batteri‑nødsituasjoner og verste‑tilfelle‑forsinkelse. Prosjektet lykkes kun hvis det lagdelte systemet forbedrer driften uten å overføre uakseptabel utforsknings‑risiko til personer eller utstyr.
Arbeidseksempel: DRL for datasenter‑kjøling
Et datasenter begrenser en RL‑agent til godkjente kjølings‑setpoint og trener den i en simulator kalibrert fra historisk vær, arbeidsbelastning, temperaturer og utstyrsrespons. Belønningen inkluderer energi, men harde begrensninger beskytter separat temperatur, luftfuktighet og utstyrs‑sykluser. Modell‑prediktiv kontroll og eksisterende regler fungerer som referanser. Evalueringen dekker årstider, sensorstøy, aktuatord forsinkelse, utstyrs‑tap, uvanlige belastninger og flere frø, og rapporterer energi, brudd, varians og gjenoppretting.
Den lærte policyen kjøres i skygge‑modus før en begrenset sone‑test. En ekstern sikkerhetskontroller kutter handlinger og operatører kan overstyre. Handlingshastighet, tilstandsdekning, modell‑usikkerhet og faktiske anleggsresultater overvåkes; simulering‑avvik eller gjentatte intervensjoner utløser tilbakeføring. Oppdatert utstyr eller kontroll‑logikk skaper en ny miljøversjon og validering. Energisparing aksepteres kun når pålitelighet, termisk margin, vedlikehold og respons på feil er minst like sterk som referansen.
Implementeringsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, innganger, utganger, avhengigheter, eier og konsekvensen av hver viktig feil. Etabler en reproduserbar basislinje og et versjonert evalueringssett før finjustering. Test vanlige tilfeller, grensetilstander, feilformatert eller manglende input, distribusjons‑skifte, avhengighets‑nedbrudd, misbruk, og gruppene eller miljøene som mest sannsynlig blir underbetjent. Mål oppgavekvalitet sammen med kalibrering eller usikkerhet, latenstid, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig vurderer kan reprodusere resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåking med bevisst injiserte feil. Operasjonell telemetri bør avdekke input‑kvalitet, output‑atferd, modell‑ eller regel‑versjon, avhengighets‑helse, menneskelige overstyringer og bekreftede resultater uten å samle inn unødvendige sensitive data. Definer varslings‑terskler og en ansvarlig for respons, og gjennomgå virkelige bevis etter implementering i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, retningslinjer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelses‑læring, sletting‑ og lagrings‑prosedyrer, samt et tydelig punkt hvor det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Er dyp forsterkningslæring det samme som dyp læring?
Nei. Dyp læring leverer funksjons‑approksimatorene; forsterkningslæring leverer interaksjonen, belønning og sekvensiell‑beslutnings‑mål.
Betyr en høy belønning at agenten har lært den tiltenkte atferden?
Ikke nødvendigvis. Det betyr at policyen fant en atferd som scorer høyt under den implementerte belønningen og miljøet. Uavhengige sikkerhets‑ og mål‑justeringstester er fortsatt nødvendige.
Primære referanser