
Grunnleggende AI
Hva er federert læring?

 Legg til Unite.AI blant dine foretrukne kilder på Google
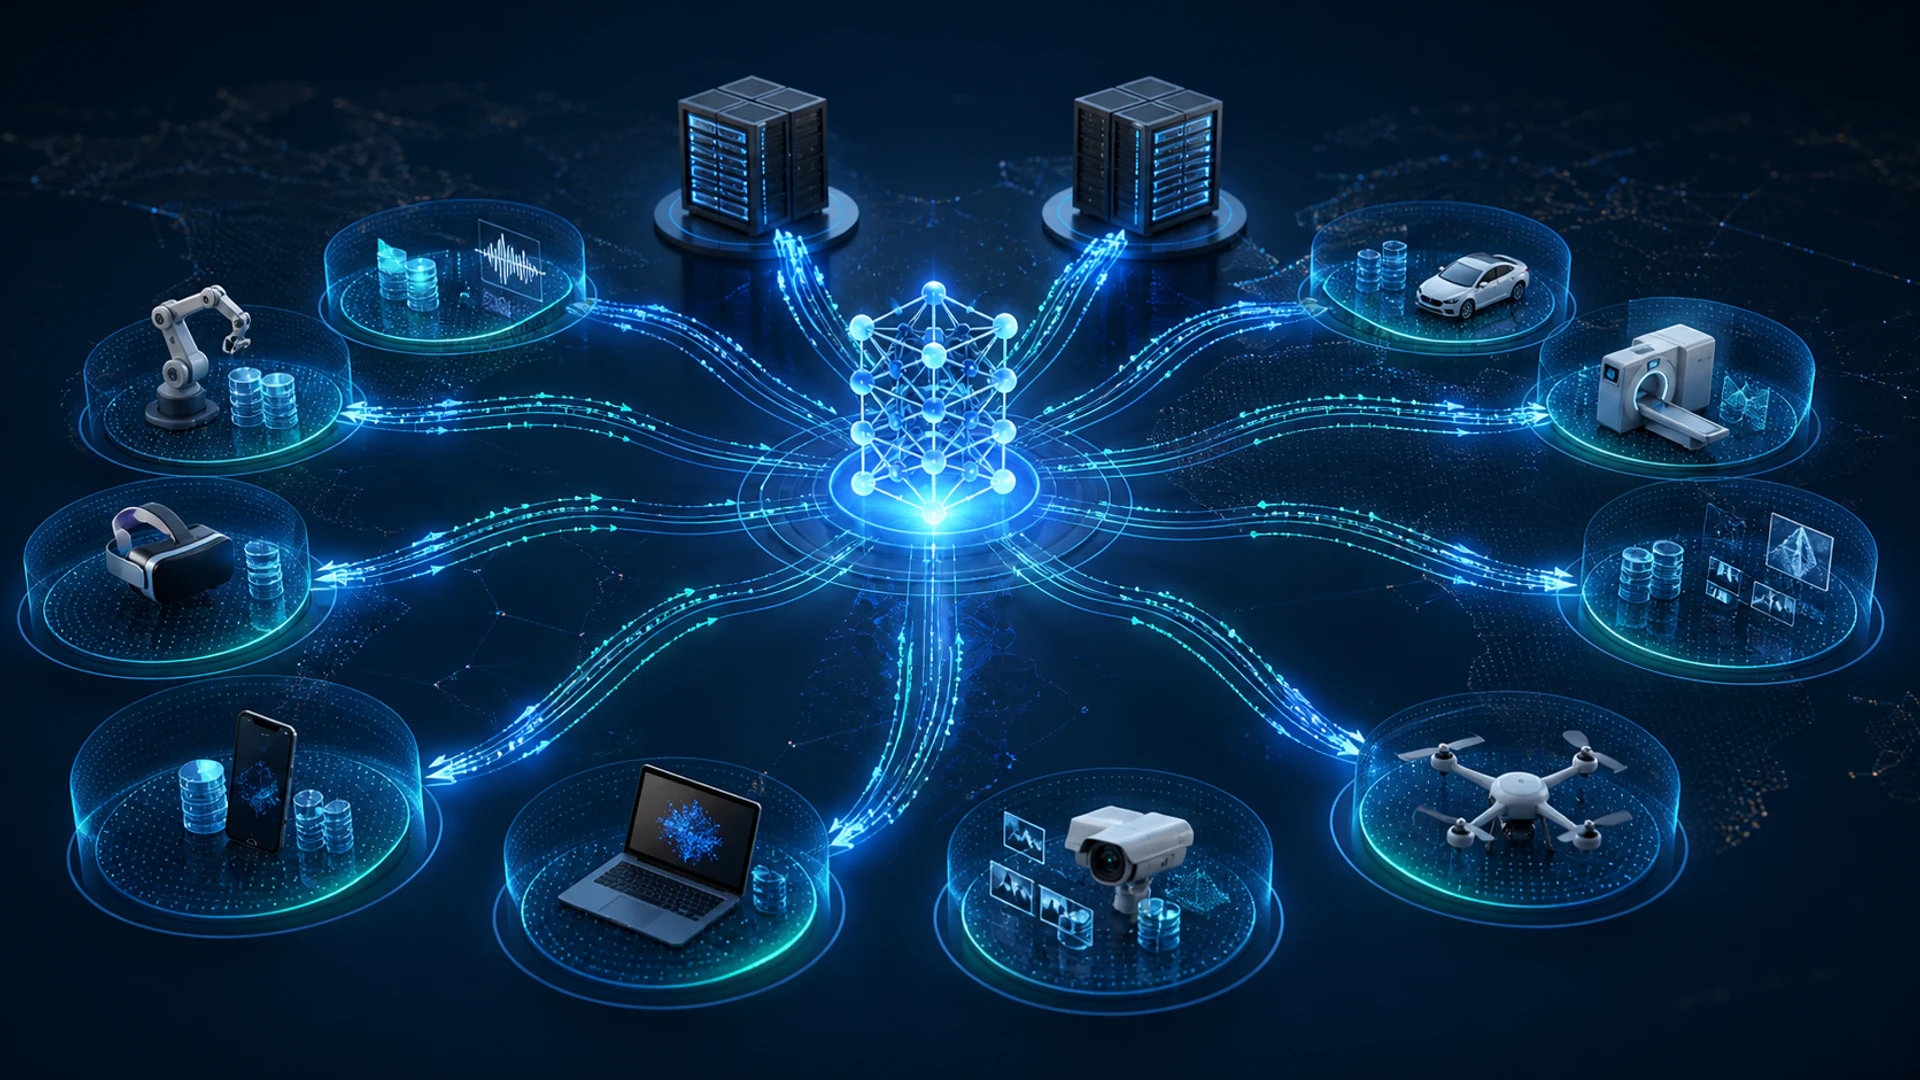
Federert læring trener en delt modell på tvers av flere enheter eller organisasjoner samtidig som hver deltakers rå treningsdata holdes lokalt. En koordinator distribuerer modellparametere, klienter beregner oppdateringer på sine egne poster, og et aggregasjonstrinn kombinerer disse oppdateringene.
Å holde poster lokalt er nyttig, men det er ikke synonymt med personvern eller sikkerhet. Modelloppdateringer kan lekke informasjon, kompromitterte klienter kan forgifte treningen, og koordinatoren trenger fortsatt autentisering, transportsikkerhet, tilgangskontroller og en definert tillitsmodell.
Viktige punkter
- Federert læring flytter beregning til distribuert data; den flytter ikke det rå datasettet til en sentral trener.
- Tverrenhetssystemer involverer mange intermittente enheter, mens tversilosystemer involverer færre, mer stabile organisasjoner.
- Sikker aggregasjon og differensiell personvern adresserer ulike risikoer og kan kombineres.
- Ikke‑IID‑data, begrenset båndbredde, upålitelig deltakelse og ondsinnede oppdateringer er sentrale designbegrensninger.
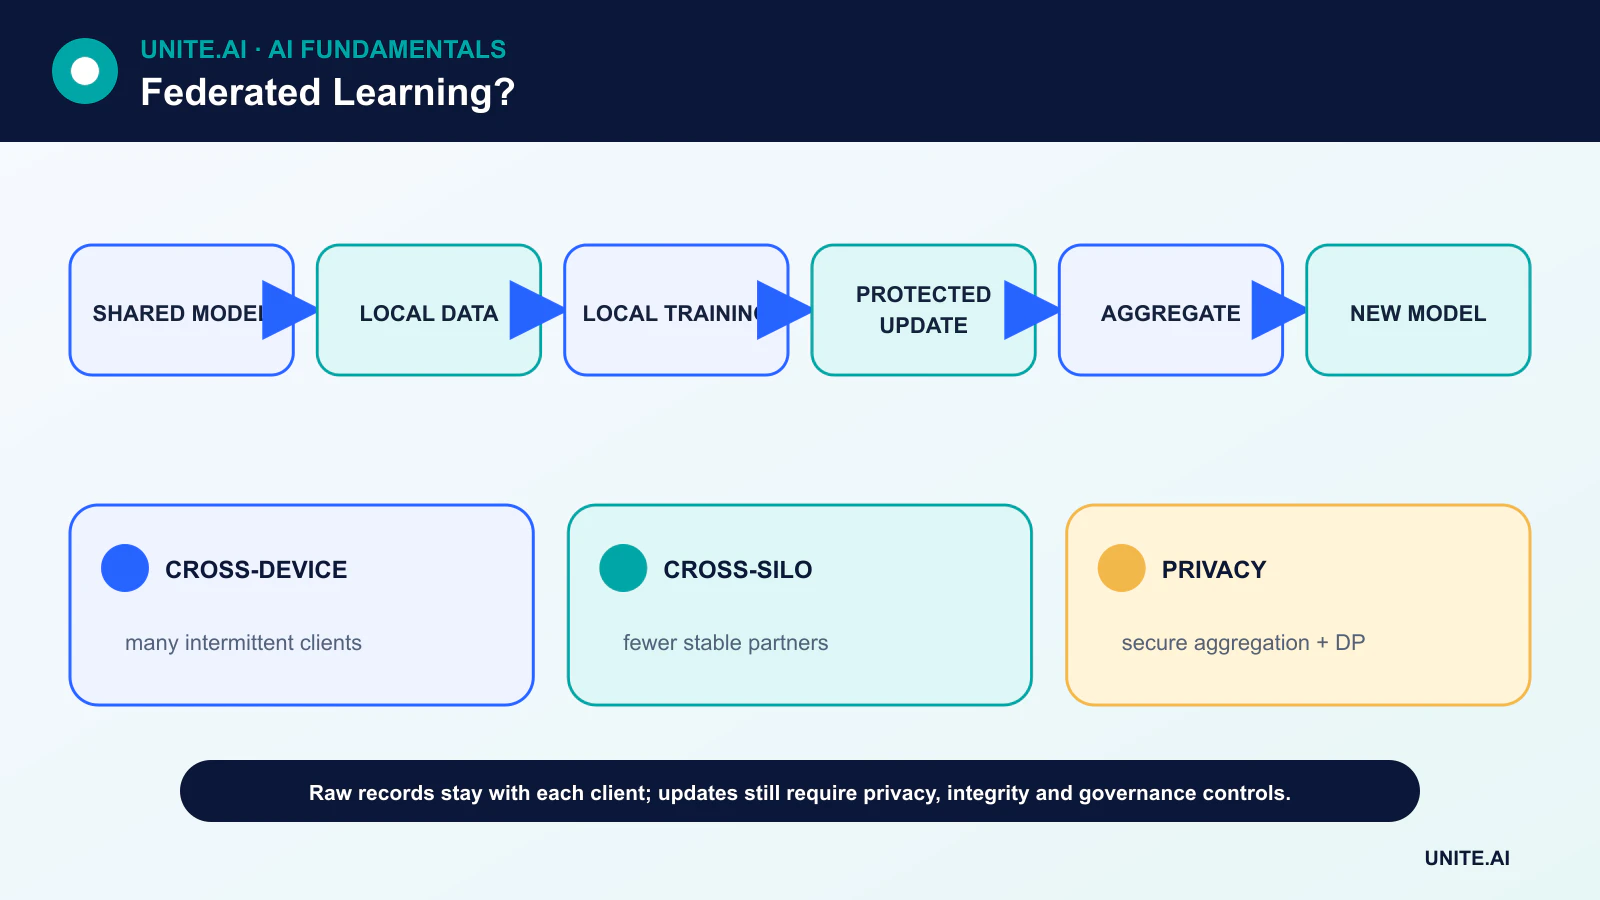
Livssyklusen for federert gjennomsnitt
En typisk runde starter når en koordinator velger kvalifiserte klienter og sender den nåværende modellen. Hver klient trener lokalt i et begrenset antall steg, og produserer en parameter‑ eller gradient‑oppdatering. Koordinatoren aggregerer de kvalifiserte oppdateringene — ofte med vekter basert på lokale eksempeltellinger — og publiserer den nye delte modellen.
Kun en brøkdel av klientene kan delta i hver runde. Protokollen må tåle tapte tilkoblinger, versjonskonflikter og enheter som ikke kan trene mens de lader, er opptatt eller offline. Kommunikasjon kan dominere beregning, så komprimering av oppdateringer og færre rundereiser er ofte viktigere enn rå akselerators hastighet.
Tverrenhet versus tversilo
Tverrenhet federert læring kan involvere telefoner, sensorer eller nettlesere som eies av mange individer. Klientene er mange, svakt betrodde og tilgjengelige intermittently. Tversilo federert læring kobler vanligvis et mindre sett av sykehus, banker eller forretningsenheter med stabil infrastruktur og kontraktsmessig styring.
De to innstillingene krever ulike antakelser om identitet, revisjon og feil. Et tversilo‑prosjekt kan forhandle frem et delt skjema og valideringsprosess; en tverrenhetstjeneste kan måtte håndtere millioner av programvareversjoner og svært ujevne lokale datasett.
Sikker aggregasjon, differensiell personvern og kryptering
Sikker aggregasjon er en kryptografisk protokoll som lar serveren gjenopprette en aggregat uten å lese hver klients oppdatering. Differensiell personvern begrenser hvor mye det publiserte resultatet kan avhenge av en enkelt post eller deltaker ved å klippe av bidrag og legge til kalibrert støy.
Ingen av mekanismene løser alle risikoer. Sikker aggregasjon gjør ikke aggregatet ufarlig, og differensiell personvern pålegger en nøyaktighets‑personvern‑avveining som må tas med i en eksplisitt personvern‑budsjett. Kryptering beskytter data under overføring eller lagring; den forhindrer ikke i seg selv inferens fra en modell.
Ikke‑IID‑data og modellkvalitet
Klientdata er sjelden uavhengige og identisk fordelte. En tastaturmodell ser hver persons vokabular; sykehus betjener ulike befolkninger; fabrikker bruker ulikt utstyr. Disse forskjellene kan bremse konvergens og skjule dårlig ytelse for små klientgrupper.
Evaluering bør inkludere globale måleverdier, per‑klient‑ eller kohortfordelinger, kalibrering og feilanalyse. Et sentralt testsett kan være praktisk, men er utilstrekkelig. Dette knytter federert læring til maskinlæring-datakvalitet og styring av strukturerte og ustrukturerte data.
Trusler og operative kontroller
Ondsinnede klienter kan sende forgiftede oppdateringer, sybil‑klienter kan forvrenge aggregasjonen, og en kompromittert server kan distribuere en målrettet modell. Forsvar inkluderer autentisert påmelding, avviksdeteksjon, robust aggregasjon, validering av oppdateringer, hastighetsbegrensninger og reproduserbar programvare‑attestasjon der det er praktisk.
Federert læring hører inn i et bredere cybersikkerhets-program. Team bør dokumentere hvem som kontrollerer koordinatoren, hvilke metadata som samles inn, hvordan deltakere kan trekke seg, hvordan modeller rulles tilbake og hva som skjer når personvern‑ eller kvalitetstester mislykkes.
Federert optimalisering og dataheterogenitet
Federert læring sender en modell eller oppgave til deltakende klienter, trener lokalt, og aggregerer oppdateringer uten å sentralisere rå eksempler. I federert gjennomsnitt kjører utvalgte klienter flere lokale optimaliseringstrinn, og serveren beregner et vektet gjennomsnitt, vanligvis etter antall eksempler. Kommunikasjonsrunder, lokale epoker, utvalg og læringsrater avveier båndbredde mot konvergens. Tverrenhetsinnstillinger involverer mange upålitelige telefoner eller sensorer; tversilo‑innstillinger involverer færre organisasjoner med sterkere beregning, identitet og styring.
Klientdata er vanligvis ikke‑uavhengige og ujevne: brukere varierer i atferd, etikettfordeling, volum og tilgjengelighet. Lokal trening kan avvike i inkompatible retninger, noe som gjør et enkelt gjennomsnitt ustabilt eller skjevt mot aktive høy‑volum‑klienter. Algoritmer kan bruke proksimale termer, adaptiv serveroptimalisering, klynging, personalisering eller kontrollvariabler. Evaluering bør rapportere global og klient‑nivå ytelse, tail‑klienter, deltakelsesfrekvens, konvergens, kommunikasjon og energi. Et godt gjennomsnitt kan skjule at små eller sjeldne klientpopulasjoner får en dårligere modell.
Personvern, sikkerhet og systemteknikk
Å holde data lokalt garanterer ikke personvern i seg selv. Gradienter og oppdateringer kan lekke medlemskap eller funksjoner, mens den endelige modellen kan memorere eksempler. Sikker aggregasjon skjuler individuelle oppdateringer fra serveren, og differensiell personvern begrenser informasjonsbidrag ved å klippe og legge til støy, men begge endrer nytte og operasjonell kompleksitet. Angi trusselmodellen, personvern‑enhet, budsjett og pålitelige komponenter. Kryptering under overføring er nødvendig, men hindrer ikke en ondsinnet klient, forgiftet oppdatering, kompromittert koordinator eller inferens‑angrep.
Forsvar inkluderer autentiserte klienter, robust aggregasjon, avviks‑kontroller, oppdateringsbegrensninger, sikre innhegninger i noen design, og validering mot rene data. Sybil‑angripere kan opprette mange klienter; bakdører kan overleve gjennomsnittet; å droppe mistenkelige oppdateringer kan også ekskludere legitim sjelden atferd. Versjonér klientkode, støtt avbrutte runder, forhindre gjentakelse, og design for etterslep og enhetsbegrensninger. Samtykke, lagring, regionale regler og sletting gjelder fortsatt for lokale data og avledede oppdateringer.
Eksempel på utrulling og styring
Et mobilt tastatur kan trene neste‑ord‑forbedringer lokalt, men utrulling bør bruke en befolkning som er kvalifisert etter enhetens kapasitet og samtykke, samle inn klippede beskyttede oppdateringer, og sammenligne med en frosset referanse. Valider språk‑ og dialekt‑ytelse, batteri, databruk og memoriseringsrisiko før lansering. Klienter trenger signerte treningsoppgaver og modelloppdateringer; serveren trenger reviderbar runde‑konfigurasjon og tilbakeføring. Federert læring er en arkitektur for distribuert læring under begrensninger, ikke en erstatning for representative data, personvern‑teknikk eller ansvarlighet.
Arbeidseksempel: federert læring på tvers av sykehus
Sykehus trener en delt bildkvalitetsmodell uten å samle skanninger. En felles protokoll definerer enhetsmetadata, etiketter, forhåndsbehandling, klientkvalifisering, lokale epoker, klipping og sikker aggregasjon. Stedene beholder pasientdata og sender inn beskyttede oppdateringer, mens en koordinator evaluerer hver runde på lokale hold‑out‑sett. Resultatene rapporterer ytelse på stedsnivå og tail‑ytelse, ikke bare et volum‑vektet gjennomsnitt, fordi små sykehus og enhetstyper ellers kan bli oversett.
Trusselmodellen dekker ondsinnede oppdateringer, medlemslekkasje, kompromitterte klienter og koordinator‑tilgang. Differensiell personvern er konfigurert med et dokumentert budsjett og testet nytte. Modell‑ og oppgavepakker er signert; steder kan trekke seg tilbake og oppdateringer er reviderbare. En forgiftet eller ustabil runde erstatter ikke den distribuerte modellen automatisk. Prosjektet beholder lokale referanser og klinisk gjennomgang, og behandler federert arkitektur som en personvernkontroll innen bredere samtykke‑, sikkerhets‑ og styringsforpliktelser.
Implementeringsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, innganger, utganger, avhengigheter, eier, og konsekvensen av hver viktig feil. Etabler en reproduserbar basislinje og et versjonert evalueringssett før finjustering. Test vanlige tilfeller, grensetilstander, feilformet eller manglende input, distribusjonsendring, avhengighetsavbrudd, misbruk, og gruppene eller miljøene som mest sannsynlig blir underbetjent. Mål oppgavekvalitet sammen med kalibrering eller usikkerhet, latens, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig vurderer kan reprodusere resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, bevar en sikker tilbakefallsplan, og verifiser overvåkning med bevisst injiserte feil. Operasjonell telemetri bør avdekke input‑kvalitet, output‑atferd, modell‑ eller regelversjon, avhengighetshelse, menneskelige overstyringer og bekreftede resultater uten å samle inn unødvendige sensitive data. Definer varslingsterskler og en responsansvarlig, og gjennomgå virkelige bevis etter utrulling i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, retningslinjer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelseslæring, sletting‑ og lagringsprosedyrer, og et tydelig punkt hvor det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Garanterer federert læring at private data ikke kan lekke?
Nei. Det reduserer flytting av rådata, men oppdateringer og endelige modeller kan fortsatt avsløre informasjon. Personvern krever en trusselmodell og ekstra tekniske og organisatoriske kontroller.
Når er sentralisert trening enklere?
Når data kan lovlig og trygt sentraliseres, er sentralisert trening ofte lettere å feilsøke, reprodusere og overvåke. Federert læring er begrunnet når distribusjon er et reelt krav, ikke bare et merkevaremål.
Primære referanser












