
Grunnleggende AI
Hva er meta‑læring?

 Legg til Unite.AI blant dine foretrukne kilder på Google
Meta‑læring trener et system over en fordeling av oppgaver slik at det kan tilpasse seg en ny, beslektet oppgave ved bruk av begrenset data eller beregning. Det blir ofte oppsummert som «å lære å lære», men det tekniske målet er mer presist: optimalisere læreren slik at erfaring fra tidligere oppgaver forbedrer tilpasningen til en senere.
Meta‑læring overlapper med few-shot learning og transfer learning, men begrepene er ikke utskiftbare. Few-shot beskriver mengden av mål‑data; transfer beskriver gjenbruk; meta‑læring gjør eksplisitt tilpasning på tvers av oppgaver til en del av treningen.
Viktige punkter
- Meta‑trening bruker mange oppgaver, ikke bare mange uavhengige eksempler.
- En N‑way K‑shot‑episode inneholder N klasser og K merkede støtte‑eksempler per klasse.
- Gradient‑baserte, metrikk‑baserte, minne‑baserte og lærte‑optimiserer‑metoder tilpasser seg på ulike måter.
- Ytelsen avhenger sterkt av om meta‑treningsoppgavene ligner måloppgaven.
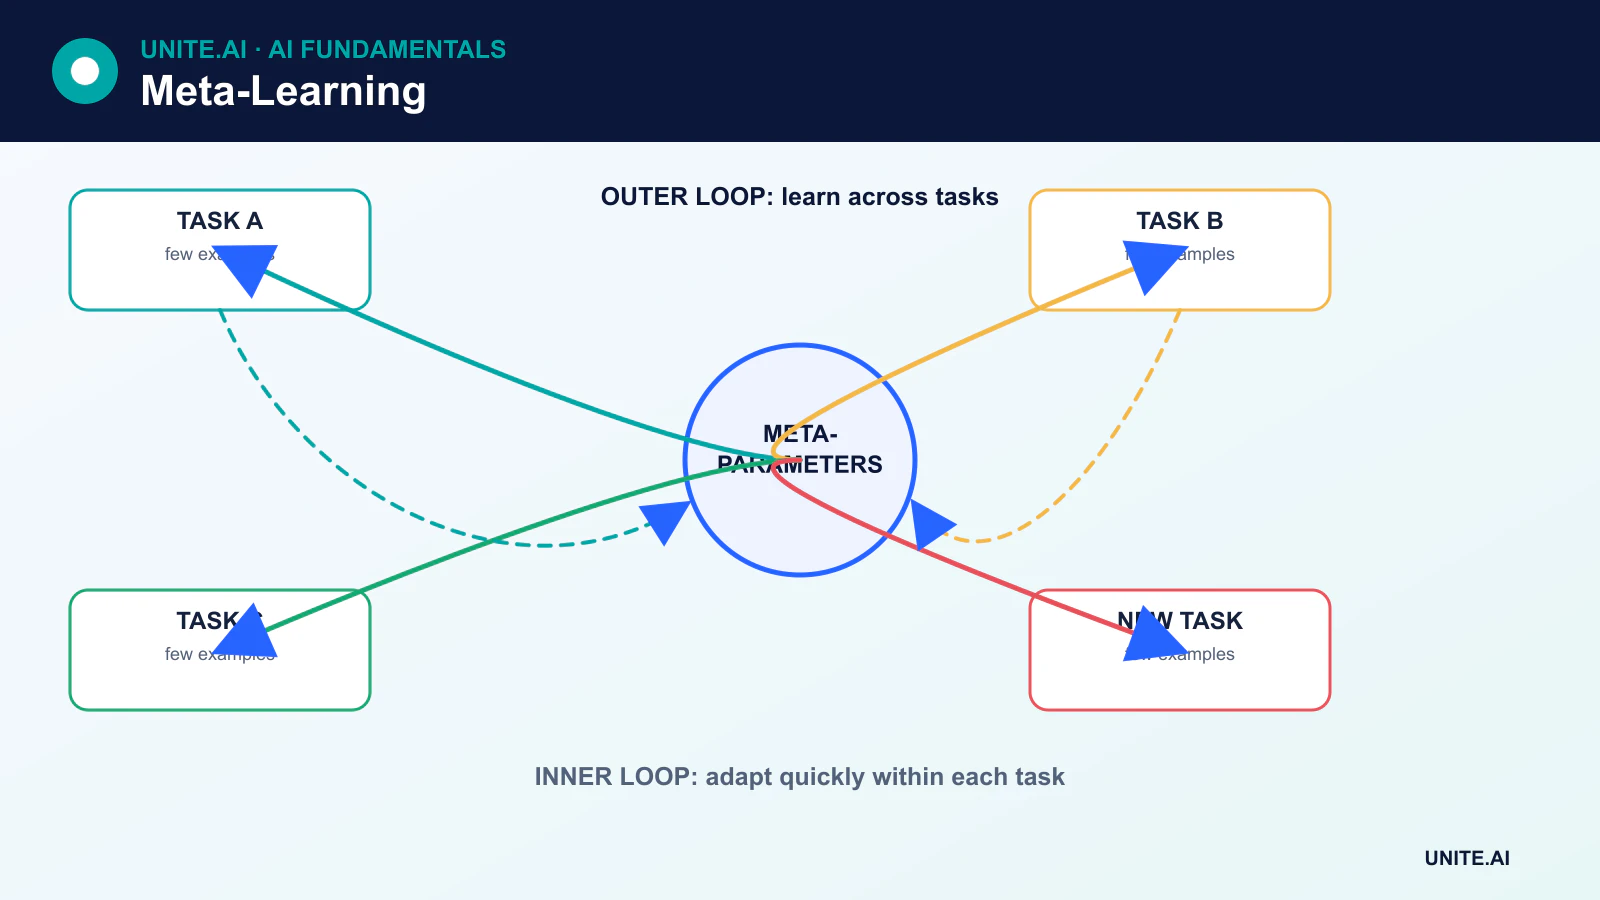
Oppgaver, støttemengder og spørringsmengder
Et meta‑læringsdatasett er organisert som oppgaver. I few‑shot‑klassifisering kan en episode være 5‑way 1‑shot: fem klasser, ett merket støtteeksempel per klasse, og ekstra spørringseksempler brukt til å evaluere tilpasning. En 5‑way 5‑shot‑oppgave har fem støtteeksempler for hver av fem klasser – ikke fem eksempler totalt.
Under meta‑trening tilpasser læreren seg gjentatte ganger på et støttemateriale og evalueres på et spørringssett. Det ytre målet forbedrer fremtidig spørringsytelse på tvers av oppgaver. Meta‑validering finjusterer valg på separate oppgaver, og meta‑testing evaluerer virkelig usette oppgaver eller klasser.
Gradient‑basert meta‑læring
Model‑Agnostic Meta‑Learning (MAML) lærer en initialisering som gjør at et lite antall gradient-steg gir god ytelse på en ny oppgave. Den indre løkken tilpasser modellparametere ved hjelp av støttedata. Den ytre løkken oppdaterer den delte initialiseringen ved å bruke spørringstap over utvalgte oppgaver.
MAML er ikke begrenset til klassifisering; den kan brukes på regresjon og reinforcement learning når modellen og oppgaven er differensierbare. Reptile tilbyr en enklere første‑ordens tilnærming som flytter parametere mot oppgave‑tilpassede løsninger uten å beregne den fulle MAML‑meta‑gradienten.
Metrikk‑basert meta‑læring
Metrikk‑baserte metoder lærer en innbygging der eksempler fra samme klasse er nær hverandre og ulike klasser er adskilt. Et prototypisk nettverk gjennomsnittliggjør støtteminnesrepresentasjoner for å danne én prototype per klasse, og klassifiserer deretter spørringer etter avstand til disse prototypene.
Matching‑ og Siamese‑lignende nettverk bruker beslektede likhetsmekanismer. Disse metodene sjekker ikke bare om en modell «treffer en mål‑metrik», men den lærte avstanden eller representasjonen er selv en del av prediksjonsprosedyren.
Minne‑baserte metoder og lærte optimerere
Minne‑baserte systemer bruker tilbakevendende eller oppmerksomhets‑basert tilstand for å lagre informasjon om den nåværende oppgaven. Lærte optimerere tar gradienter eller treningssignaler som input og lærer hvordan de skal oppdatere en annen modell. Disse metodene kan oppdage tilpasningsregler, men de tilfører parametere, beregning og et ekstra nivå av potensiell overtilpasning.
Meta‑læring og in‑context‑learning
Store transformers kan tilpasse outputen sin fra eksempler gitt i en prompt uten å oppdatere vekter. Dette kalles in‑context‑learning. Det ligner på meta‑læringsatferd, og treningsdata kan oppmuntre til oppgave‑inferenz, men en in‑context‑lærer blir ikke automatisk trent med et klassisk episodisk meta‑læringsmål.
Hvor meta‑læring er nyttig
Potensielle anvendelser inkluderer personalisering, robotikk, gjenkjenning med få ressurser, vitenskapelige oppgaver med få målinger, og rask tilpasning til nye miljøer. Meta‑læring er mest attraktiv når mange beslektede kildeoppgaver er tilgjengelige, men data for måloppgaven er knappe.
Begrensninger
Meta‑læring kan være beregningsmessig kostbar fordi trening nestler tilpasning innen optimalisering. Resultater er følsomme for oppgavekonstruksjon, støtt‑/spørrings‑lekkasje, arkitektur og domeneskifte. En modell trent på smale, homogene oppgaver kan tilpasse seg dårlig utenfor den fordelingen.
Sammenligninger bør inkludere vanlig transfer‑learning og multitask‑baselines. En sterk forhåndstrent representasjon etterfulgt av standard fin‑tuning kan være enklere og mer effektiv enn en dedikert meta‑læringsalgoritme.
Oppgaver, tilpasning og den indre‑ytre optimaliseringsstrukturen
Meta‑læring trener over en fordeling av oppgaver slik at en lærer kan tilpasse seg en ny oppgave med begrenset data eller oppdateringer. Hver episode trekker en oppgave, deler eksempler inn i et støttemateriale brukt for tilpasning og et spørringsmateriale brukt for evaluering, og oppdaterer delt kunnskap på tvers av episoder. Metrikk‑baserte metoder lærer en innbygging og sammenligningsregel; optimaliserings‑baserte metoder lærer initialisering eller oppdateringsatferd; minne‑ og modell‑baserte metoder betinger på oppgaveeksempler. Oppgavedistribusjonen er de faktiske treningsdataene og må ligne fremtidige tilpasningsproblemer.
I model‑agnostic meta‑learning tilpasser en indre løkke parametere på støtteeksempler, og en ytre løkke optimaliserer ytelsen på spørringseksempler etter tilpasning. Høyere‑ordens gradienter kan være kostbare; første‑ordens tilnærminger bytter nøyaktighet mot kostnad. Prototypiske nettverk representerer hver klasse med et støttemateriale‑sentroid og klassifiserer etter avstand. Disse metodene forutsetter at klassegeometri, tilpasningssteg og episode‑konstruksjon reflekterer implementering. En metode kan synes å lære raskt mens den utnytter faste etiketter, innhentingsartefakter eller overlapp mellom kildedatasett.
Evaluering, baselines og begrensninger i den virkelige verden
Separate trenings‑, validerings‑ og test‑oppgaver – ikke bare eksempler – for å måle tilpasning til virkelig usette oppgaver. Rapporter nøyaktighet eller tap som funksjon av shots og tilpasningssteg, konfidensintervaller på tvers av oppgaver, beregning, minne og sensitivitet til støttemateriales sammensetning. Sammenlign med transfer‑learning, fin‑tuning av en forhåndstrent modell, nærmeste naboer og en modell trent samlet på alle kilde‑data. Mange tilsynelatende meta‑læringsgevinster krymper når baselines får tilsvarende backbone, data‑augmentering og tuning.
Reelle implementeringer trenger en måte å gjenkjenne når en ny oppgave ligger utenfor meta‑treningsfordelingen. Dårlige eller feilmerkede støtteeksempler kan forårsake rask, selvsikker feil. Begrens oppdateringsstørrelse, valider tilpassede modeller, bevar en fallback, og beskytt tilpasningsdata mot forgiftning. Spor basismodell, oppgavesampler, episodeseeder og tilpasningskode. Meta‑læring er nyttig for gjentatte familier av små‑dataproblemer, men den skaper ikke generell læringsevne fra vilkårlige eksempler og fjerner ikke behovet for domenespesifikk evaluering.
Arbeidseksempel: few‑shot‑tilpasning på tvers av maskiner
En produsent behandler hver maskintype som en oppgave og meta‑trener en avviksrepresentasjon på tvers av mange maskiner med verifiserte vedlikeholdsresultater. Testmaskiner ekskluderes helt fra oppgavetreningen. For en ny maskin dekker et lite støttemateriale normale driftsmoduser i stedet for vilkårlige minutter med data. Meta‑læring sammenlignes med en forhåndstrent frossen enkoder, nærmeste naboer og vanlig fin‑tuning ved bruk av de samme støtteeksemplene og beregning.
Evalueringen gjentar mange støtteseleksjoner og rapporterer hendelses‑gjenkalling, falske alarmer, tilpasningstid og varians. Systemet avstår når den nye maskinens sensorsett eller dynamikk ligger utenfor oppgavedistribusjonen. Tilpasningsoppdateringer er begrenset og gjennomgått før de påvirker vedlikehold. Støtteetiketter og maskinidentitet beskyttes mot forgiftning, og hver tilpasset modell beholder sin basisversjon og eksempler. Rask tilpasning aksepteres kun dersom den konsekvent overgår enklere transfer under realistisk oppgave‑skifte.
Implementeringsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, innganger, utganger, avhengigheter, eier og konsekvensen av hver viktig feil. Etabler en reproduserbar basislinje og et versjonert evalueringssett før justering. Test vanlige tilfeller, grensetilstander, feilformet eller manglende input, distribusjonsskifte, avhengighets‑nedbrudd, misbruk, og gruppene eller miljøene som mest sannsynlig er underbetjent. Mål oppgavekvalitet sammen med kalibrering eller usikkerhet, latens, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig vurderer kan reprodusere resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåking med bevisst injiserte feil. Operasjonell telemetri bør avdekke input‑kvalitet, output‑atferd, modell‑ eller regelversjon, avhengighets‑helse, menneskelige overstyringer og bekreftede resultater uten å samle unødvendige sensitive data. Definer varslings‑terskler og en ansvarlig for respons, og gjennomgå bevis fra den virkelige verden etter utrulling i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, retningslinjer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelses‑læring, slettings‑ og lagringsprosedyrer, og et tydelig tidspunkt hvor det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Er few‑shot‑prompting meta‑læring?
Few‑shot‑prompting er en in‑context‑tilpasningsteknikk. Den kan vise atferd knyttet til læring på tvers av oppgaver, men den blir ikke automatisk trent med støtte‑/spørrings‑episoder eller en eksplisitt meta‑optimaliseringsløkke.
Hva er den største risikoen ved meta‑læring?
En misforhold mellom meta‑treningsoppgaver og måloppgaven kan få rask tilpasning til å fremstå sterk i en benchmark, men feile i produksjon. Oppgavedeling og kilde‑opprinnelse må revideres like grundig som vanlige trenings‑/test‑splitt.
Primære referanser











