
Das Beste
10 Beste Machine-Learning-Algorithmen

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Obwohl wir in einer Zeit außergewöhnlicher Innovation im Bereich der GPU-beschleunigten maschinellen Intelligenz leben, werden in den neuesten Forschungsarbeiten häufig Algorithmen vorgestellt, die Jahrzehnte, in einigen Fällen sogar 70 Jahre alt sind.
Einige könnten argumentieren, dass viele dieser älteren Methoden eher der statistischen Analyse als der maschinellen Intelligenz zuzurechnen sind und daher den Beginn des Sektors erst 1957 mit der Erfindung des Perceptrons datieren.
Angesichts des Ausmaßes, in dem diese älteren Algorithmen die neuesten Trends und bahnbrechenden Entwicklungen im Bereich der maschinellen Intelligenz unterstützen und mit ihnen verflochten sind, ist dies eine umstrittene Position. Lassen Sie uns also einige der “klassischen” Bausteine betrachten, die die neuesten Innovationen tragen, sowie einige neuere Einträge, die frühzeitig um einen Platz im AI-Hall of Fame buhlen.
1: Transformer
Im Jahr 2017 leitete Google Research eine Forschungskooperation, die in dem Paper Aufmerksamkeit ist alles, was Sie benötigen mündete. Die Arbeit skizzierte eine neue Architektur, die Aufmerksamkeitsmechanismen von “Piping” in Encoder/Decoder- und rekurrenten Netzmodellen zu einer zentralen transformationalen Technologie in ihrem eigenen Recht förderte.
Der Ansatz wurde Transformer genannt und ist seitdem zu einer revolutionären Methodik in der Verarbeitung von natürlicher Sprache (NLP) geworden, die unter anderem das autoregressive Sprachmodell und das AI-Posterkind GPT-3 antreibt.

Transformer löste das Problem der Sequenztransduktion elegant, auch bekannt als “Transformation”, das mit der Verarbeitung von Eingabesequenzen in Ausgabesequenzen befasst ist. Ein Transformer erhält und verwaltet auch Daten in einer kontinuierlichen Weise, anstatt in sequenziellen Chargen, was eine “Beharrung des Gedächtnisses” ermöglicht, die RNN-Architekturen nicht erreichen können. Für eine detailliertere Übersicht über Transformer siehe unser Referenzartikel.
Im Gegensatz zu den rekurrenten neuronalen Netzen (RNNs), die in der CUDA-Ära begonnen hatten, die ML-Forschung zu dominieren, konnte die Transformer-Architektur auch leicht parallelisiert werden, was den Weg frei machte, um produktiv eine viel größere Menge an Daten als RNNs zu bearbeiten.
Beliebte Verwendung
Transformer eroberte die öffentliche Vorstellungskraft im Jahr 2020 mit der Veröffentlichung von OpenAI’s GPT-3, das einen damals rekordbrechenden 175 Milliarden Parameter aufwies. Diese offensichtlich atemberaubende Leistung wurde später von anderen Projekten wie der 2021 veröffentlichten Microsofts Megatron-Turing NLG 530B in den Schatten gestellt, das (wie der Name schon sagt) über 530 Milliarden Parameter verfügt.

Eine Zeitleiste von hyperskaligen Transformer-NLP-Projekten. Quelle: Microsoft
Die Transformer-Architektur hat auch den Übergang von NLP zur Computer-Vision gemacht und treibt eine neue Generation von Bildsynthese-Frameworks wie OpenAI’s CLIP und DALL-E an, die Text-Bild-Domänen-Mapping verwenden, um unvollständige Bilder zu vervollständigen und neue Bilder aus trainierten Domänen zu synthetisieren, unter anderem.
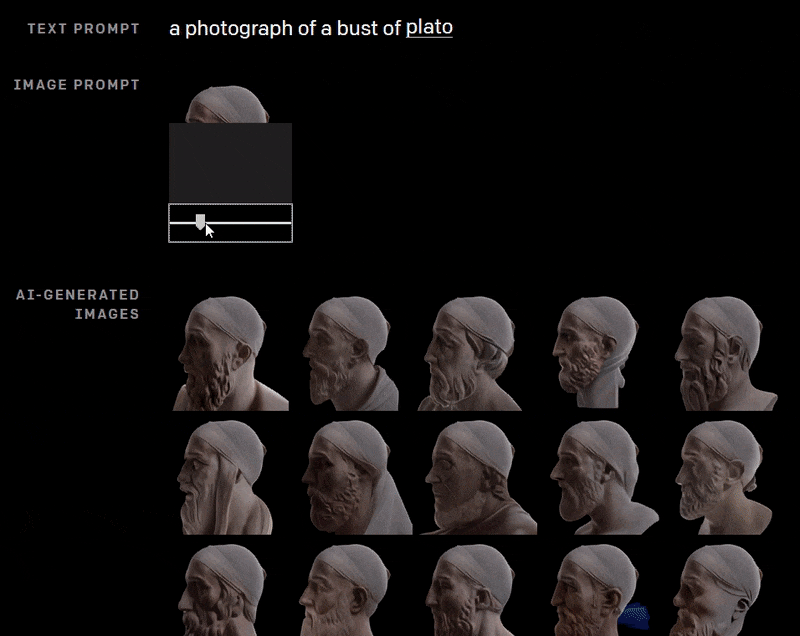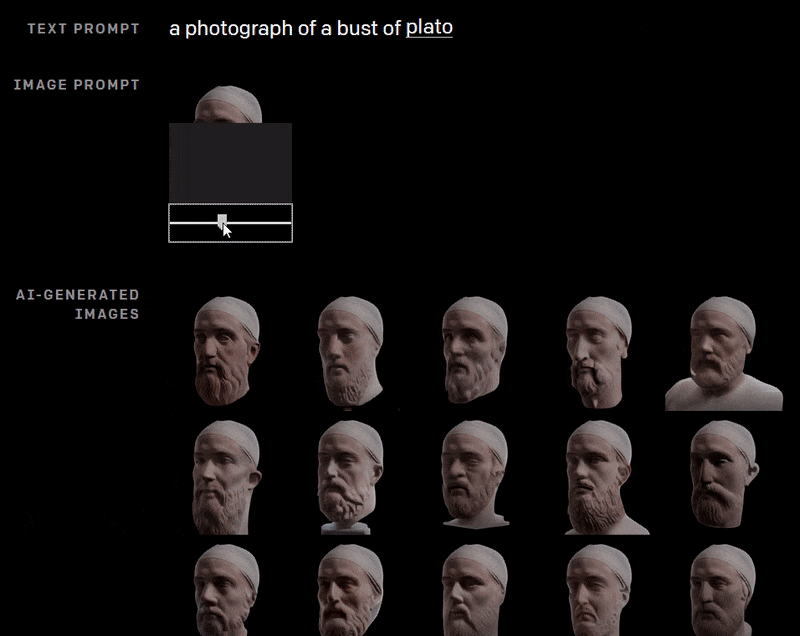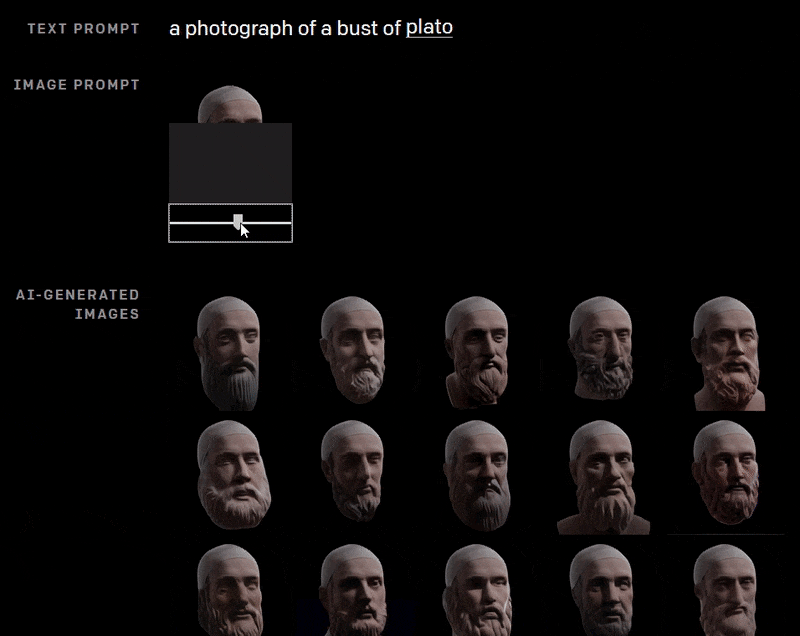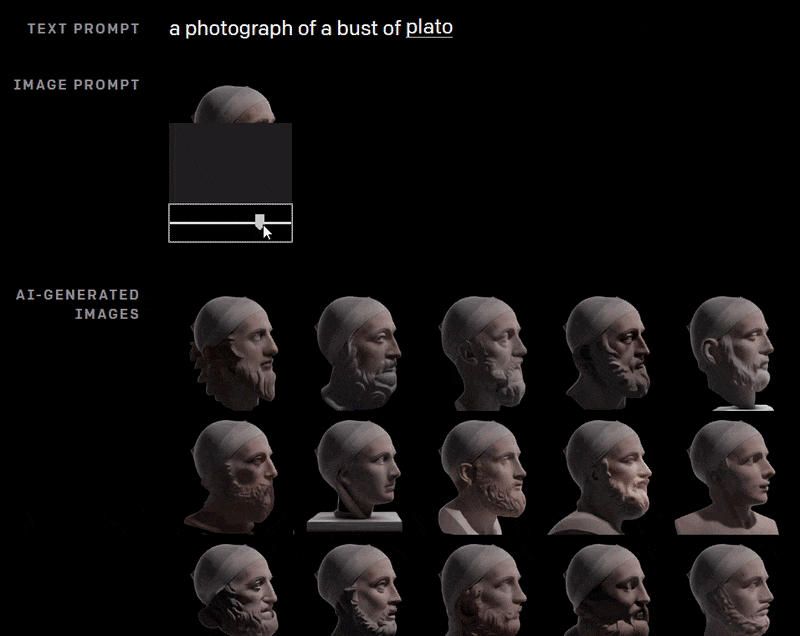
DALL-E versucht, ein teilweise Bild einer Platon-Büste zu vervollständigen. Quelle: https://openai.com/blog/dall-e/
2: Generative Adversarial Networks (GANs)
Obwohl Transformer durch die Veröffentlichung und Adoption von GPT-3 außergewöhnliche Medienberichterstattung erhalten haben, ist das Generative Adversarial Network (GAN) zu einer anerkannten Marke in seinem eigenen Recht geworden und könnte schließlich Deepfake als Verb beitreten.
Erstmals 2014 vorgeschlagen und hauptsächlich für Bildsynthese verwendet, besteht eine GAN-Architektur aus einem Generator und einem Diskriminator. Der Generator durchläuft Tausende von Bildern in einem Datensatz und versucht iterativ, sie nachzubilden. Für jeden Versuch bewertet der Diskriminator die Arbeit des Generators und sendet den Generator zurück, um es besser zu machen, ohne jedoch Einblick in die Art und Weise zu geben, in der die vorherige Rekonstruktion fehlgeschlagen ist.

Quelle: https://developers.google.com/machine-learning/gan/gan_structure
Dies zwingt den Generator, eine Vielzahl von Wegen zu erkunden, anstatt den potenziellen blinden Gassen zu folgen, die sich ergeben hätten, wenn der Diskriminator ihm gesagt hätte, wo er falsch lag (siehe #8 unten). Wenn die Ausbildung abgeschlossen ist, hat der Generator eine detaillierte und umfassende Karte der Beziehungen zwischen Punkten im Datensatz.
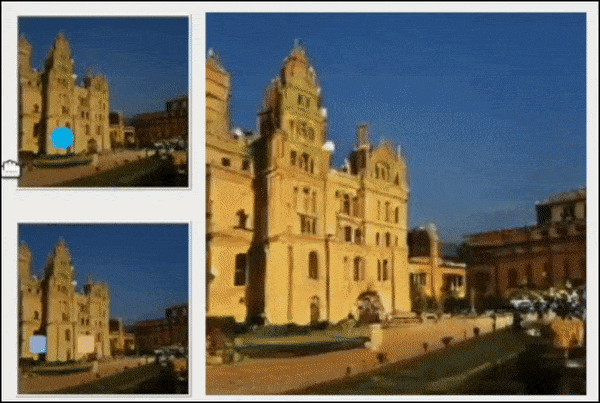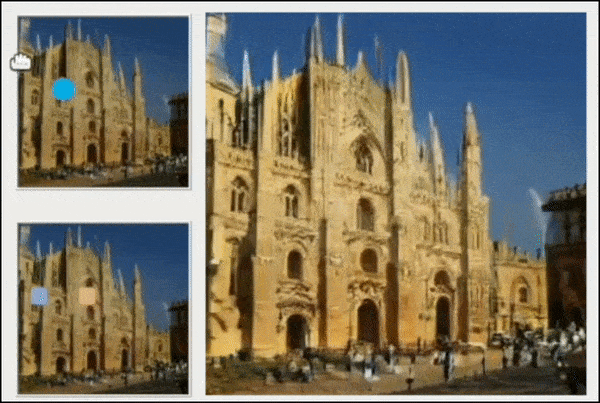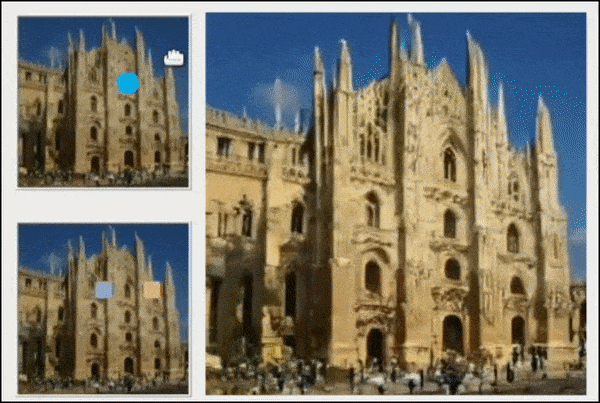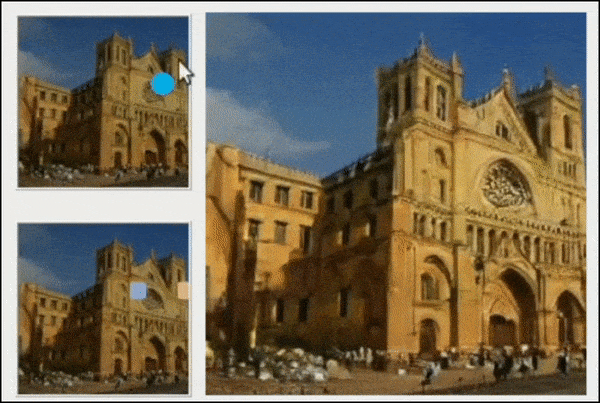
Ein Auszug aus dem Paper Verbesserung der GAN-Gleichgewicht durch Erhöhung des räumlichen Bewusstseins: ein neues Framework durchläuft den sometimes-mysteriösen latenten Raum einer GAN und bietet eine responsive Instrumentalität für eine Bildsynthese-Architektur. Quelle: https://genforce.github.io/eqgan/
Als Analogie ist dies der Unterschied zwischen dem Lernen einer einzigen langweiligen Fahrt in die Innenstadt von London oder dem mühsamen Erwerb von The Knowledge.
Das Ergebnis ist eine hochrangige Sammlung von Funktionen im latenten Raum des trainierten Modells. Der semantische Indikator für eine hochrangige Funktion könnte ‘Person’ sein, während ein Abstieg in die Spezifität im Zusammenhang mit der Funktion andere erlernte Merkmale wie ‘männlich’ und ‘weiblich’ aufdecken kann. Auf niedrigeren Ebenen können die Unterfunktionen in ‘blond’, ‘kaukasisch’ usw. zerfallen.
Verflechtung ist ein bemerkenswertes Problem im latenten Raum von GANs und Encoder/Decoder-Frameworks: Ist das Lächeln auf einem GAN-generierten weiblichen Gesicht eine verflochtene Funktion ihrer ‘Identität’ im latenten Raum oder ein paralleler Zweig?

GAN-generierte Gesichter von thispersondoesnotexist. Quelle: https://this-person-does-not-exist.com/en
Die letzten beiden Jahre haben eine wachsende Anzahl neuer Forschungsinitiativen in dieser Hinsicht hervorgebracht, die möglicherweise den Weg für eine fehlerfreie, Photoshop-ähnliche Bearbeitung des latenten Raums einer GAN ebnen, aber im Moment sind viele Transformationen effektiv ‘Alles-oder-Nichts’-Pakete. Bemerkenswerterweise erreicht NVIDIA’s EditGAN-Veröffentlichung von Ende 2021 ein hohes Maß an Interpretierbarkeit im latenten Raum durch die Verwendung semantischer Segmentierungsmasken.
Beliebte Verwendung
Neben ihrer (tatsächlich ziemlich begrenzten) Beteiligung an populären Deepfake-Videos haben bild-/videozentrierte GANs in den letzten vier Jahren verbreitet und sowohl Forscher als auch die Öffentlichkeit begeistert. Es ist eine Herausforderung, mit dem atemberaubenden Tempo und der Häufigkeit neuer Veröffentlichungen Schritt zu halten, obwohl das GitHub-Repository Awesome GAN Applications versucht, eine umfassende Liste bereitzustellen.
Generative Adversarial Networks können theoretisch Funktionen aus jedem gut strukturierten Bereich ableiten, einschließlich Text.
3: SVM
Ursprünglich 1963 entstanden, ist der Support-Vektor-Maschine (SVM) ein grundlegender Algorithmus, der häufig in neuen Forschungsarbeiten auftaucht. Unter SVM werden Vektoren die relative Anordnung von Datenpunkten in einem Datensatz kartieren, während Support-Vektoren die Grenzen zwischen verschiedenen Gruppen, Funktionen oder Merkmalen abstecken.

Support-Vektoren definieren die Grenzen zwischen Gruppen. Quelle: https://www.kdnuggets.com/2016/07/support-vector-machines-simple-explanation.html
Die abgeleitete Grenze wird als Hyperplane bezeichnet.
Bei niedrigen Funktionsniveaus ist die SVM zweidimensional (Bild oben), aber wenn es eine höhere Anzahl von Gruppen oder Typen gibt, wird sie dreidimensional.

Eine tiefere Anordnung von Punkten und Gruppen erfordert eine dreidimensionale SVM. Quelle: https://cml.rhul.ac.uk/svm.html
Beliebte Verwendung
Da Support-Vektor-Maschinen hochdimensionale Daten vieler Arten effektiv und agnostisch bearbeiten können, tauchen sie in einer Vielzahl von maschinellen Lernsektoren auf, einschließlich Deepfake-Erkennung, Bildklassifizierung, Hasssprachenerkennung, DNA-Analyse und Populationsstrukturvorhersage, unter anderem.
4: K-Means-Clustering
Clustering im Allgemeinen ist ein unsupervised Learning-Ansatz, der versucht, Datenpunkte durch Dichteschätzung zu kategorisieren und eine Karte der Verteilung der zu untersuchenden Daten zu erstellen.

K-Means-Clustering ermittelt Segmente, Gruppen und Gemeinschaften in Daten. Quelle: https://aws.amazon.com/blogs/machine-learning/k-means-clustering-with-amazon-sagemaker/
K-Means-Clustering ist die beliebteste Implementierung dieses Ansatzes und führt Datenpunkte in distinkte ‘K-Gruppen’, die demografische Sektoren, Online-Gemeinschaften oder jede andere mögliche geheime Aggregation darstellen können, die in rohen statistischen Daten entdeckt werden kann.

Cluster bilden sich in der K-Means-Analyse. Quelle: https://www.geeksforgeeks.org/ml-determine-the-optimal-value-of-k-in-k-means-clustering/
Der K-Wert selbst ist der bestimmende Faktor bei der Nützlichkeit des Prozesses und bei der Festlegung eines optimalen Werts für einen Cluster. Anfangs wird der K-Wert zufällig zugewiesen, und seine Funktionen und Vektormerkmale werden mit seinen Nachbarn verglichen. Die Nachbarn, die dem Datenpunkt mit dem zufällig zugewiesenen Wert am meisten ähneln, werden iterativ seinem Cluster zugewiesen, bis die Daten alle Gruppierungen ergeben, die der Prozess zulässt.
Die Grafik für den quadrierten Fehler oder ‘Kosten’ der unterschiedlichen Werte zwischen den Clustern wird einen Ellenbogpunkt für die Daten aufzeigen:

Der ‘Ellenbogpunkt’ in einer Cluster-Grafik. Quelle: https://www.scikit-yb.org/en/latest/api/cluster/elbow.html
Der Ellenbogpunkt ist ähnlich wie der Weg, auf dem der Verlust bei einem Trainingsabschnitt für einen Datensatz abflacht und zu vernachlässigbaren Rückgaben führt. Er stellt den Punkt dar, an dem keine weiteren Unterschiede zwischen Gruppen mehr erkennbar sind, was den Zeitpunkt markiert, um zu den nächsten Phasen in der Datenpipeline überzugehen oder die Ergebnisse zu melden.
Beliebte Verwendung
K-Means-Clustering ist aus offensichtlichen Gründen eine primäre Technologie in der Kundenanalyse, da es eine klare und erklärbare Methodik bietet, um große Mengen an kommerziellen Aufzeichnungen in demografische Erkenntnisse und ‘Leads’ zu übersetzen.
Außerhalb dieser Anwendung wird K-Means-Clustering auch für Erdrutschvorhersage, medizinische Bildsegmentierung, Bildsynthese mit GANs, Dokumentenklassifizierung und Stadtplanung eingesetzt, unter anderem.
5: Random Forest
Random Forest ist ein Ensemble-Learning-Verfahren, das das Ergebnis aus einem Array von Entscheidungsbäumen mittelt, um eine Gesamtvorhersage für das Ergebnis zu erstellen.

Quelle: https://www.tutorialandexample.com/wp-content/uploads/2019/10/Decision-Trees-Root-Node.png
Wenn Sie es auch nur so weit recherchiert haben, wie es das Ansehen der Zurück-in-die-Zukunft-Trilogie ist, ist ein Entscheidungsbaum selbst ziemlich einfach zu konzeptualisieren: Eine Reihe von Wegen liegt vor Ihnen, und jeder Weg verzweigt sich in ein neues Ergebnis, das wiederum weitere mögliche Wege enthält.
In Reinforcement-Learning könnten Sie von einem Weg zurücktreten und von einer früheren Position aus neu beginnen, während Entscheidungsbäume ihre Reisen festlegen.
Der Random-Forest-Algorithmus ist im Wesentlichen ein Streuverhalten bei Entscheidungen. Der Algorithmus wird ‘zufällig’ genannt, weil er ad hoc-Auswahlen und Beobachtungen trifft, um den Median der Ergebnisse aus dem Entscheidungsbaum-Array zu verstehen.
Da er eine Vielzahl von Faktoren berücksichtigt, kann ein Random-Forest-Ansatz schwieriger zu bedeutsamen Grafiken umzusetzen sein als ein Entscheidungsbaum, aber wahrscheinlich produktiver.
Entscheidungsbäume sind anfällig für Overfitting, wo die Ergebnisse datenspezifisch sind und nicht wahrscheinlich verallgemeinert werden. Die willkürliche Auswahl von Datenpunkten durch Random Forest bekämpft diese Tendenz und bohrt sich durch zu bedeutsamen und nützlichen repräsentativen Trends in den Daten.

Entscheidungsbaum-Regression. Quelle: https://scikit-learn.org/stable/auto_examples/tree/plot_tree_regression.html
Beliebte Verwendung
Wie bei vielen Algorithmen in dieser Liste operiert Random Forest typischerweise als ‘früher’ Sortier- und Filterprozess für Daten und taucht daher regelmäßig in neuen Forschungspapieren auf. Einige Beispiele für die Verwendung von Random Forest sind Magnetresonanzbildsynthese, Bitcoin-Preisvorhersage, Bevölkerungssegmentierung, Textklassifizierung und Kreditkartenbetrugsbekämpfung.
Da Random Forest ein niedriges Algorithmus in maschinellen Lernarchitekturen ist, kann es auch zur Leistung anderer niedriger Algorithmen beitragen, sowie zu Visualisierungsalgorithmen, einschließlich induktiver Clustering, Funktionstransformationen, Klassifizierung von Textdokumenten unter Verwendung von Sparse-Funktionen und Anzeige von Pipelines.
6: Naive Bayes
In Kombination mit der Dichteschätzung (siehe 4 oben) ist ein Naive-Bayes-Klassifizierer ein leistungsstarker, aber relativ leichter Algorithmus, der in der Lage ist, Wahrscheinlichkeiten auf der Grundlage der berechneten Funktionen der Daten zu schätzen.

Funktionsbeziehungen in einem Naive-Bayes-Klassifizierer. Quelle: https://www.sciencedirect.com/topics/computer-science/naive-bayes-model
Der Begriff ‘naiv’ bezieht sich auf die Annahme in Bayes’ Theorem, dass Funktionen nicht miteinander in Beziehung stehen, bekannt als bedingte Unabhängigkeit. Wenn Sie diese Haltung einnehmen, sind Gehen und Sprechen wie eine Ente nicht ausreichend, um zu bestimmen, dass es sich um eine Ente handelt, und keine ‘offensichtlichen’ Annahmen werden vorzeitig angenommen.
Dieses Maß an akademischer und investigativer Strenge wäre übertrieben, wenn ‘gesunder Menschenverstand’ verfügbar ist, aber es ist ein wertvoller Standard, wenn Sie die vielen Mehrdeutigkeiten und potenziell nicht miteinander in Beziehung stehenden Korrelationen durchlaufen, die in einem maschinellen Lern-Datensatz existieren können.
In einem ursprünglichen Bayesian-Netzwerk unterliegen Funktionen Bewertungsfunktionen, einschließlich minimaler Beschreibungslänge und Bayesian-Bewertung, die Einschränkungen für die Daten in Bezug auf die geschätzten Verbindungen zwischen den Datenpunkten und die Richtung, in der diese Verbindungen fließen, auferlegen können.
Ein Naive-Bayes-Klassifizierer hingegen operiert, indem er annimmt, dass die Funktionen eines gegebenen Objekts unabhängig sind, und verwendet dann Bayes’ Theorem, um die Wahrscheinlichkeit eines gegebenen Objekts auf der Grundlage seiner Funktionen zu berechnen.
Beliebte Verwendung
Naive-Bayes-Filter sind in Krankheitsvorhersage und Dokumentenkategorisierung, Spam-Filterung, Stimmungsklassifizierung, Empfehlungssysteme und Betrugsbekämpfung vertreten, unter anderem.
7: K-Nearest Neighbors (KNN)
Erstmals 1951 von der US Air Force School of Aviation Medicine vorgeschlagen und an die Hardware der Mitte des 20. Jahrhunderts angepasst, ist K-Nearest Neighbors (KNN) ein schlanker Algorithmus, der immer noch in akademischen Papieren und maschinellen Lernforschungsinitiativen im privaten Sektor eine wichtige Rolle spielt.
KNN wird als ‘fauler Lerner’ bezeichnet, da es den gesamten Datensatz durchsucht, um die Beziehungen zwischen Datenpunkten zu bewerten, anstatt das Training eines vollständigen maschinellen Lernmodells zu erfordern.

Eine KNN-Gruppierung. Quelle: https://scikit-learn.org/stable/modules/neighbors.html
Obwohl KNN architektonisch schmal ist, stellt sein systematischer Ansatz eine bemerkenswerte Nachfrage an Lese- und Schreiboperationen, und seine Verwendung in sehr großen Datensätzen kann ohne zusätzliche Technologien wie Hauptkomponentenanalyse (PCA) problematisch sein, die komplexe und hochvolumige Datensätze in repräsentative Gruppierungen umwandeln können, die KNN mit weniger Aufwand durchlaufen kann.
Ein jüngste Studie bewertete die Effektivität und Wirtschaftlichkeit einer Reihe von Algorithmen, die die Aufgabe hatten, vorherzusagen, ob ein Mitarbeiter ein Unternehmen verlassen wird, und fand heraus, dass der siebzigjährige KNN immer noch den modernen Mitbewerbern in Bezug auf Genauigkeit und Vorhersageeffektivität überlegen war.
Beliebte Verwendung
Trotz seiner Popularität ist KNN nicht im Jahr 1950 stecken geblieben – es wurde in einen DNN-orientierteren Ansatz umgewandelt, in einem 2018 von der Pennsylvania State University vorgeschlagenen Vorschlag, und bleibt ein zentraler früher Prozess (oder postprozessuales Analysewerkzeug) in vielen komplexeren maschinellen Lernframeworks.
In verschiedenen Konfigurationen wurde KNN für Online-Signaturüberprüfung, Bildklassifizierung, Textmining, Ertragsvorhersage und Gesichtserkennung verwendet, unter anderem.

Ein KNN-basiertes Gesichtserkennungssystem in der Ausbildung. Quelle: https://pdfs.semanticscholar.org/6f3d/d4c5ffeb3ce74bf57342861686944490f513.pdf
8: Markov-Entscheidungsprozess (MDP)
Ein mathematisches Framework, das 1957 von dem amerikanischen Mathematiker Richard Bellman eingeführt wurde, ist der Markov-Entscheidungsprozess (MDP) einer der grundlegendsten Bausteine von Reinforcement-Learning-Architekturen. Ein konzeptioneller Algorithmus in seinem eigenen Recht, wurde es in eine Vielzahl von anderen Algorithmen adaptiert und taucht häufig in der aktuellen Forschung im Bereich KI/ML auf.
MDP erkundet eine Datenumgebung, indem es seine Bewertung des aktuellen Zustands (d. h. ‘wo’ es in den Daten ist) verwendet, um zu entscheiden, welchen Knoten der Daten es als Nächstes erkunden soll.

Quelle: https://www.sciencedirect.com/science/article/abs/pii/S0888613X18304420
Ein grundlegender Markov-Entscheidungsprozess priorisiert kurzfristige Vorteile gegenüber wünschenswerteren langfristigen Zielen. Aus diesem Grund wird es normalerweise in den Kontext einer umfassenderen Richtlinienarchitektur in Reinforcement-Learning eingebettet und ist oft begrenzenden Faktoren wie abgezogenem Lohn und anderen modifizierenden Umweltvariablen unterworfen, die es daran hindern, zu einem unmittelbaren Ziel ohne Berücksichtigung des umfassenderen gewünschten Ergebnisses zu eilen.
Beliebte Verwendung
MDP’s niedriges Konzept ist in Forschung und aktiver Einsatz von maschinellem Lernen weit verbreitet. Es wurde für IoT-Sicherheitsverteidigungssysteme, Fischfang und Marktprognose vorgeschlagen.
Abgesehen von seiner offensichtlichen Anwendbarkeit auf Schach und andere streng sequenzielle Spiele ist MDP auch ein natürlicher Kandidat für die prozedurale Ausbildung von Robotiksystemen, wie wir im folgenden Video sehen können.
9: Term-Frequenz-Inverse-Dokument-Frequenz
Term-Frequenz (TF) teilt die Anzahl der Male, die ein Wort in einem Dokument vorkommt, durch die Gesamtzahl der Wörter in diesem Dokument. So hat das Wort Siegel, das einmal in einem tausend Wörter umfassenden Artikel vorkommt, eine Term-Frequenz von 0,001. Da TF allein als Indikator für die Bedeutung eines Terms größtenteils nutzlos ist, weil bedeutungslose Artikel (wie a, und, die und es) dominieren, wird Inverse-Dokument-Frequenz (IDF) verwendet, um die TF eines Wortes über mehrere Dokumente in einem Datensatz zu berechnen und niedrige Bewertungen für sehr häufige Stoppwörter wie Artikel zuweisen. Die resultierenden Funktionsvektoren werden auf ganze Werte normalisiert, und jedem Wort wird ein entsprechendes Gewicht zugewiesen.

TF-IDF bewertet die Relevanz von Termen basierend auf Häufigkeit über eine Reihe von Dokumenten, wobei seltene Vorkommen ein Indikator für Bedeutung sind. Quelle: https://moz.com/blog/inverse-document-frequency-and-the-importance-of-uniqueness
Obwohl dieser Ansatz verhindert, dass semantisch wichtige Wörter als Ausreißer verloren gehen, bedeutet das Umkehren der Frequenzgewichtung nicht automatisch, dass ein niedrigfrequentes Term nicht ein Ausreißer ist, da einige Dinge selten und wertlos sind. Daher muss ein niedrigfrequenter Term seinen Wert im umfassenderen architektonischen Kontext unter Beweis stellen, indem er (auch bei niedriger Frequenz pro Dokument) in einer Reihe von Dokumenten im Datensatz vorkommt.
Trotz seines Alters ist TF-IDF eine leistungsstarke und beliebte Methode für anfängliche Filterläufe in NLP-Frameworks.
Beliebte Verwendung
Weil TF-IDF zumindest teilweise an der Entwicklung von Googles weitgehend okkulter PageRank-Algorithmen in den letzten zwanzig Jahren beteiligt war, ist es sehr weit verbreitet als manipulativer SEO-Taktik angenommen worden, trotz John Muellers Ablehnung seiner Bedeutung für Suchergebnisse im Jahr 2019.
Da die PageRank-Algorithmen geheim sind, gibt es keine klaren Beweise dafür, dass TF-IDF nicht derzeit eine effektive Taktik für eine bessere Platzierung in Googles Rankings ist. Kontroversen unter IT-Professionals deuten auf ein populäres Verständnis hin, richtig oder falsch, dass Term-Missbrauch immer noch zu einer verbesserten SEO-Platzierung führen kann (obwohl zusätzliche Anschuldigungen von Monopolmissbrauch und exzessive Werbung die Grenzen dieser Theorie verwischen).
10: Stochastischer Gradientenabstieg
Stochastischer Gradientenabstieg (SGD) ist eine zunehmend beliebte Methode für die Optimierung des Trainings von maschinellen Lernmodellen.
Gradientenabstieg selbst ist eine Methode zur Optimierung und anschließenden Quantifizierung der Verbesserung, die ein Modell während des Trainings macht.
In diesem Sinne zeigt ‘Gradient’ eine Abnahme (und nicht eine farbliche Abstufung, siehe Bild unten), wobei der höchste Punkt des ‘Hügels’, links, den Beginn des Trainingsprozesses darstellt. Zu diesem Zeitpunkt hat das Modell den gesamten Datensatz noch nicht einmal gesehen und hat nicht genug über Beziehungen zwischen den Daten gelernt, um effektive Transformationen zu produzieren.

Ein Gradientenabstieg in einer FaceSwap-Trainingsession. Wir können sehen, dass das Training für einige Zeit in der zweiten Hälfte plateauartig verläuft, aber schließlich seinen Weg den Gradienten hinunter zu einer akzeptablen Konvergenz wiederfindet.
Der tiefste Punkt, rechts, stellt die Konvergenz (den Punkt, an dem das Modell so effektiv ist, wie es unter den auferlegten Einschränkungen und Einstellungen jemals sein wird) dar.
Der Gradient dient als Aufzeichnung und Vorhersage für die Diskrepanz zwischen der Fehlerrate (wie genau das Modell die Datenbeziehungen derzeit kartiert) und den Gewichten (die Einstellungen, die den Lernprozess des Modells beeinflussen).
Diese Aufzeichnung des Fortschritts kann verwendet werden, um einen Lernrateplan zu informieren, ein automatischer Prozess, der der Architektur sagt, granularer und präziser zu werden, wenn die frühen vagen Details in klare Beziehungen und Kartierungen umgewandelt werden. Der Gradientenverlust bietet im Wesentlichen eine just-in-time-Karte, wo das Training als Nächstes hingehen soll und wie es vorgehen soll.
Die Innovation des Stochastischen Gradientenabstiegs besteht darin, dass es die Modellparameter in jedem Trainingsbeispiel pro Iteration aktualisiert, was im Allgemeinen den Weg zur Konvergenz beschleunigt. Aufgrund des Auftretens von Hyperskalendatensätzen in den letzten Jahren ist SGD in letzter Zeit an Popularität gewonnen als eine mögliche Methode, um die daraus resultierenden logistischen Probleme anzugehen.
Andererseits hat SGD negative Auswirkungen auf die Merkmalsskalierung und kann mehr Iterationen erfordern, um das gleiche Ergebnis zu erzielen, was zusätzliche Planung und zusätzliche Parameter erfordert, im Vergleich zu regulärem Gradientenabstieg.
Beliebte Verwendung
Aufgrund seiner Konfigurierbarkeit und trotz seiner Mängel ist SGD zum beliebtesten Optimierungsalgorithmus für die Anpassung von neuronalen Netzen geworden. Eine Konfiguration von SGD, die in neuen KI/ML-Forschungspapieren dominant wird, ist die Wahl des adaptiven Momentenschätzers (ADAM, eingeführt 2015) als Optimierer.
ADAM passt die Lernrate für jeden Parameter dynamisch an (‘adaptive Lernrate’) und integriert auch Ergebnisse aus vorherigen Updates in die nachfolgende Konfiguration (‘Impuls’). Darüber hinaus kann es so konfiguriert werden, dass es spätere Innovationen wie Nesterov-Impuls verwendet.
Einige argumentieren jedoch, dass die Verwendung von Impuls ADAM (und ähnlichen Algorithmen) zu einem suboptimalen Schluss führen kann. Wie bei den meisten Bereichen der KI/ML-Forschung ist SGD ein laufendes Projekt.
Erstveröffentlichung 10. Februar 2022. Geändert 10. Februar 20.05 EET – Formatierung.


