
AIの基礎
機械学習とは何か?

 Unite.AI を Google の優先ソースに追加
機械学習 (ML) は、システムがデータからパターンを学習し、開発者があらゆるケースに対して個別のルールを書かなくても、予測・分類・レコメンド・意思決定を行えるようにする人工知能の一分野です。その結果は、人間のように「考える」機械ではなく、入力を有用な出力にマッピングする統計モデルであり、学習時に見ていないデータでも評価できます。
機械学習は AI の広い領域の中に位置し、ディープラーニング は多層ニューラルネットワークを中心とした機械学習手法のファミリーです。この区別は重要です:すべての AI システムが機械学習を用いるわけでもなく、すべての機械学習課題がニューラルネットワークを必要とするわけでもありません。
主なポイント
- ML は手書きルールだけに依存せず、例から関係性を学習します。
- 有用なモデルはトレーニングデータを単に暗記するのではなく、新しいデータに一般化できなければなりません。
- 教師あり、教師なし、半教師あり、自己教師あり、強化学習はそれぞれ異なる問題に適用されます。
- データ品質、評価設計、モニタリングはアルゴリズムと同等に重要です。
機械学習の仕組み
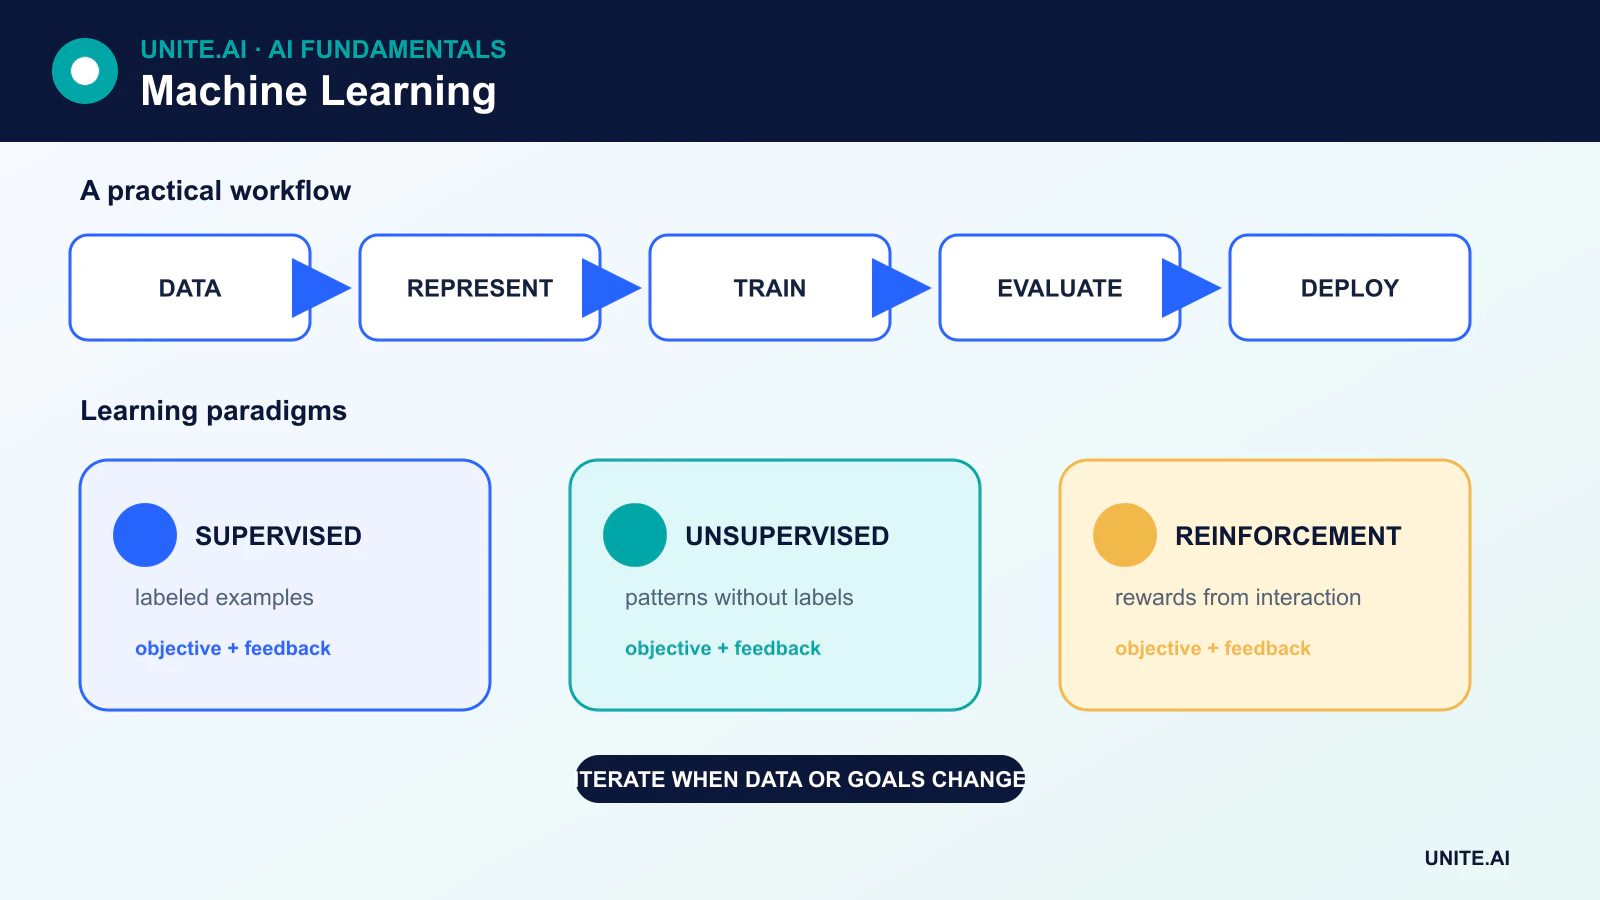
ほとんどのMLプロジェクトは、6つのステージのシーケンスとして理解できます:
- タスクを定義する。 システムが何を予測または発見すべきか、実際のアプリケーションで成功とは何かを決めます。
- データを収集・整備する。 記録をクリーンアップし、欠損値を処理し、有用な特徴量を作成し、データの出所を文書化します。
- データを分割する。 トレーニングセットはモデルのフィッティングに、バリデーションセットはハイパーパラメータ選択に、テストセットは未見データ上の最終評価に使用します。
- モデルを訓練する。 アルゴリズムは損失関数を最小化するか、別の学習目的を満たすようにモデルパラメータを調整します。
- 一般化性能を評価する。 指標はタスク、クラスバランス、エラーコスト、モデルが稼働する対象集団を反映すべきです。
- デプロイとモニタリングを行う。 実運用データは変化し得るため、ドリフト、性能低下、バイアス、運用障害を監視します。
モデルに供給される変数は一般に 特徴量 と呼ばれます。教師あり学習では、求められる答えは ラベル または ターゲット と呼ばれます。モデルが学習したパラメータは特徴量と出力の関係性をエンコードしており、明示的なルールのデータベースではありません。
主な学習パラダイム
教師あり学習
教師あり学習 では、入力と既知のターゲットの両方が含まれた例が提供されます。分類モデルは取引が不正かどうかといったカテゴリを予測し、回帰モデルは予想エネルギー需要のような連続値を予測します。
代表的な教師ありアルゴリズムには、決定木、サポートベクターマシン、k近傍法、線形回帰・ロジスティック回帰、勾配ブースティング木、そしてニューラルネットワーク があります。0.5 のような分類閾値は、モデルがスコアや確率を出した後に決めるもので、ロジスティック回帰の不変属性ではありません。
教師なし学習
教師なし学習はターゲットラベルを含まないデータで動作します。目的はクラスタの発見、異常観測の検出、分布の推定、あるいは低次元表現の作成などです。クラスタは類似性ルールに基づくグループであり、必ずしも実世界で意味のあるクラスになるわけではありません。
例としては、k-means クラスタリング、主成分分析、密度推定、そして一部のオートエンコーダがあります。オートエンコーダは圧縮表現を通じて入力を再構築することを学習しますが、真のラベルを自動的に生成するわけではありません。
半教師あり学習と自己教師あり学習
半教師あり学習 は、少量のラベル付きデータと大量のラベルなしデータを組み合わせます。自己教師あり学習 はデータ自体から学習信号を作り出します。例えば、マスクされた単語を予測したり、同一画像の二つの変換ビューをマッチさせたりします。自己教師ありは、テキスト・画像・音声・動画といった大規模コレクションを人手でラベル付けせずに利用できるため、近年のトランスフォーマーや基盤モデルパイプラインの中心的手法です。
強化学習
強化学習 では、エージェントが環境内で行動を取り、報酬またはコストを受け取ります。目的は期待累積報酬を最大化する方策を学習することです。これは、すべての状態に対して正解の行動が与えられる教師あり学習とは異なり、行動が次にエージェントが遭遇するデータを左右する点が特徴です。
トレーニング、バリデーション、一般化
トレーニング例で高性能を示すモデルでも、新しいデータでは失敗することがあります。この失敗は 過学習 と呼ばれます。チームは適切なモデル容量、正則化、交差検証、データ拡張、情報漏洩防止、そして真に独立したテストセットを用いて過学習を抑制します。
すべてのMLタスクに対して単一の指標は存在しません。分類では精度だけでなく、適合率、再現率、F1、キャリブレーション、あるいはコスト加重指標が必要になることがあります。回帰では平均絶対誤差、二乗平均平方根誤差、またはドメイン固有の損失が用いられます。クラスタリングは内部評価指標や外部検証指標が必要です。指標はエラーがユーザーや組織にとって何を意味するかを反映すべきです。
機械学習アルゴリズムはツールであり、保証ではない
アルゴリズムは前提を伴います。線形モデルは特定の関係形態を仮定し、k近傍法は距離が意味ある類似性を表すと仮定し、ナイーブベイズはクラスが与えられたとき特徴が条件付き独立であると仮定します。決定木は学習した分割ルールで特徴空間を分割し、葉は単一観測ではなく訓練観測のグループに基づく予測を保持します。
したがって、モデル選択はデータサイズ、特徴量の種類、レイテンシ要件、解釈性の必要性、ミスのコストに依存します。データが限られている場合や運用上速度と透明性が求められる場合、シンプルなモデルが大規模モデルを上回ることがあります。
機械学習の活用領域
ML は検索ランキング、レコメンデーション、予測、異常検知、翻訳、音声認識、コンピュータビジョン、予知保全、詐欺検出、科学分析などに利用されます。同じ技術は歴史的バイアスを増幅したり、機密情報を露出したり、分布シフト下で予測が不安定になることもあります。責任あるデプロイには文書化、適切な人間の監視、セキュリティテスト、継続的モニタリングが必要です。
問題定義から有効な機械学習実験まで
機械学習プロジェクトはアルゴリズムではなく、意思決定と測定可能な成果から始めるべきです。予測単位、ターゲット、観測時点、意思決定時点、利用可能な特徴量、各エラーのコストを定義します。例えば解約後のイベントを用いると解答が漏洩します。シンプルなルールまたは統計的ベースラインを設定し、時間、顧客、地域、またはデプロイを反映する境界でデータを分割します。ランダムな行分割はほぼ同一の観測をトレーニングとテストに混入させ、誤ったスコアを生む可能性があります。
特徴量エンジニアリングは生データをモデルが利用できる表現に変換しますが、すべての特徴量には出所と利用可能性の保証が必要です。正規化、語彙、欠損補完、次元削減はトレーニングデータのみに適用し、学習した変換をバリデーションとテストに適用します。交差検証はサンプル間のばらつきを推定し、最終的な未使用テストセットはリリース判断を支えます。指標は結果に基づき選択します:不均衡な分類エラーには適合率と再現率、確率が行動を駆動する場合はキャリブレーション、ミスの運用影響が異なる場合はコストまたはユーティリティ加重指標を用います。
デプロイ、モニタリング、責任ある運用
本番推論はトレーニング時の全変換を再現し、レイテンシ、スループット、可用性の制約下で予測を返します。前処理をモデルと共にパッケージ化し、入力スキーマを検証し、アーティファクトにバージョンを付与し、オフラインとサービス実装間の結果を比較します。デフォルトの0.5ではなく、運用容量とエラーのトレードオフに基づいて閾値を選択します。シャドウ評価、限定コホート、またはガードレール指標を伴う実験でロールアウトします。依存障害や許容できない挙動に備えて決定論的なフォールバックとロールバック経路を保持します。
入力品質、特徴量ドリフト、予測分布、キャリブレーション、サブグループ結果、レイテンシ、コスト、そして最終的に得られるラベルを監視します。ドリフトは再学習が有効かどうかの自動的な証明ではなく、調査すべきシグナルです。再学習にはレビュー済みデータ、再現可能なテスト、承認、そして現在のチャンピオンモデルとの比較が必要です。意図された利用と不適切な利用、データ権利、プライバシー、セキュリティ、人間のオーバーライド、影響を受ける人々への訴えの手順を文書化します。機械学習は保守される意思決定システムであり、モデルファイルは交換可能なコンポーネントの一つに過ぎません。
実例:設備故障予測
ある製造業者は「機械‑日」単位で予測を定義します:その日開始時点で取得できるテレメトリだけを用いて、7日以内に検証済みの故障が起きるかどうかを予測します。機械と時間でデータを分割し、年齢・閾値ベースのルールと比較し、トレーニングデータで前処理を学習し、イベント再現率、誤警報、警告リードタイム、キャリブレーション、保守容量を評価します。センサー交換や計画的停止は通常の観測として扱わず、運用コンテキストとしてモデル化します。
モデルはまずシャドウモードで稼働します。アラートは寄与テレメトリと不確実性を示しますが、保守担当者が点検の可否を判断します。検証済み原因はラベル化され、作業指示がないことは故障が無いことを意味しません。段階的ロールアウトはアラート上限と手動フォールバックを使用し、モニタリングはセンサー健全性、入力ドリフト、レビュー済み精度、ダウンタイム、不要保守を追跡します。再学習はデータと閾値のレビューで現在のデプロイシステムを上回る改善が見込めると判断したときにのみ実施します。
実装証拠と運用準備性
本番での意思決定には、成功したデモだけでは不十分です。対象ユーザー、運用環境、入力・出力、依存関係、所有者、重要な失敗ごとの影響を定義します。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立します。通常ケース、境界条件、破損または欠損入力、分布シフト、依存障害、誤用、そして過小サービス化が懸念されるグループや環境をテストします。タスク品質とともにキャリブレーション・不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティを測定します。すべての変換と閾値を記録し、独立したレビューアが結果を再現できるようにし、魅力的なプロトタイプと証拠を区別します。
リリース前に、リリース、例外、変更、ロールバック、廃止の権限を割り当てます。段階的ロールアウトを使用し、安全なフォールバックを保持し、意図的に注入した障害でモニタリングを検証します。運用テレメトリは入力品質、出力挙動、モデルまたはルールのバージョン、依存の健全性、人間のオーバーライド、確認済み結果を示し、不要な機密データは収集しません。アラート閾値と対応責任者を定義し、デプロイ後に実世界の証拠をレビューします。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目的が変わるたびに再評価します。保守されたシステムは、復旧手順、インシデント学習、削除・保持手順、そして無効化または置換すべき明確な時点を文書化する必要があります。
主要参考文献












