
AIの基礎
決定木とは何か?

 Unite.AI を Google の優先ソースに追加
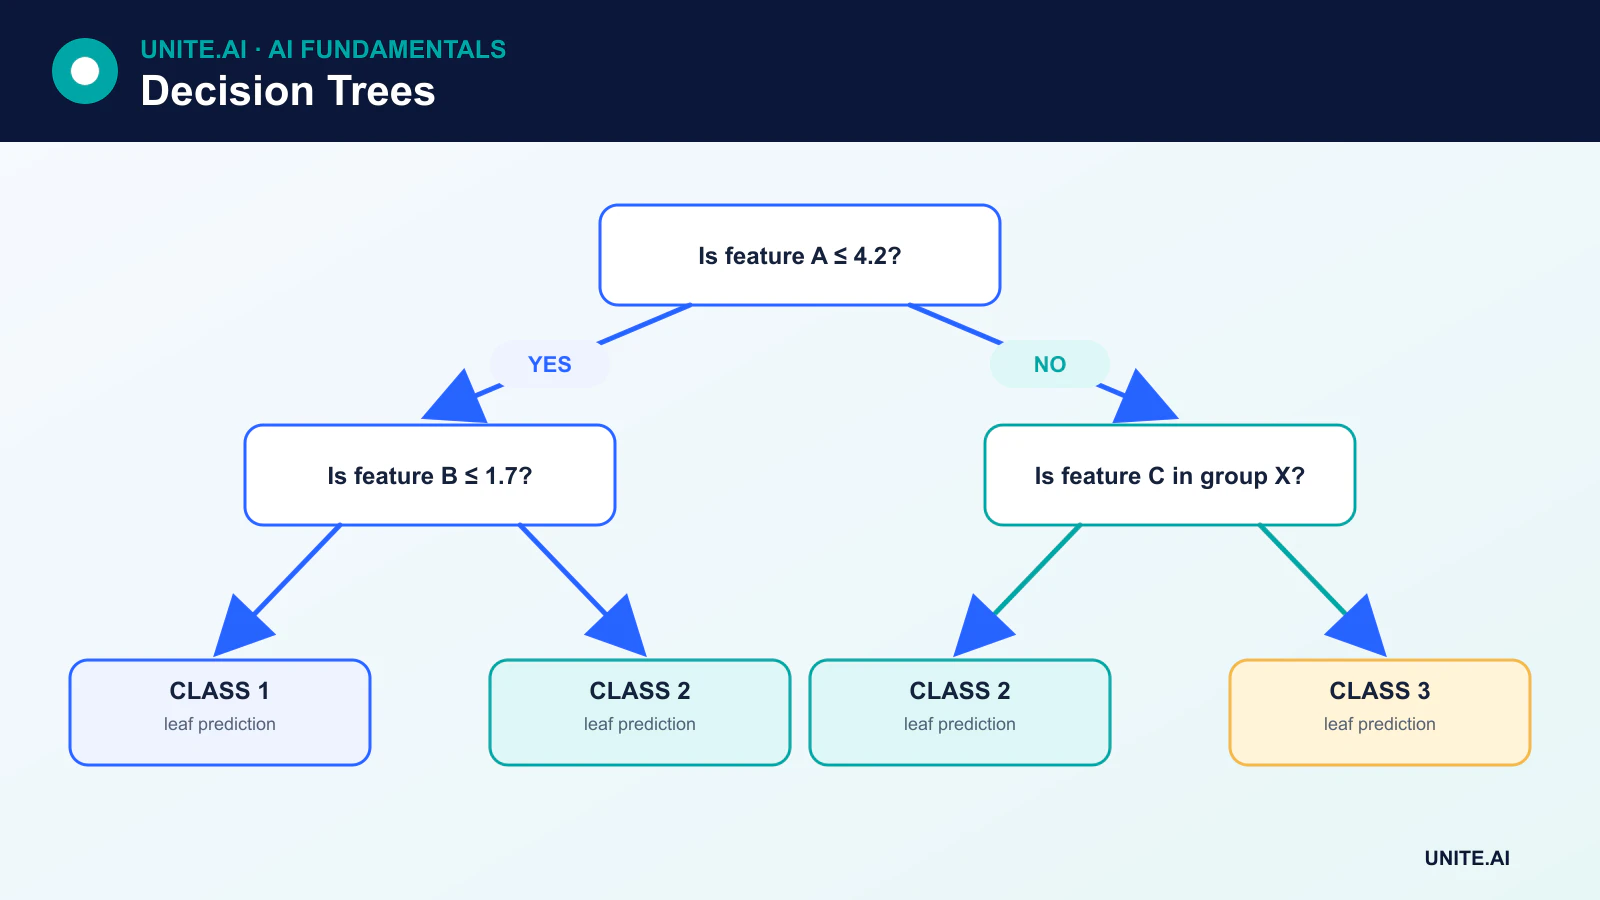
決定木は、if-then ルールのシーケンスを適用して予測を行う教師あり学習モデルです。各内部ノードは特徴量をテストし、各枝はそのテストの結果を表し、各リーフはクラス予測、確率、または数値を出力します。
決定木は分類と回帰に使用されます。その魅力は実用的: 非線形の相互作用を表現でき、前処理が比較的少なくて済み、かつ人が検査できる予測パスを生成します。欠点は不安定性で、訓練データのわずかな変化でも別の木が生成されることがあります。
主なポイント
- 木は特徴空間を再帰的に分割しますが、すべての訓練サンプルを個別に分離する必要はありません。
- 分類の分割では一般的にジニ不純度またはエントロピーが使用され、回帰の分割では予測誤差や分散を減らすことが目的とされます。
- 深さ、最小リーフサイズ、そして剪定は複雑さと過学習を制御します。
- ランダムフォレストと勾配ブースト木は、多数の木を組み合わせることで予測性能を向上させます。
決定木が予測を行う仕組み
例えば、あるモデルが機械の故障可能性を予測するとします。根ノードは振動が学習された閾値を超えているかどうかを尋ねるかもしれません。その後の枝は動作温度をテストします。観測は、同じパスをたどった訓練例の中で推定された故障確率を含むリーフに到達します。
回帰の場合、リーフはその領域内の観測の目標値の平均を返すことがあります。分類の場合、過半数クラスまたはクラス頻度の分布を返すことがあります。リーフは多数の観測を含むことができ、訓練データを完全に分離することは通常望ましくありません。なぜなら、過学習した木が生成される可能性があるからです。
木が分割を選択する方法
学習では候補となる特徴量と閾値を検討し、定義された目的関数を最も改善する分割を選択します。その改善度は、各子ノードに割り当てられる観測数で重み付けされなければなりません。
ジニ不純度
分類において、ジニ不純度はノード内のクラスがどれだけ混在しているかを測定します:
Gini = 1 - Σ p(k)²
1つのクラスしか含まないノードの不純度はゼロです。子ノードの加重不純度が親ノードの不純度より低い場合、その候補分割は有用とみなされます。
エントロピーと情報利得
エントロピーはクラスの不確実性を測る別の指標です:
Entropy = -Σ p(k) log₂ p(k)
情報利得は親ノードのエントロピーから加重子ノードのエントロピーを差し引いたものです。ジニ不純度とエントロピーはしばしば類似した木を生成しますが、必ずしも同一とは限りません。
回帰損失
回帰木は一般に二乗誤差、絶対誤差、または他の回帰基準を減少させる分割を選択します。各リーフはその領域内の訓練目標に基づいて値を予測します。
CART とその他の木アルゴリズム
CART(Classification and Regression Trees の略)は二分割を用い、scikit-learn の決定木などの一般的な実装の基盤となっています。他のアルゴリズムには ID3、C4.5、C5.0 があります。実装ごとにサポートされる分割タイプ、欠損値の取り扱い、剪定、目的関数が異なります。
カテゴリ変数はエンコーディングや直接的な部分集合分割、実装固有の取り扱いが必要になることがあります。欠損値は補完するか、学習されたデフォルト方向や代替分割を通じて処理できます。すべての木実装が同じ動作をするとは限らないため、使用するライブラリの挙動を理解することが重要です。
木の複雑さの制御
深い木はノイズを記憶してしまうことがあります。一般的な制御手段は以下の通りです:
- 最大深さ: 予測パスの長さを制限します。
- 分割またはリーフあたりの最小サンプル数: 小さすぎる領域を防ぎます。
- 最小不純度減少: 分割が十分な利益をもたらすことを要求します。
- リーフの最大数: 全体の複雑さを上限します。
- コスト複雑度剪定: 改善が追加の複雑さに見合わない枝を削除します。
剪定は構造化された最適化プロセスであり、ランダムな削除ではありません。ハイパーパラメータは検証データまたは交差検証で選択すべきで、最終的なテストセットは手を付けずに残しておきます。
長所と制限
決定木は特徴量のスケーリングなしで相互作用や閾値効果をモデル化できます。数値入力はもちろん、実装によってはカテゴリ入力も受け付けます。予測は高速で、サイズの小さい木は視覚化が容易です。
しかし、単一の木は分散が大きく、分割付近で予測が急激に変化しやすく、分割点が多数ある特徴を好む傾向があります。回帰においては外挿が苦手で、観測された領域外でもリーフは訓練サンプルから学んだ値を返します。大きな木は別の複雑なモデルと同程度に理解しにくいことがあります。
単一の木からアンサンブルへ
アンサンブル学習は�数のモデルを組み合わせます。ランダムフォレストは再サンプリングされた観測と特徴のサブセットで多数の木を訓練し、予測を平均化します。勾配ブースティングは木を順次構築し、各新しい木が残りの誤差に対処します。これらの手法は通常、単一の木よりも性能が優れますが、解釈性が低下し計算コストが増加します。
木やアンサンブルから得られる特徴重要度は慎重に解釈すべきです。不純度ベースの重要度はバイアスがかかりやすく、特徴の重要度が因果関係を示すわけではありません。置換重要度、部分依存ツール、ドメインレビューが追加の文脈を提供します。
木が分割と予測を学習する方法
決定木は特徴空間を再帰的に分割します。各ノードで、学習アルゴリズムは候補となる特徴の閾値やカテゴリ分割を評価し、分類ではジニ不純度やエントロピー、回帰では二乗誤差など、最も不純度を減少させる分割を選択します。リーフはそこに到達した訓練観測に基づくクラス分布または数値予測を保持します。貪欲な分割は計算上実用的ですが、全体で最適な木を保証するものではなく、サンプルや tie-breaking の違いにより構造が変わることがあります。
連続、順序、カテゴリ、欠損の各特徴は明示的な取り扱いが必要です。ワンホットエンコーディングは多数の候補分割を生み出すことがあります。ネイティブなカテゴリ手法は順序統計を利用できますが、情報漏洩を防ぐ実装が必要です。木はスケーリングを必要としませんが、高カーディナリティ変数を好み、小さなグループを分離しやすくなります。深さ、最小リーフサイズ、最小不純度減少、コスト複雑度剪定は分散を制御します。これらは検証データで選択し、キャリブレーションを評価すべきです。少数のケースに基づくリーフ確率は極端で不安定になる可能性があります。
解釈、失敗モード、実運用での利用
根からリーフへのパスは特定のモデル予測に対する正確なルールですが、必ずしも因果的説明になるわけではありません。相関した変数は互いに代替可能であり、データのわずかな変化が上位の分割を変えることがあります。また、見た目がシンプルなパスでもバイアスのかかったラベルに依存していることがあります。不純度に基づく全体的な特徴重要度は誤解を招くことがあり、置換重要度、部分依存、反事実チェックが文脈を提供しますが、前提条件も伴います。不確実性を報告し、提案されたルールが独立したデータや関連サブグループで成立するか検証してください。
単一の木は透明性、低レイテンシ、適度な非線形構造が重要な場合に有用ですが、アンサンブルは通常、より高い予測性能を提供します。境界動作、稀少カテゴリ、欠損、訓練範囲外の入力を検証してください。エクスポートされたルールは訓練時の前処理と数値比較を正確に再現しなければなりません。リーフの占有率、出力分布、エラー、出現する新しいカテゴリを監視します。多数の新規ケースが極小または以前は空だった領域にルーティングされた場合、全体的なドリフトが小さくてもレビューをトリガーすべきです。無効なスキーマに対するフォールバックを保持し、すべての剪定や閾値の決定を文書化してください。
実例:解釈可能なローン・トリアージ木
貸し手は、クレジットの承認・拒否ではなく、未完成の申請を手動審査の優先順位付けにのみ木を使用します。目的は文書化された完成度の結果であり、受付時に利用できる特徴は後続の判断を除外します。グループ化された時系列検証では、浅い剪定木とルール、ロジスティック回帰を比較します。最小リーフサイズは少数の申請者に基づくルールを防ぎ、キャリブレーションとクラス別エラーはチャネルや関連する保護されたグループごとに報告されます。
レビュアーは正確なパスと元データを確認でき、誤ったデータを修正したりルーティングを上書きしたりできます。組織は相関する代替指標や反事実的変更をテストし、リーフの占有率と欠損を監視し、少量のリーフへの急激なトラフィックをデータ品質のインシデントとみなします。ポリシー変更は新しいモデルバージョンと検証を生み、未文書化の分割編集は行いません。利用がアクセスや負担に影響するため、応募者は人的チャネルを受け取り、木は信用力の因果的説明として提示されません。
実装の証拠と運用準備
本番での導入判断は、成功したデモだけでは不十分です。対象ユーザー、運用環境、入力・出力、依存関係、所有者、重要な障害ごとの影響を定義します。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立します。通常ケース、境界条件、形式不正または欠損入力、分布シフト、依存障害、誤用、そしてサービスが行き届きにくいグループや環境をテストします。タスク品質をキャリブレーションや不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティと共に測定します。すべての変換と閾値を記録し、独立したレビューアが結果を再現でき、魅力的なプロトタイプと証拠を区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止に関する権限を割り当てます。段階的ロールアウトを使用し、安全なフォールバックを保持し、意図的に注入した障害でモニタリングを検証します。運用テレメトリは、入力品質、出力挙動、モデルまたはルールのバージョン、依存の健全性、人間の上書き、確認済み結果を示すべきで、不要な機密データは収集しません。アラート閾値と対応責任者を定義し、デプロイ後に実世界の証拠をレビューし、オフライン性能が持続すると仮定しないでください。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目的が変わるたびに再評価します。維持されたシステムは、復旧手順、インシデント学習、削除・保持手順、そして無効化または置換すべき明確なポイントを文書化する必要があります。
主要参考文献












