
AIの基礎
アンサンブル学習とは何か?

 Unite.AI を Google の優先ソースに追加
Ensemble learningは複数のモデルからの予測を組み合わせます。中心的な考え方は、エラーが異なるモデルの出力を平均化、投票、またはメタラーナーに渡すことで、より正確かつ安定した結果が得られるということです。
モデルを追加するだけでは不十分です。すべてのメンバーが同じショートカットを学習すると、エラーが相関し、アンサンブルは同じ誤りに対して単に自信を持つだけになる可能性があります。
主なポイント
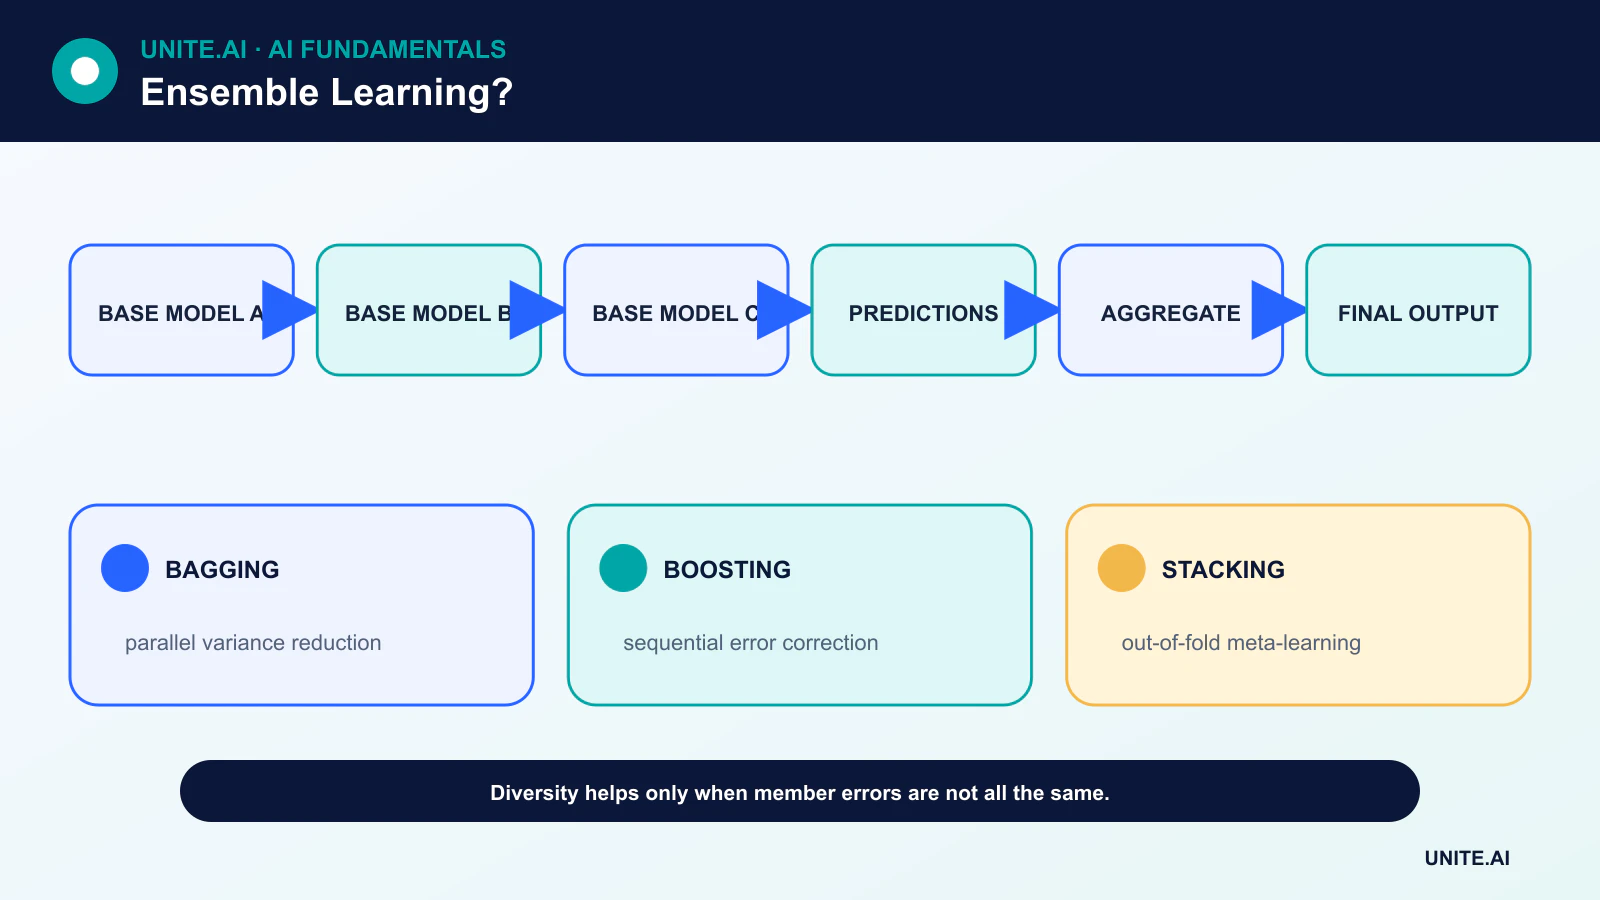
- アンサンブルは、各メンバーモデルが個別に有用で、意味のある異なるエラーを出す場合に最も効果的です。
- バギングは再サンプリングしたデータでメンバーを並列に学習させ、ブースティングはエラーを修正するために学習者を順次訓練します。
- スタッキングは、サンプル内予測ではなく、アウト・オブ・フォールド予測に基づいてメタモデルを学習させます。
- 精度向上は、レイテンシ、キャリブレーション、解釈可能性、保守コストと比較して評価する必要があります。
投票と平均化
ハード投票は最も多数の票を得たクラスを選択します。ソフト投票はクラス確率を平均化し、通常はキャリブレーション後に行います。回帰アンサンブルは数値予測を平均化することが多いです。重み付きバージョンは、より強力なメンバーにより大きな影響力を与えます。
エラーが完全に相関していない場合、平均化は分散を減少させることができます。しかし、共通のデータ欠陥やラベルエラー、欠損したサブグループを修復することはできません。多様性は、異なるモデル名から推測するのではなく、意見の不一致やエラーの重複度合いで測定すべきです。
バギングとランダムフォレスト
ブートストラップ集約は、再サンプリングしたデータセット上でモデルを学習し、結果を平均化します。決定木は分散が大きく、バギングの自然な候補となります。
ランダムフォレストは分割時にランダムに特徴を選択し、木同士の相関を低減します。アウト・オブ・バッグのサンプルで性能を推定できるものの、最終的な未使用テストセットはモデル選択やデプロイ時の主張を裏付ける上で依然として重要です。
ブースティング
ブースティングは段階的に加法モデルを構築します。後続の学習者は、現在のアンサンブルがうまく処理できないサンプルや残差パターンに焦点を当てます。AdaBoost はサンプルの重みを変更し、勾配ブースティング は選択した損失関数の負の勾配に学習者を適合させます。
ブーストされた木は複雑な表形式の関係をモデル化できますが、深い木や過剰なラウンド、情報漏洩により依然として過学習する可能性があります。学習率、木の深さ、サブサンプリング、早期停止が重要な制御項目です。
スタッキングとブレンディング
スタッキングは、基礎予測をどのように組み合わせるかを学習する第2層モデルを作成します。情報漏洩を防ぐため、メタモデルの学習に使用する各行は、その行で学習していない基礎モデルから取得しなければなりません。クロスバリデーションがこれらのアウト・オブ・フォールド予測を生成します。
ブレンディングはメタモデル用に別のホールドアウトセットを使用します。これはシンプルですが、学習に利用できるデータが減少します。両手法とも、推論時に同一の前処理とバージョン管理が必要です。
運用上のトレードオフ
アンサンブルはメモリ、計算リソース、障害モードを増幅させます。説明やキャリブレーション、継続的な更新が難しくなることがあります。蒸留によりアンサンブルを小型モデルに圧縮できますが、学生モデルは独立して評価する必要があります。
実務的な選択では、性能、テールレイテンシ、キャリブレーション、リソース使用量、エラーコストを比較します。脆弱なスタックから得られる僅かな精度向上より、適切に正則化された単一モデルの方が好ましいことがあります。
アンサンブルが機能する理由
アンサンブル学習は複数のモデルを組み合わせ、エラーを部分的に相殺したり、各モデルの強みが異なる領域をカバーしたりします。バギングは再サンプリングしたデータでモデルを学習し予測を平均化して分散を低減します。ランダムフォレストはランダムな特徴選択を加えて木同士の相関を減らします。ブースティングは学習者を順次訓練し残差エラーに焦点を当て、バイアスを減らす一方でノイズやチューニングへの感度を高めます。スタッキングは基礎モデルの予測を用いてメタモデルを学習します。多様性は有用である必要があり、同一モデルを平均化してもエラー削減効果は小さく、コストだけが増加します。
エラー間の相関が利益を左右します。多様性はデータサンプル、特徴、アルゴリズム、ハイパーパラメータ、ランダム初期化、時間ウィンドウなどから得られます。ハード投票は信頼度を捨て、ソフト投票は確率を平均化しますが、適切なキャリブレーションが必要です。回帰では平均化やロバストな集約が利用できます。スタッキングではアウト・オブ・フォールド予測が不可欠で、同一データでの基礎予測でメタモデルを学習すると情報漏洩が起きます。複雑な結合器を導入する前に、シンプルな平均化ベースラインを保持しましょう。
評価、キャリブレーション、そして不確実性
各メンバーとアンサンブルを、同一の前処理を施した保持データセットで比較します。タスク指標、キャリブレーション、サブグループエラー、フォールドやシード間の分散、リソースコストを報告してください。アンサンブルは平均的な品質を向上させる一方で、共通データやラベルに起因する盲点を隠すことがあります。意見の不一致を検査すると不確実性が特定できる場合がありますが、相関した自信過剰な誤ったモデルは一致することもあります。最終的なアンサンブル全体をキャリブレーションし、メンバーだけでなく、レビュー体制や影響に対する棄権閾値を検証してください。
アウト・オブ・バッグ推定はバギングモデルに有用ですが、最終的なデプロイを代表するテストの代替にはなりません。時系列データでは順序を壊すリサンプリングを避けてください。安全性が求められる用途では、メンバーモデルの故障、古いモデル、敵対的入力をテストします。多数の候補を試すと重み付きアンサンブルが検証データに過学習することがあります。候補選択を記録し、チューニングが広範囲に及ぶ場合はネストされた検証を使用してください。
提供と保守
アンサンブルはメモリ、レイテンシ、エネルギー、運用上の依存関係を増大させます。蒸留により結合された挙動を単一モデルに圧縮できるものの、新たな検証要件が生じます。メンバー、前処理、重み、ルーティングを一つのアーティファクトとしてバージョン管理し、メンバーがタイムアウトしたり無効な結果を出した場合の挙動を定義してください。メンバー予測と不一致を監視し、無音の障害を可視化します。冗長なメンバーは退役させ、意図的に再学習させます。エラーの多様性が実在すれば予測は向上しますが、バイアスのかかった学習データや無効なターゲットを信頼できる証拠に変えることはできません。
実例:激しい天候警報のためのアンサンブル
予測チームは、物理モデルの特徴セット、勾配ブースト木、ニューラルシーケンスモデル、そしてキャリブレーション済み統計ベースラインを組み合わせます。アウト・オブ・フォールド予測でシンプルなメタモデルを学習させ、評価はメンバーの学習から完全に除外された将来の嵐を使用します。指標はイベント再現率、誤報、リードタイム、キャリブレーション、地理的パフォーマンス、稀な極端条件下での信頼性を含みます。共有入力データが共通の盲点を生む可能性があるため、メンバー間のエラー相関を検証します。
提供時には各予測と統合結果を保持します。メンバーが利用できない場合、システムは無音で正規化し直すのではなく、事前に検証された劣化構成を使用します。不一致が生じた場合は追加レビューを促しますが、すべての場合で不確実性として扱うわけではありません。モニタリングはメンバードリフト、レイテンシ、嵐の結果を追跡し、重みは制御された検証を通じてのみ更新されます。公共の警報は認可された気象判断プロセスの下で行われ、アンサンブルは証拠を強化しますが、警報方針を自律的に再定義することはありません。
実装の証拠と運用準備性
本番導入の判断は、成功したデモだけでは不十分です。対象ユーザー、運用環境、入力・出力、依存関係、所有者、重要な障害ごとの影響を明確に定義します。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立します。通常ケース、境界条件、破損または欠損した入力、分布シフト、依存サービスの停止、誤用、そして支援が不十分になりやすいグループや環境をテストします。タスク品質をキャリブレーションや不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティと共に測定します。すべての変換と閾値を記録し、独立したレビュアーが結果を再現でき、魅力的なプロトタイプと証拠を区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、退役の権限を割り当てます。段階的ロールアウトを用い、安全なフォールバックを保持し、意図的に注入した障害でモニタリングを検証します。運用テレメトリは、不要な機密データを収集せずに、入力品質、出力挙動、モデルまたはルールのバージョン、依存性の健全性、人間による介入、確認された結果を明らかにすべきです。アラート閾値と対応責任者を定義し、導入後に実世界の証拠をレビューし、オフライン性能が持続すると仮定しないでください。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目的が変わるたびに再評価します。維持されたシステムは、文書化された復旧手順、インシデントからの学習、削除・保持手順、そして無効化または置換すべき明確なタイミングも必要です。
よくある質問
ランダムフォレストはアンサンブルですか?
はい。多数のランダム化された決定木を組み合わせており、通常は投票または平均化で統合します。
同一のモデルでも有用なアンサンブルを構成できますか?
訓練データ、初期化、サンプリングが十分に異なるエラーを生む場合は可能ですが、単なる複製だけでは効果がありません。
主要参考文献












