AIの基礎
混同行列とは何ですか?

 Unite.AI を Google の優先ソースに追加
A confusion matrix は、分類器の予測が既知のラベルとどれだけ一致または不一致かを数える表です。どのクラスが混同されているかを示し、適合率、再現率、特異度、F1 などの指標を計算するために使用されるカウントを提供します。これは、supervised learning の分類問題における主要な診断ツールの一つです。
行列自体は単一の性能スコアではありません。特定の決定閾値、データセット、クラス定義における結果の構造化されたビューです。
主なポイント
- 二値分類では、4 つの結果は真陽性、偽陽性、偽陰性、真陰性です。
- 軸には必ずラベルを付けましょう: ライブラリや文献によって実際のクラスと予測クラスの配置が異なることがあります。
- クラスが不均衡な場合、正確度だけでは重大なエラーが隠れることがあります。
- 分類閾値を変更すると混同行列が変わり、適合率と再現率のトレードオフも変化します。
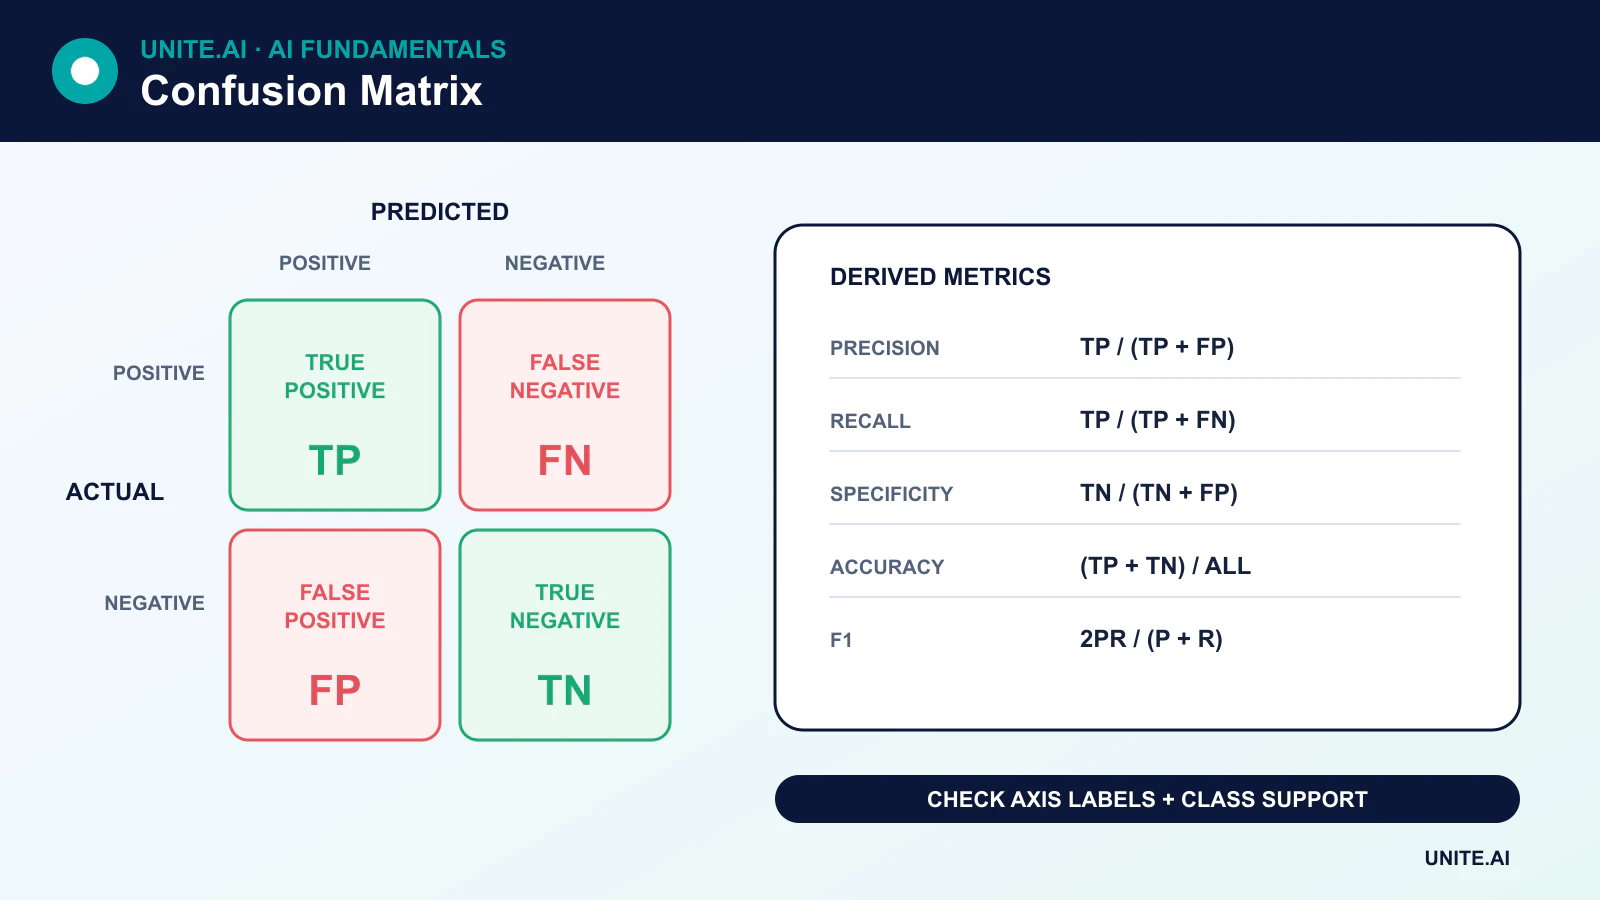
二値分類の4つの結果
- 真陽性 (TP): 例が陽性で、モデルが陽性と予測した場合。
- 偽陽性 (FP): 例が陰性だが、モデルが陽性と予測した場合。
- 偽陰性 (FN): 例が陽性だが、モデルが陰性と予測した場合。
- 真陰性 (TN): 例が陰性で、モデルが陰性と予測した場合。
scikit-learn の慣例では、行が実際のクラス、列が予測クラスです。他の可視化ではこの配置が転置されることがあるため、コーナーの位置ではなくラベルが解釈の指針となります。
混同行列から導出される指標
適合率
Precision = TP / (TP + FP)
適合率は: 陽性と予測された例のうち、実際に陽性であった割合を示します。
再現率(感度)
Recall = TP / (TP + FN)
再現率は: 実際の陽性例全体のうち、モデルが正しく識別した割合を示します。二値分類において、陽性クラスの再現率は感度または真陽性率とも呼ばれます。
特異度
Specificity = TN / (TN + FP)
特異度は陰性クラスの再現率です: 実際の陰性のうち、モデルが正しく除外した割合を示します。
正確度
Accuracy = (TP + TN) / (TP + TN + FP + FN)
正確度は、クラスやエラーコストが概ねバランスしている場合に有用です。あるクラスが支配的になると、誤解を招くことがあります。
F1 スコア
F1 = 2 × (Precision × Recall) / (Precision + Recall)
F1 スコアは適合率と再現率を調和平均で要約します。真陰性は考慮しないため、すべてのタスクに適した指標とは限りません。
実例
テストセットに 1,000 件の取引があるとします。そのうち 50 件が不正です。モデルはそのうち 40 件の不正を検出しましたが、30 件の正当な取引を誤ってフラグ付けしました:
- TP = 40
- FN = 10
- FP = 30
- TN = 920
このモデルの正確度は 96% ですが、適合率は約 57%、再現率は 80% です。高い正確度は多数の正当な取引によるものです。このモデルが受容できるかどうかは、見逃した不正のコスト、調査能力、リスクスコアの校正度合いに依存します。
閾値の変更で行列が変わる
多くの分類器は、必ずしも 0/1 の答えではなくスコアを出力します。陽性閾値を下げると再現率と偽陽性が増加し、上げると適合率または特異度が向上しますが、陽性を見逃すことが増えます。閾値は検証データと実際のエラーコストを考慮して選択すべきで、0.5 に自動的に固定すべきではありません。
適合率‑再現率曲線と ROC 曲線は、閾値全体での性能を要約します。陽性クラスが稀少な場合、適合率‑再現率曲線の方が情報量が多いことがよくあります。
多クラス混同行列
クラス数が K の場合、行列は K × K です。正しい予測は対角線上にあり、対角外のセルはどのクラスペアが混同されているかを示します。クラス別指標は以下のようにさまざまな方法で平均化できます:
- マクロ平均: 各クラスに同等の重みを与えます。
- 加重平均: 各クラスをそのサンプル数で重み付けします。
- マイクロ平均: 指標を計算する前に結果カウントを集計します。
単一の平均だけを報告すると、少数クラスでの性能低下が隠れることがあります。差が重要な場合は、サポート数とクラス別結果を含めましょう。
一般的なミス
- 軸ラベルを確認せずに転置された行列を読むこと。
- 適切なホールドアウトセットではなく訓練データから指標を計算すること。
- クラスの出現頻度、サンプリング戦略、または分割間の重複エンティティを無視すること。
- 異なる閾値で作成された行列を、変化を明記せずに比較すること。
- すべての偽陽性と偽陰性を同等のコストとみなすこと。
したがって、混同行列は診断ツールであり、完全な評価ではありません。校正、サブグループ分析、ロバスト性、下流の影響も分類レビューに含める必要があります。
すべてのセルを読み取り有用な指標を導出する
二値分類では、混同行列は選択した陽性クラスと閾値に対して真陽性、偽陽性、偽陰性、真陰性をカウントします。正確度は全ケースに対する正解予測の割合です。適合率は予測された陽性のうち正解の割合を問います。再現率は実際の陽性のうち検出された割合を問います。特異度は実際の陰性が正しく除外された割合を測ります。F1 は適合率と再現率の調和平均です。どれが最適かは状況次第です: 不正検出、医療トリアージ、スパムフィルタは同じセルに対して異なる結果を持ちます。
多クラス問題では、行は実際のクラス、列は予測クラスを表すことが一般的ですが、慣例は異なるためラベルは明示的に示す必要があります。One‑vs‑Rest のカウントはクラス別の適合率と再現率を生成します。マクロ平均はクラスを均等に重み付けし、マイクロ平均は決定を集計して多数派クラスを優先し、加重平均はクラスのサポート数に従います。マルチラベルタスクでは、アイテムあたり複数のラベルが許可され、ラベル単位またはサンプル単位の定義が必要です。行で正規化すると再現率パターンを、列で正規化すると予測構成を確認できますが、稀少グループが視覚的に誇張されないように元のカウントは保持してください。
閾値、不確実性、運用上の意思決定
混同行列は単一の閾値におけるハードな決定を要約します。適合率‑再現率曲線や ROC 曲線を用いて閾値を比較し、容量、罹患率、エラーコストに基づいて運用点を選択します。校正は予測確率が観測頻度と合致しているかを問うもので、ランキングとは別です。罹患率が変化すると、感度と特異度が安定していても適合率は変わり得ます。信頼区間やブートストラップ変動を報告し、小規模サブグループの数件のエラーから結論を導くのは避けましょう。
時間、場所、デバイス、言語、関連する影響群ごとに行列を監査し、エラーが集中している箇所を特定します。モデルを既存の意思決定プロセス(ヒューマンレビューを含む)と比較します。カスケードの場合、各段階(取得、分類、閾値設定、アクション)でのエラーを記録します。リアルタイムの結果ラベルとその遅延・修正プロセスを監視します。見かけ上改善された F1 でも、有害な偽陰性が増加したり、レビュー容量を超えることがあります。混同行列は意思決定台帳であり、各セルをエラーを受ける対象者とその後の対応に結び付けます。
実例:医療スクリーニング閾値の選択
machine-learning スクリーニングモデルは、低罹患率の状態に対してリスクスコアを出力します。チームは閾値ごとに混同行列を作成し、感度、特異度、適合率、偽陽性紹介、見逃しケースを信頼区間とともに報告します。陽性予測値は罹患率に依存するため、単一データセットの適合率を引用するのではなく、対象とする集団をモデル化します。結果はデバイス、施設、年齢、性別、その他臨床的に正当化されたグループ別に分割されます。
臨床医は、必要な感度を維持しつつ確認検査が過剰にならない運用点を選択します。行列は 10,000 人あたりの期待カウントに変換され、結果の影響が理解しやすくなります。検証済み条件外のスコアは自動的な結論を出しません。モニタリングは予測と遅延した確定診断を比較し、容量と校正を追跡し、罹患率や取得条件が変化した際にレビューをトリガーします。混同行列は正確なモデル、閾値、対象集団に結び付けられたままです。
実装の証拠と運用準備
本番導入の判断には、成功したデモだけでは不十分です。対象ユーザー、運用環境、入力・出力、依存関係、所有者、重要な障害ごとの影響を定義します。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立します。通常ケース、境界条件、フォーマット不正や欠損入力、分布シフト、依存障害、誤用、そして支援が不十分になりやすいグループや環境をテストします。タスク品質を校正や不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティと共に測定します。すべての変換と閾値を記録し、独立したレビューアが結果を再現でき、魅力的なプロトタイプと証拠を区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止の権限を割り当てます。段階的ロールアウトを使用し、安全なフォールバックを保持し、意図的に失敗を注入してモニタリングを検証します。運用テレメトリは、入力品質、出力挙動、モデルまたはルールのバージョン、依存性の健全性、ヒューマンオーバーライド、確認済み結果を示すべきで、不要な機密データは収集しません。アラート閾値と対応責任者を定義し、デプロイ後に実世界の証拠をレビューします。オフライン性能が持続すると仮定しないでください。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目的が変わるたびに再評価します。維持されたシステムは、復旧手順、インシデント学習、削除・保持手順、そして無効化または置換すべき明確な時点を文書化する必要があります。
よくある質問
正規化された混同行列とは何ですか?
正規化はカウントを真クラスの総数、予測クラスの総数、または全観測数で割ります。これによりクラス間で率を比較しやすくなりますが、レポートには生のサポート数も残して、小規模グループが同等に大きいと誤解されないようにすべきです。
混同行列は回帰を評価できますか?
直接的にはできません。混同行列は離散的なクラスが前提です。連続的なターゲットをビン分割すると情報が失われます。回帰では通常、残差分析や MAE や RMSE などの連続値用指標を使用すべきです。
主要参考文献