AIの基礎
画像分類はどのように機能するか?

 Unite.AI を Google の優先ソースに追加
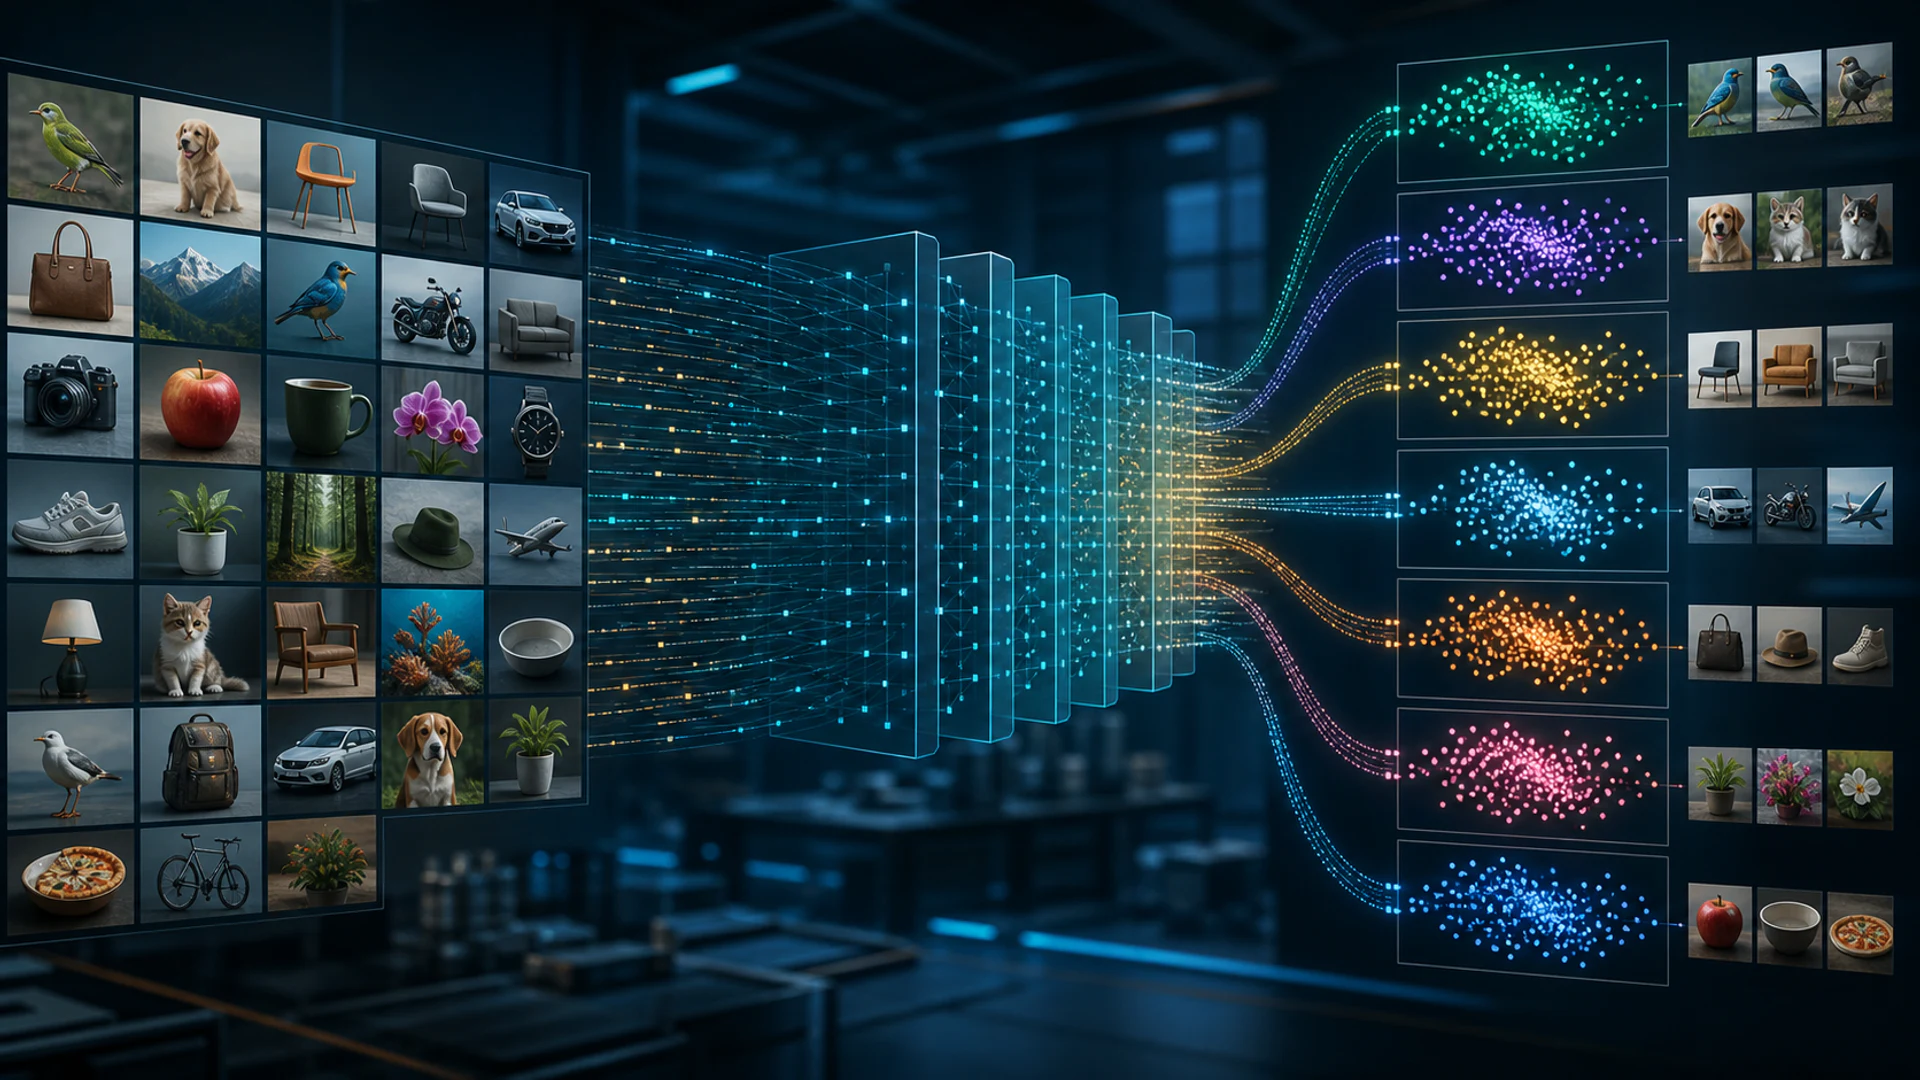
画像分類は画像全体にラベルを予測します。「どの製品カテゴリが表示されているか」や「このスキャンに対象が含まれているか」などの質問に答えますが、個々のオブジェクトを検出したりピクセル単位で輪郭を描くことはできません。
最新のシステムは一般に畳み込みニューラルネットワーク(CNN)やビジョントランスフォーマーを使用し、しばしば事前学習済みの重みで初期化されます。信頼できる性能は、ラベル、サンプリング、データ拡張、キャリブレーション、そして実際の運用環境下でのテストに依存します。
重要ポイント
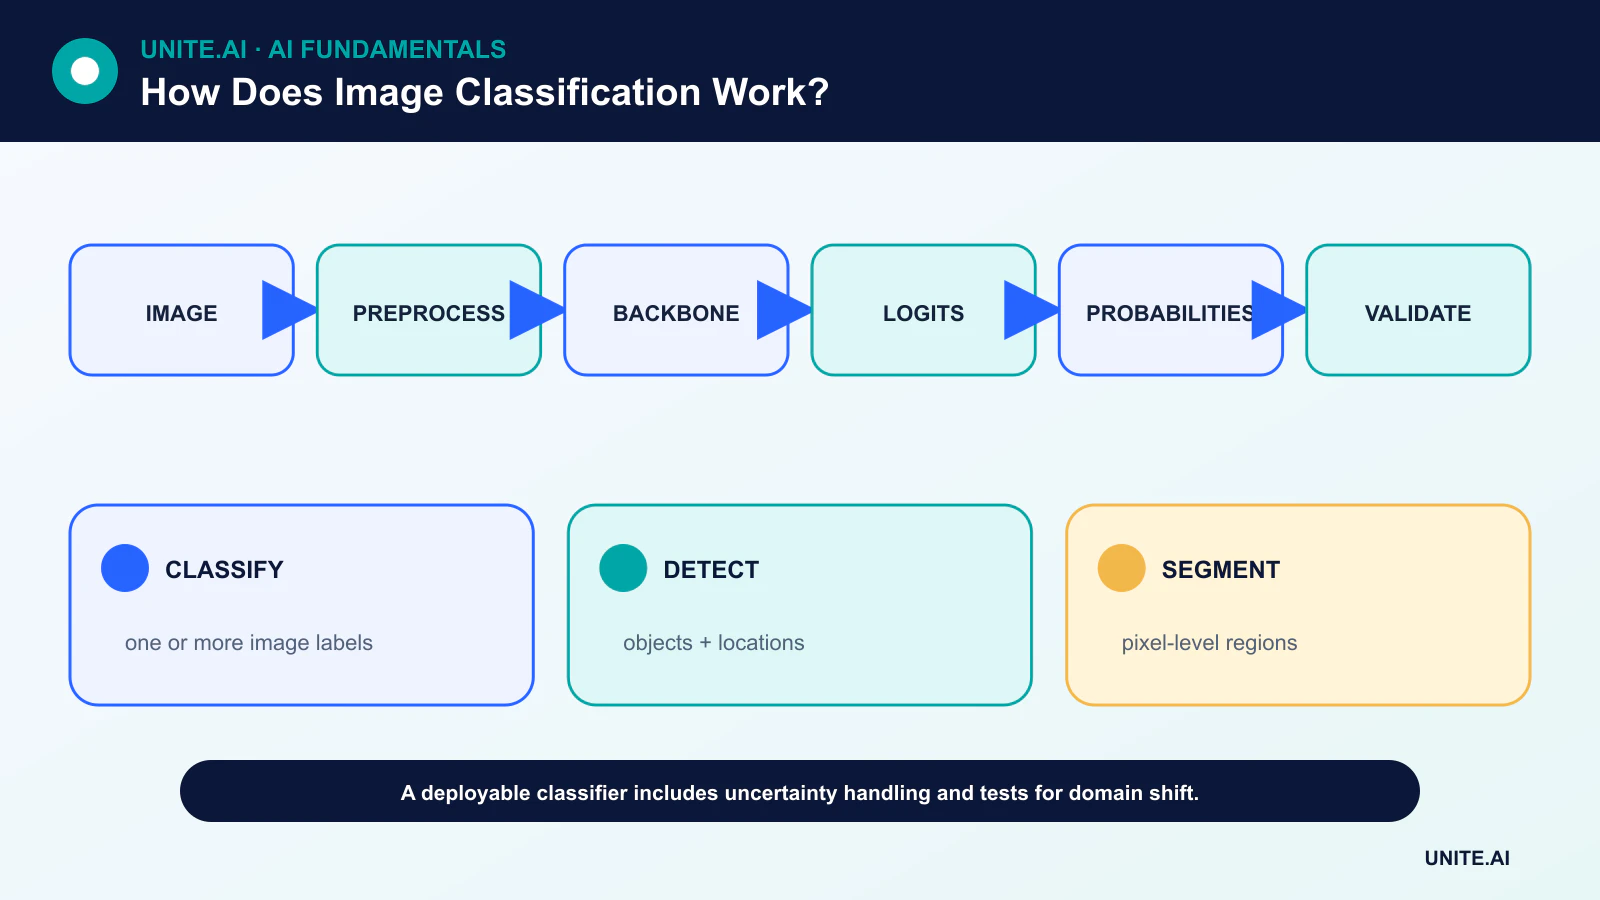
- 分類は画像全体にラベルを付けますが、検出はオブジェクトのバウンディングボックスを描き、セグメンテーションはピクセルレベルの領域を割り当てます。
- 事前学習と転移学習はデータ要件を削減できますが、ドメインの不一致があるとその効果が失われることがあります。
- 全体的な精度だけではクラス不均衡や誤ったショートカット、キャリブレーションの不備が隠れることがあります。
- 画像の品質、撮影デバイス、地域、ワークフローの変化はすべて分布シフトを引き起こす可能性があります。
ピクセルからスコアへ
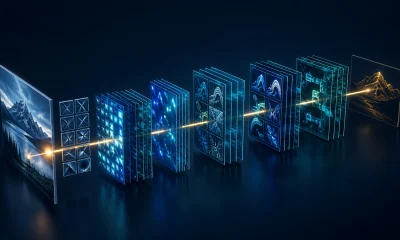
画像はリサイズまたはクロップされ、正規化されてテンソルに変換されます。データ拡張では、フリップやクロップ、色変換などラベルを保持する変換が適用されることがあります。バックボーンはピクセルを特徴量にマッピングし、分類ヘッドはロジットを生成し、これが相対的なクラススコアに変換されます。
選択した前処理は実装環境と合致している必要があります。対象オブジェクトを除去するセンタークロップや正規化の不一致は、学習済みの重みが変わっていなくても性能を低下させる可能性があります。
CNN とビジョントランスフォーマー
畳み込みニューラルネットワークは局所フィルタと共有重みを用いて空間的特徴を構築します。残差接続により、非常に深い CNN の最適化が容易になりました。ビジョントランスフォーマーは画像をパッチに分割し、アテンションでそれらの関係をモデル化します。
アーキテクチャ比較は、トレーニングデータ、データ拡張、計算リソース、解像度を統制した上で行うべきです。公開ベンチマークで最良のモデルが、エッジデバイスや小規模データセット、説明可能性の要件に最適とは限りません。
転移学習とデータ設計
転移学習は、より大規模なソースデータセットで学習した重みから開始します。チームはバックボーンを凍結したり、後半の層をファインチューニングしたり、モデル全体を更新したりできます。ファインチューニングには通常、低い学習率とデータ漏洩を防ぐ検証セットが必要です。
ラベルは画像から視覚的に推測できる内容を記述すべきです。診断が画像に含まれない患者の既往歴に依存する場合、分類器は完全な臨床判断を学習できません。重複画像、同一動画のフレーム、同一被写体の画像は同じ分割に保持する必要があります。
指標、 不確実性 と ショートカット
Top-1 精度は最もスコアが高いクラスが正解であることを要求し、top‑k 精度は上位 k 個のスコアの中に正解クラスが含まれていれば受け入れます。クラス別の適合率、再現率、そして 混同行列 は不均衡なエラーを明らかにします。
モデルは意図した対象ではなく、背景や透かし、撮影機器、フレーミングを利用して予測することがあります。反事実テスト、サブグループ分析、サリエンシーツールはショートカットの発見に役立ちますが、説明用ヒートマップが因果的推論の証明になるわけではありません。
デプロイ時のモニタリング
本番環境のチェックは、破損ファイル、予期しないサイズ、ぼやけ、照明、カメラモデル、新しいクラスなどを網羅すべきです。信頼度はデプロイ環境に近いデータでキャリブレーションし、範囲外の入力は拒否またはレビューする必要があります。
遅延ラベルやエラーコストの変化をモニタリングすることは不可欠です。入力統計上は安定して見えても、ピクセルとラベルの関係が変わればモデルは失敗する可能性があります。
画像分類データセットの構築
画像分類は画像全体に1つまたは複数のラベルを付与します。オブジェクトを局所化する検出や、ピクセルにラベルを付けるセグメンテーションとは異なります。クラスの範囲、階層、マルチラベル規則、背景や不明カテゴリ、そして可視的な証拠を定義します。デプロイを想定したカメラ、撮影場所、照明、視点、距離、被写体を収集します。拡張前に被写体、シーン、セッション、ソース単位で分割し、隣接する動画フレームやパーティション間で重複した製品画像があると深刻なリークが生じます。
アノテーション指示は、遮蔽、曖昧なオブジェクト、複数クラス、低品質、棄権(ラベルなし)をカバーすべきです。合意度を測定し、体系的な不一致をレビューします。クラスバランスだけではカバレッジは保証できません: 疾病クラスが1つのデバイスだけを含むことや、野生動物クラスが1つの背景だけを含むことがあります。メタデータや類似画像を検査し、独立取得した保護テストセットを保持します。合成データやウェブスクレイピングはバリエーションを増やしますが、ライセンス、出所、スタイル、ラベルの問題を導入し、実画像で測定する必要があります。
モデル、トレーニング、評価
従来手法は設計された記述子と分類器を組み合わせますが、最新システムは畳み込みネットワークやビジョントランスフォーマーを使用し、しばしば転移学習を活用します。リサイズやクロップの選択は残る情報を決定します。データ拡張は妥当な変動を反映し、ラベルを保持すべきです。タスクに適した損失関数を最適化し、重み付けやサンプリングで不均衡に慎重に対処し、検証データでチェックポイントを選択します。シンプルなベースラインと比較し、拡張、解像度、事前学習初期化を除去して、どこから改善が得られるかを把握します。
クラス別の適合率、再現率、F1、混同行列、関連する場合は top‑k 精度、キャリブレーション、条件別の性能を報告します。ぼやけ、圧縮、照明、クロップ、遮蔽、デバイス、サポート外クラスの入力をテストします。信頼度閾値で不確実なケースをレビューに回すことができますが、ソフトマックス確率は特にシフト下では確実な信頼度を保証しません。反事実的な背景や遮蔽テストはショートカット学習を明らかにします。安全性が関わる用途では、最悪ケースの失敗と偽陽性・偽陰性の影響を評価します。
デプロイとモニタリング
デコード、色変換、向き補正、正規化、モデル、ラベルマップを一括でパッケージ化します。エクスポートまたは量子化された成果物を対象デバイスで検証し、エンドツーエンドのレイテンシ、メモリ、電力、スループットを測定します。画像品質、入力・出力分布、キャリブレーション、確定ラベル、センサーの状態をモニタリングします。特に顔や位置、通行人に関する画像の保持は最小化し、セキュアに管理します。破損や範囲外入力に対するフォールバックを提供し、モデルバージョンをロールバックします。分類は定義された画像レベルの質問に答えるものであり、サポートされていない位置特定や身元、意図の主張に拡張すべきではありません。
実例:リサイクル可能素材の分類
ある施設ではコンベア上のアイテムを撮影し、素材クラス、汚染、未知をラベル付けします。画像は収集日とオブジェクトバッチで分割され、照明、湿った表面、くしゃみ、重なり、空のベルトなどを網羅します。小規模な CNN と事前学習モデルを色と形状のルールと比較します。クラス別再現率、誤分類、キャリブレーション、スループット、カメラや素材状態別の結果が選定の要因となります。
本番パイプラインはカメラの露出とベルトのタイミングを検証し、不確実なアイテムは強制的にクラス付けせず一般ストリームへ送ります。量子化推論は正確なハードウェア上で検証されます。モニタリングは入力品質、クラス率、リジェクト、抽出した手動監査を追跡し、新しい包装が出るとデータ更新をレビューします。モデルは物理的ガード付きの限定ソーターを制御し、センサーやモデルの故障時には素材を黙って誤配するのではなく、安全な状態に戻します。
実装証拠と運用準備性
本番導入の判断は、成功したデモだけでは不十分です。想定ユーザー、運用環境、入力・出力、依存関係、所有者、重要な障害ごとの影響を定義します。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立します。通常ケース、境界条件、破損または欠損入力、分布シフト、依存障害、誤用、そして支援が不足しがちなグループや環境をテストします。タスク品質とキャリブレーションや不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティを測定します。すべての変換と閾値を記録し、独立したレビューアが結果を再現でき、魅力的なプロトタイプと証拠を区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止の権限を割り当てます。段階的ロールアウトを採用し、安全なフォールバックを保持し、意図的に失敗を注入してモニタリングを検証します。運用テレメトリは、入力品質、出力挙動、モデルまたはルールのバージョン、依存状態、人間のオーバーライド、確認済み結果を示すべきで、不要な機密データは収集しません。アラート閾値と対応責任者を定義し、オフライン性能が持続すると仮定せず、デプロイ後に実世界の証拠をレビューします。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目的が変わるたびに再評価します。維持されたシステムは、復旧手順、インシデント学習、削除・保持手順、そして無効化または置換すべき明確なタイミングを文書化する必要があります。
よくある質問
画像分類器は複数のオブジェクトを識別できますか?
マルチラベル分類器はどのカテゴリが存在するかを示すことはできますが、個々のインスタンスを局所化はしません。バウンディングボックスや個数を得るにはオブジェクト検出が必要です。
なぜ人間には正常に見える写真でもモデルが失敗することがあるのでしょうか?
モデルは撮影時のアーティファクトやテクスチャ、変化した相関関係に依存している可能性があります。小さな前処理の違いやドメインシフトも学習した特徴に影響を与えることがあります。
主要参考文献