
AIの基礎
テキスト分類はどのように機能するか?

 Unite.AI を Google の優先ソースに追加
テキスト分類は、文書、メッセージ、またはテキストの一部に1つ以上のラベルを付与します。例として、スパム検出、インテントルーティング、感情分析、トピックタグ付け、モデレーション、サポートチケットの優先順位付けなどがあります。
本番環境の分類器は単なるモデル以上のものです。正確なラベル体系、代表的なアノテーション、リーク防止のデータ分割、校正された意思決定ルール、そして言語やクラス分布の変化を監視する体制が必要です。
主なポイント
- アーキテクチャを選択する前に、ラベルと曖昧なケースを定義する。
- シンプルなBag-of-Wordsベースラインは依然として有用で、事前学習済みエンコーダは文脈と転移学習を加える。
- 精度だけではマイノリティクラスの性能が隠れることがあるため、クラス意識の指標とエラー分析を使用する。
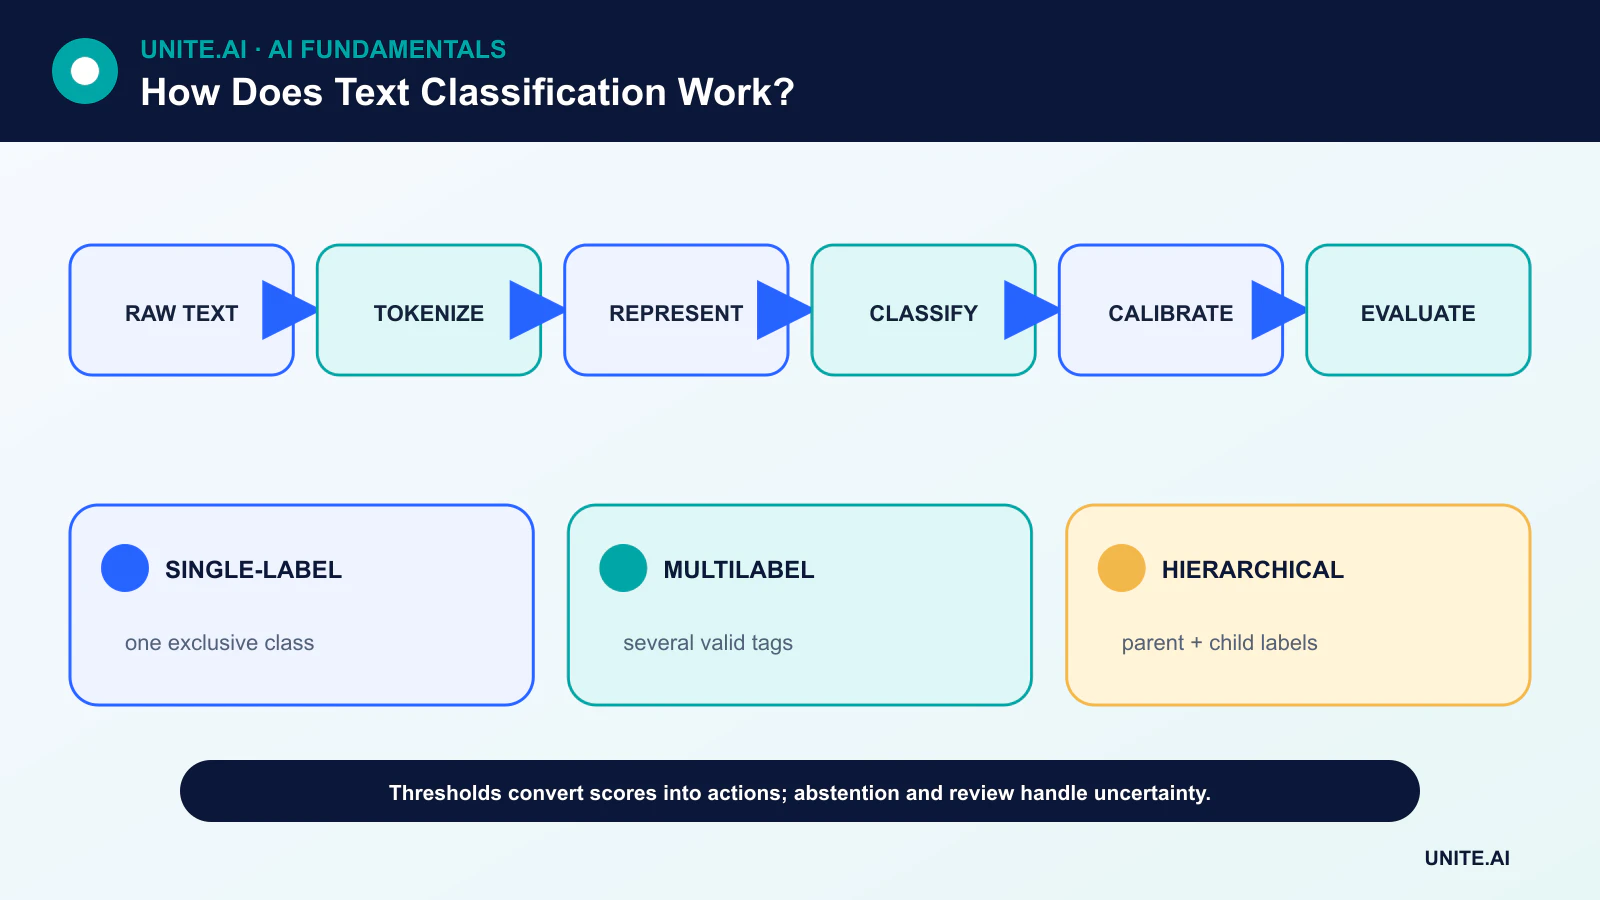
- 確率の校正、保留(アブステンション)および人間によるレビューにより、スコアをより安全な意思決定に変換できる。
ラベル体系とアノテーション方針の定義
単一ラベルタスクは相互排他的なクラスを1つ選択します。マルチラベルタスクは複数の独立したタグを付与でき、階層的なラベル体系は親子ラベルを含みます。これらは異なる学習課題であり、出力や指標も異なります。
アノテーターは定義、肯定例と否定例、欠落コンテキストへの対応ルール、エスカレーションパスが必要です。合意統計はタスクの曖昧さを明らかにできますが、意見の不一致はシステムが保持すべき実際の曖昧性を示すこともあります。
テキストの表現
従来のパイプラインはトークン数、n-gram、TF-IDF を線形分類器やサポートベクターマシンと組み合わせて使用します。学習が高速で、影響力のある語を可視化でき、強力なベースラインを提供します。
ニューラルシステムはトークンを埋め込みにマッピングします。事前学習済みトランスフォーマーエンコーダは注意機構で文脈表現を生成し、ラベル付き例でファインチューニングできます。プロンプトやゼロショット分類器は初期ラベリングを削減できますが、ラベル表現、モデルバージョン、校正は実際のドメインで評価する必要があります。
リーク防止のトレーニング
データセットはトレーニング、検証、最終テストデータに分割します。類似の重複文書、同一会話からのメッセージ、同一ソースのテンプレートは同じ分割に保持すべきです。時間依存の利用では、時系列分割がデプロイをより正確に表します。
クラス不均衡は重み付け、リサンプリング、しきい値選択、追加データで対処できます。合成例は実際のマイノリティクラスの失敗のレビューを置き換えるべきではなく、モデルが過度に学習しやすいアーティファクトを導入する恐れがあります。
指標と校正された意思決定
混同行列はどのラベルが混同されているかを示します。適合率は予測された陽性のうち正解の割合、再現率は実際の陽性をどれだけ捕捉できたかを測ります。マクロ平均はクラスを均等に重み付けし、マイクロ平均は個々のサンプルを重み付けします。
生のソフトマックススコアは自動的に信頼できる確率とは限りません。校正は信頼度と実際の正確性を比較します。チームはクラス別のしきい値を設定し、信頼度が低い場合は保留し、機微なケースをレビュアーに回すことができます。
デプロイ、マルチリンガル利用、ドリフト
テキストは製品、イベント、スラング、敵対的な操作により変化します。モニタリングは入力言語、長さ、語彙外パターン、クラス頻度、信頼度、遅延結果を追跡すべきです。再学習にはバージョン管理されたデータと重要な例のリグレッションスイートが必要です。
マルチリンガルの性能は言語・方言ごとにテストする必要があります。すべてを単一言語に翻訳すると感情や実体が変わることがあります。マルチリンガルエンコーダでも、事前学習やラベルが均等に代表的でないため、性能が不均一になることがあります。
表現と分類器ファミリー
テキスト分類は文書、文、またはトークン列を1つ以上のラベルにマッピングします。ラベルが相互排他的か、マルチラベルか、階層的か、順序付きか、オープンセットかを定義します。従来のパイプラインはテキストをトークナイズし、Bag-of-WordsやTF–IDF特徴を構築し、ロジスティック回帰、ナイーブベイズ、線形SVMで学習します。ニューラルシステムは畳み込み、再帰、トランスフォーマーで埋め込みを学習します。プロンプト付き言語モデルはタスク固有の学習なしで分類できますが、出力制約、コスト、ドリフト、エビデンスはシンプルなベースラインと比較して評価が必要です。
前処理は表現方式に依存します。小文字化や句読点除去は名前、感情、コード、言語のシグナルを失わせることがあります。ステミングは異なる意味を統合する恐れがあります。トランスフォーマートークナイザはサブワード単位で動作し長さ制限があるため、切り捨て戦略が重要です。長文はチャンク化と集約が必要になることがあります。生テキストと変換バージョンを保持し、著者、会話、ソース、時間で分割して、近似重複やテンプレートがトレーニングとテストを跨がないようにします。
ラベル、指標、エラー分析
アノテーションガイドは対象範囲、例、曖昧ケース、未知または保留オプションを定義すべきです。合意度を測定し、過半数投票で隠すのではなく不一致を裁定します。クラスが不均衡な場合、精度だけでは不十分です。適合率、再現率、F1、混同行列、校正、クラス別しきい値ごとの作業負荷を報告します。マルチラベルタスクはマイクロ、マクロ、ラベルレベルの指標が必要です。言語、方言、ドメイン、メッセージ長、時間を評価します。語彙やテンプレートがドリフトすると、ランダム分割は品質を過大評価することがあります。
エラー分析では、表現失敗、コンテキスト不足、ラベルの曖昧さ、稀少語彙、否定、皮肉、誤った手がかりを分離すべきです。意味を保ちつつ名前、方言マーカー、無関係なメタデータを変える反事実テストを使用します。高信頼度の誤りや除外ケースを検査します。モデルはコンテンツを解釈せず、顧客チャネルや署名がラベルを予測することを学習するかもしれません。リークを除去し、データを見直してからモデル容量を増やすべきです。
本番設計
固定されたトークナイザとモデルをスキーマ検証、長さ制限、バッチ処理、未対応言語や低信頼度時のフォールバックと共に提供します。入力分布、ラベル頻度、校正、レイテンシ、レビュー結果を監視します。テキストは個人情報、機密情報、敵対的指示を含む可能性があるため保護します。自動モデレーション、適格判定、ルーティングでは、異議申し立て機能と不均等エラーの測定を提供します。ラベルとしきい値はビジネスポリシーでバージョン管理します。テキスト分類は定義されたラベル体系とデータ分布内でのみ信頼でき、流暢なモデル説明が分類の正しさを証明するわけではありません。
実例:受信サポートリクエストの分類
サポートチームは相互排他的なルーティングラベルに加え、緊急、マルチリンガル、未知フラグを定義します。アノテーターは匿名化されたメッセージに混在する課題へのガイダンスを付けてラベル付けし、合意度を測定します。TF–IDFロジスティックベースライン、ファインチューニングエンコーダ、プロンプトモデルは同一の時間ベーステストセットを使用します。評価ではクラス別適合率・再現率、緊急の偽陰性、校正、スキーマの有効性、レイテンシ、コストを報告し、近似重複テンプレートはリーク防止のためにグループ化します。
デプロイされた分類器は言語と長さを検証し、根拠が弱い場合は保留し、エージェントがルートを修正できるようにします。プロンプトやメッセージは信頼できないものとして扱い、ツールへのアクセスはありません。モニタリングはラベルの出現頻度、信頼度、修正、応答時間、出現トピックを追跡します。ポリシーや製品の変更はレビューを通じてラベル体系と再学習データを更新します。システムはキュー配置を改善しますが、検証されたラベル以外の顧客感情や権利を推測することはありません。
実装証拠と運用準備性
本番での意思決定は成功したデモだけでは不十分です。想定ユーザー、運用環境、入力・出力、依存関係、所有者、重要な失敗ごとの影響を定義します。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立します。通常ケース、境界条件、破損または欠損入力、分布シフト、依存障害、誤用、サービスが行き届きにくいグループや環境をテストします。タスク品質を校正や不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティと共に測定します。すべての変換としきい値を記録し、独立したレビュアーが結果を再現し、魅力的なプロトタイプと証拠を区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止の権限を割り当てます。段階的ロールアウトを用い、安全なフォールバックを保持し、意図的に失敗を注入してモニタリングを検証します。運用テレメトリは、不要な機密データを収集せずに入力品質、出力挙動、モデルまたはルールのバージョン、依存性の健全性、人間のオーバーライド、確定結果を明らかにすべきです。アラートしきい値と対応責任者を定義し、デプロイ後に実世界の証拠をレビューし、オフライン性能が継続すると仮定しないでください。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目標が変わるたびに再評価します。維持されたシステムは、復旧手順、インシデント学習、削除・保持手順、無効化または置換すべき明確なタイミングも文書化する必要があります。
よくある質問
感情分析はテキスト分類タスクですか?
通常はそうですが、感情は単一の肯定/中立/否定ラベルではなく、マルチラベル、側面別、あるいは連続的であることもあります。
テキスト分類器はいつ保留すべきですか?
信頼度が低い場合、テキストが対象外である場合、必要なコンテキストが欠如している場合、または誤った自動処理のコストがレビューのコストを上回る場合です。
主要参考文献












