
AIの基礎
オートエンコーダとは何か?

 Unite.AI を Google の優先ソースに追加
autoencoderは、入力を再構築するように訓練されたニューラルネットワークです。エンコーダは入力を潜在表現にマッピングし、デコーダはその表現から再構築を行います。学習は再構築損失を最小化し、場合によっては追加の制約を加えます。
入力を完全にコピーするだけでは自動的に有用とは限りません。アーキテクチャや目的はボトルネックを作り、ノイズを加え、スパース性を課す、あるいはその他の方法で単純な恒等写像を防止し、潜在コードが有用な構造を捉えるようにしなければなりません。
主なポイント
- エンコーダは入力を圧縮または変換し、デコーダは潜在コードからそれを再構築します。
- アンダーコンプリートなボトルネック、ノイズ、または正則化は、モデルが単にコピーするのではなく構造を学習するよう促します。
- 再構築誤差は異常検知に利用できますが、異常が必ずしも高い誤差を示すわけではありません。
- 変分オートエンコーダ(VAE)は確率的な潜在モデルを学習し、決定論的オートエンコーダとは異なります。
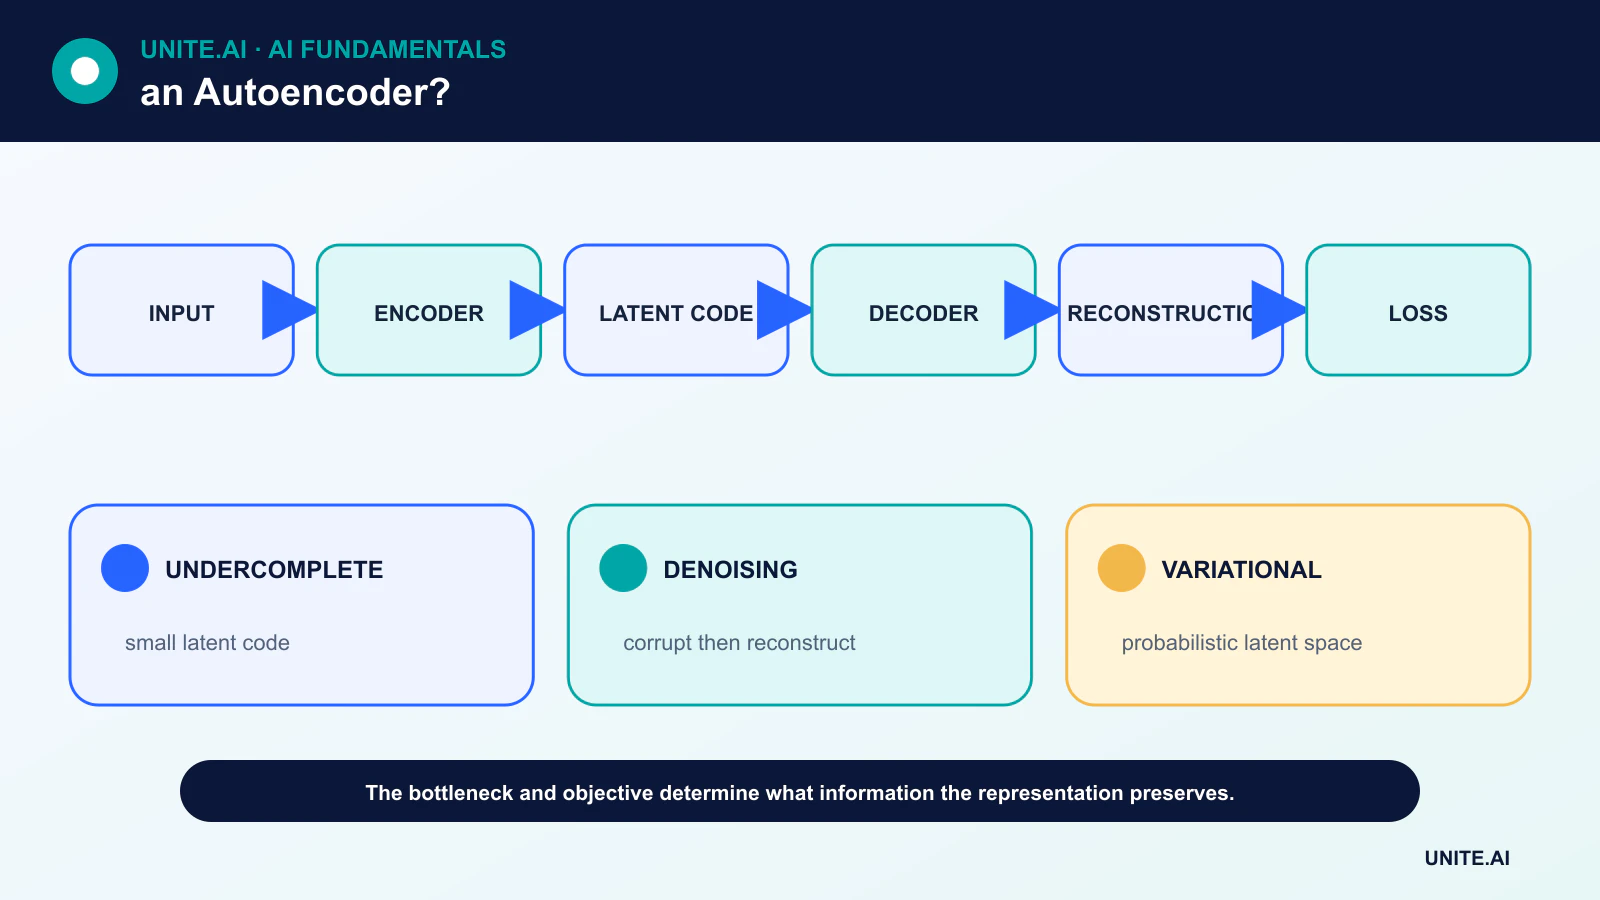
エンコーダ、潜在空間、デコーダ
入力 x に対して、エンコーダは潜在コード z = f(x) を生成し、デコーダは再構築 x̂ = g(z) を生成します。損失は x と x̂ を比較し、たとえば連続値の場合は平均二乗誤差やデータに適した尤度を用います。
潜在次元は入力より小さく設定でき、アンダーコンプリートなオートエンコーダを作ります。深層ネットワークは非線形表現も学習でき、次元削減の考え方を拡張します。
一般的なオートエンコーダのバリエーション
スパースオートエンコーダは広範な活性化にペナルティを課します。デノイジングオートエンコーダは汚染された入力を受け取り、クリーンなバージョンを再構築します。コントラクトオートエンコーダはコードが小さな入力変化に対して敏感になることにペナルティを課します。
変分オートエンコーダ(VAE)は確率分布のパラメータをエンコードし、潜在変数をサンプリングし、再構築と潜在空間を形作る正則化項とのバランスを取ります。これによりサンプリングが可能になりますが、目的と解釈が変わります。
学習と自明な解の回避
オートエンコーダは逆伝播を他のニューラルネットワークと同様に使用します。過剰な容量を持つネットワークは訓練例を記憶したり、ほぼ恒等関数を学習したりします。ボトルネックのサイズ、汚染、ペナルティ、未見データでの検証がそれを制約します。
損失関数の選択は重要です。ピクセル単位の損失は画像の再構築がぼやけることがありますが、知覚的損失は別のネットワークからの前提を継承します。最適な再構築指標が必ずしも意味的類似性の最適な測定とは限りません。
利用例と限界
オートエンコーダは特徴を学習し、信号をデノイズし、データを圧縮し、モデルの初期化や可視化のための潜在変数を生成できます。異常検知では、正常データで訓練されたモデルが異常な入力に対して高い再構築誤差を与えることがあります。
しかし、オートエンコーダが異常も上手く再構築したり、無害な変動が対象の異常より再構築しにくい場合、この手法は失敗します。しきい値はラベル付きまたは慎重にレビューされた検証データが必要で、誤差はサブグループや稼働条件別に監視すべきです。
オートエンコーダと他の生成モデルの比較
決定論的オートエンコーダが自動的に確率的生成モデルになるわけではありません。VAEは構造化された潜在分布を定義し、GANは生成器を識別器と対抗させて訓練し、拡散モデルはデノイズプロセスを学習します。
選択は、目的が再構築、表現、尤度、サンプルの忠実度、制御性、あるいは異常スコアリングかに依存します。タスク固有の小規模モデルの方が、大規模な画像生成器より実用的であることが多いです。
エンコーダ・デコーダの目的と潜在表現
オートエンコーダは入力 x を潜在コード z にマッピングするエンコーダと、z から x を再構築するデコーダを学習します。容量に制限がなければ、ほとんど構造を持たない恒等写像を学習する可能性があります。ボトルネック、正則化、汚染、スパース性、あるいはアーキテクチャ上の制約が、選択された情報を保持する表現を強制します。再構築損失は「類似」とみなす基準を定義し、平均二乗誤差は平均的なピクセル忠実度を好み、知覚的またはモダリティ固有の損失は異なる特徴を強調します。低損失が意味的な意味を保証するわけではありません。
アンダーコンプリートオートエンコーダは潜在次元を制限します。デノイジングオートエンコーダは汚染された入力からクリーンなデータを再構築します。スパースバリアントは活性化にペナルティを課し、コントラクトバリアントは感度にペナルティを課します。変分オートエンコーダは再構築と発散項を組み合わせて確率的潜在分布を学習し、サンプリングを可能にしますが、目的が変わります。畳み込み、シーケンス、グラフ、トランスフォーマーオートエンコーダはモダリティ構造をエンコードします。潜在サイズと正則化は、魅力的な二次元プロットだけでなく、下流の検証を通じて選択すべきです。
異常検知、圧縮、評価
異常検知では、代表的な正常データで訓練し、再構築誤差または潜在尤度でスコアリングしますが、異常がうまく再構築されたり、稀な正常ケースがうまく再構築できなかったりすることがあります。しきい値はラベル付きまたはレビュー済みの検証ケースで設定し、イベントレベルの再現率と誤警報を報告し、稼働状態の変化をテストします。単純な統計的手法やワン・クラスベースラインと比較します。圧縮においては、モデルサイズ、量子化、メタデータ、デコード計算を含む完全なコーデックをカウントし、既存のコーデックとビットレートを合わせた品質を比較します。
表現の品質は、線形プローブ、クラスタリングの安定性、検索、再構築、下流タスクなどを通じて評価でき、各々が異なる問いに答えます。エンコーダの学習やしきい値選択時に情報漏洩を防止します。損失が無視する特徴や、機微属性がエンコードされたままかを検査します。圧縮された潜在表現が自動的に匿名化されるわけではなく、逆変換や属性推定によりプライベート情報が復元される可能性があります。生成された再構築は見た目には妥当でも、重要なディテールが変わっていることがあります。
導入とモニタリング
エンコーダとデコーダを同時にバージョン管理し、エクスポート後の数値変化を検証し、入力スケーリングを保持します。再構築分布、潜在ドリフト、しきい値アラート、確認された結果をモニタリングします。産業モニタリングでは、モデルを稼働モードに条件付け、正常な遷移を故障とみなさないようにします。医療や科学的再構築においては、検証と出所がない限り、生成されたディテールを測定された証拠として提示しないでください。オートエンコーダは柔軟な表現学習器ですが、保持・除外・捏造される情報は、アーキテクチャ名ではなく制約と損失によって決まります。
実例:ポンプ異常検知のためのオートエンコーダ
アンダーコンプリートオートエンコーダは、負荷と温度の範囲で検証済みの正常ポンプ動作から振動ウィンドウを学習します。統計的しきい値やワン・クラス手法と比較し、再構築しきい値はレビュー済みの正常遷移と既知の故障に基づいて選択します。評価はイベント再現率、警告リードタイム、稼働時間あたりの誤警報、ポンプ別の結果を用い、隣接サンプルを訓練とテストに分けたランダムウィンドウは使用しません。
本番モデルは稼働状態に条件付けされ、残差パターンをエンジニアに提示します。高い誤差は点検を要求しますが、部品の診断やポンプの自動停止は行いません。センサーの切断、クリッピング、未見の負荷は明示的な無効状態を生じさせます。モニタリングは再構築分布、アラートの確認、センサーの健全性を追跡します。保守やハードウェアの変更でベースラインが変わる際、旧モデルは残しつつ、レビュー済みデータで訓練された候補モデルが過去のインシデントに対して再実行されます。
実装証拠と運用準備
本番導入の判断は、成功したデモだけでは不十分です。想定ユーザー、稼働環境、入力・出力、依存関係、所有者、重要な障害ごとの影響を定義します。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立します。通常ケース、境界条件、形式不正や欠損入力、分布シフト、依存障害、誤用、そして支援が不足しやすいグループや環境をテストします。タスク品質を較正や不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティと共に測定します。すべての変換としきい値を記録し、独立したレビューアが結果を再現し、魅力的なプロトタイプと証拠を区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止の権限を割り当てます。段階的ロールアウトを使用し、安全なフォールバックを保持し、意図的に失敗を注入してモニタリングを検証します。運用テレメトリは、入力品質、出力挙動、モデルまたはルールのバージョン、依存の健全性、人間の介入、確認された結果を示すべきで、不要な機密データは収集しません。アラートしきい値と対応責任者を定義し、オフライン性能が持続すると仮定せず、展開後に実世界の証拠をレビューします。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目的が変わるたびに再評価します。維持されたシステムは、復旧手順、インシデント学習、削除・保持手順、そして無効化または置換すべき明確なポイントを文書化する必要があります。
よくある質問
オートエンコーダはロスレス圧縮ですか?
一般にはそうではありません。オートエンコーダは通常、タスクや分布に特化したロスィーな表現を学習し、データを再構築するには訓練されたデコーダが必要です。
すべてのボトルネックは解釈可能ですか?
いいえ。コンパクトなコードは、各次元が人間が読める概念に対応していなくても有用であり得ます。
主要参考文献












