
AIの基礎
K-平均クラスタリングとは何か?

 Unite.AI を Google の優先ソースに追加
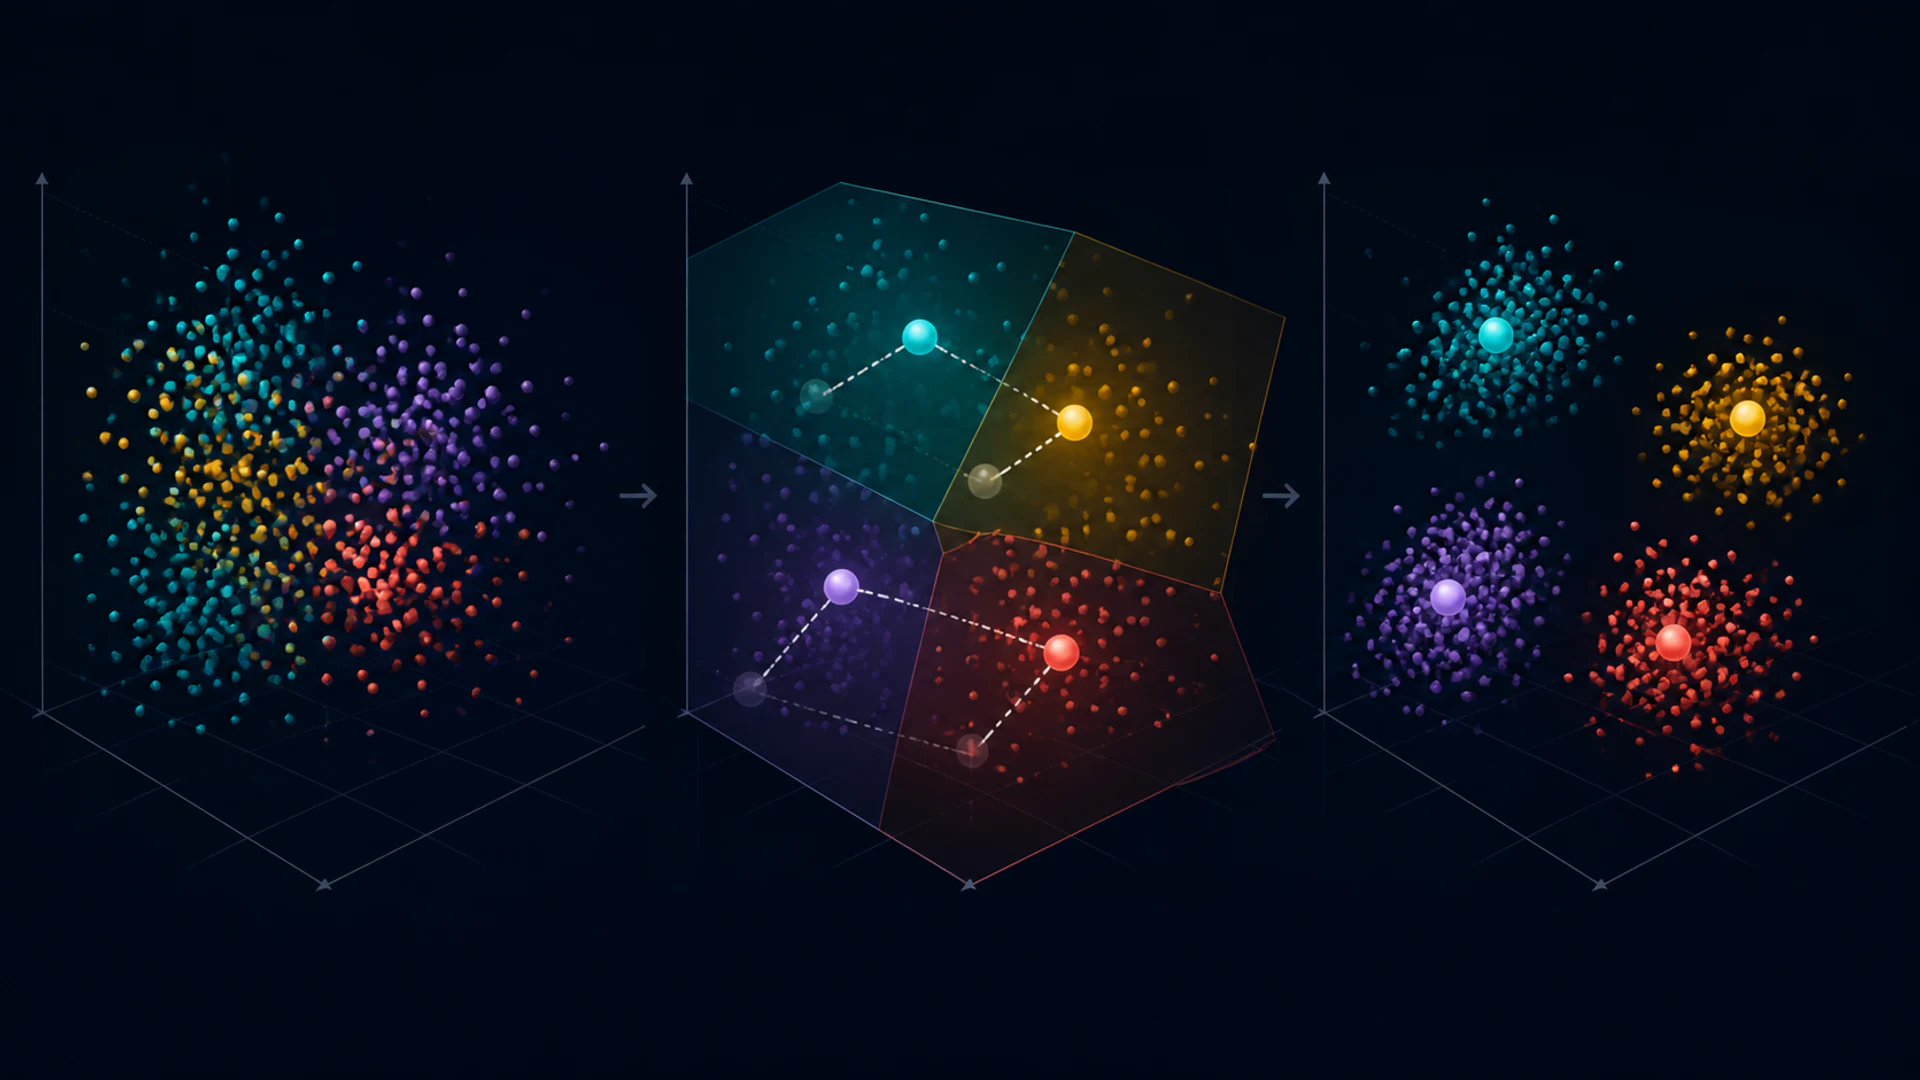
K-means は、数値観測を k 個のクラスタに分割する教師なしアルゴリズムです。各点を最も近い重心に割り当て、割り当てられた点の平均として重心を再計算することを交互に繰り返します。
このアルゴリズムは高速で有用ですが、結果はスケーリング、距離、初期化、選択した k によって左右されます。クラスタは数学的な分割であり、必ずしも実世界のカテゴリを表すわけではありません。
主なポイント
- K-means はクラスタ内の二乗ユークリッド距離(重心まで)を最小化します。
- 初期化は重要です。k-means++ は初期重心を広く配置し、通常は結果を改善します。
- 単位やスケールが同等に寄与すべき場合は、特徴量を標準化します。
- K-means は外れ値、非球状クラスタ、密度が不均一なデータ、カテゴリカルデータに対しては苦手です。
目的と更新ループ
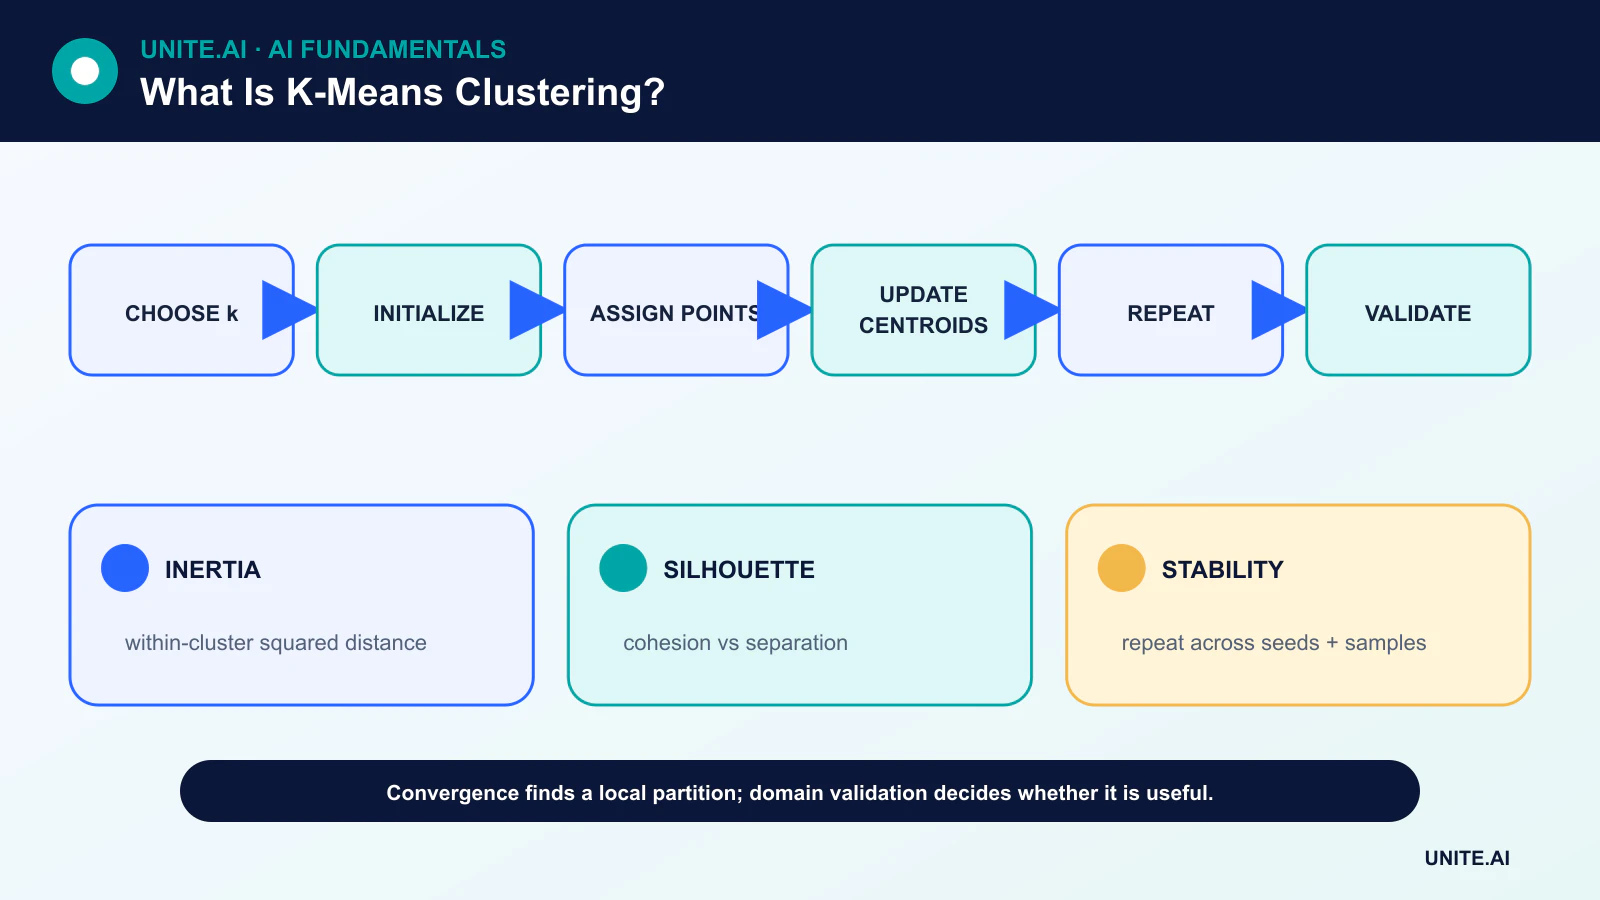
k 個の重心が与えられたとき、割り当てステップでは各観測を最も近い重心に送ります。更新ステップでは各重心を割り当てられた観測の平均で置き換えます。これらのステップではクラスタ内平方和は増加しないため、プロセスは局所最適解へ収束します。
収束はグローバル最適解を保証するわけではありません。初期重心が異なると異なる分割になることがあるため、実装では複数回の初期化を行い、最も低い慣性(inertia)を持つ解を保持します。
初期化と k-means++
すべての初期重心を単一の密集領域からランダムに選ぶと、劣悪な解や収束の遅延を招くことがあります。k-means++ は既存の重心からの距離に比例した確率でシードを選択し、データセット全体をカバーするように促します。
複数回の実行は依然として有用です。ランダムシードと初期化回数を記録しておくことで、結果を再現可能にします。
スケーリングと距離
二乗ユークリッド距離は K-means を単位に敏感にします。千単位で測定された特徴は、0〜1 の範囲で測定された別の特徴を支配してしまうことがあります。標準化は一般的ですが、等しい標準化分散が等しい重要度を意味するかはドメイン知識で判断すべきです。
外れ値は平均を典型的な点から大きく引き離すことがあります。ロバストなスケーリングやトリミング、メドイドに基づく手法の方が適している場合があります。ワンホットのカテゴリ特徴は、カテゴリ間の類似性と一致しない距離空間を作り出すことがあります。
k の選択とクラスタの検証
k を増やすと慣性は必ず減少するため、慣性だけで k を決定することはできません。エルボー法は改善の減少点を探します。シルエット分析は凝集度と分離度を比較します。サンプルやシード間の安定性も別の指標となります。
最も強力な検証は、目的とするドメインでの有用性です。既知の結果や専門家のレビュー、下流タスクとクラスタを比較し、事後的なラベルが客観的に発見されたかのように見なさないようにします。
限界と代替手法
K-means はコンパクトで概ね球状、かつスケールが似通ったグループを好みます。ガウス混合モデルは確率的な楕円体成分を表現し、DBSCAN 系の手法は高密度領域とノイズを識別し、階層的クラスタリングはマージのツリーを生成します。
次元削減 は速度向上や入力のノイズ除去に役立ちますが、全データセットに対して適用すると検証の前提が変わる可能性があります。ミニバッチ K-means は大規模データに対する計算量を削減しますが、近似的な更新を伴います。
目的、初期化、収束
K-means は数値観測を k クラスタに分割し、クラスタ内の二乗ユークリッド距離(重心まで)を最小化します。Lloyd のアルゴリズムは各点を最も近い重心に割り当て、割り当てまたは目的関数が安定するまで重心を再計算することを交互に行います。これは必ずしもグローバル最適解ではなく、局所最適解へ収束します。k-means++ の初期化は初期重心を広く配置し、通常は結果を改善しますが、複数のシードは依然として重要です。単位が同等に寄与すべき場合は特徴量を標準化します。二乗距離はスケールが大きい変数や外れ値を増幅させるためです。
この手法は、ユークリッド幾何学の下で概ねコンパクトで球状、スケールが似通ったクラスタを前提とします。細長い多様体や密度が不均一なデータ、カテゴリカルデータ、重度の外れ値、入れ子構造には苦手です。空のクラスタや重複点は明示的に取り扱う必要があります。ミニバッチ k-means は近似的なトレードオフで大規模データに拡張できます。疎なテキストの場合、コサイン指向の球面 k-means が方向性に適合しやすく、混合モデル、密度手法、階層的クラスタリング、k-medoids などは別の仮定をエンコードします。
k の選択と意味の検証
エルボー曲線、シルエットスコア、関連モデルの情報量基準、安定性は k を示唆しますが、唯一正しい数を発見するわけではありません。ビジネス上の有用性とドメイン解釈が重要です。サンプルやシードを跨いで再フィットし、重心の移動と割り当ての一貫性を比較し、形成に使用しなかった独立したアウトカムでクラスタを検証します。二次元への射影は分離を歪める可能性があるため、元の空間または検証された表現空間で距離と例を検討します。
クラスタは選択された特徴と指標によって作られた記述的なグループであり、自然種や因果的セグメントではありません。クラスタリングに使用した同じ変数に基づくプロファイルは循環的になる可能性があります。保持した属性や定性的レビューを用い、クラスタが主に地理、データソース、またはセンシティブな属性を再現していないか検査します。小規模なクラスタは異常やアーティファクトであることがあります。クラスタに名前を付けても、すべてのメンバーがそのラベルに合致するわけではありません。
導入と保守
スケーリング、特徴順序、重心、距離定義、クラスタラベルは一緒に保存します。新しい点に対しては、割り当てられた重心への距離と訓練サポートを大きく超える割合を監視し、すべてを強制的にクラスタに入れるのではなく「不明」状態を提供します。時間経過とともにクラスタサイズ、重心、アウトカムの関連性を追跡します。再学習によりクラスタの同一性が変わるため、下流ルールをマッピングまたはバージョン管理し、古い名前を黙って再利用しないようにします。K-means はジオメトリが課題に合致する場合の有用な圧縮・セグメンテーションのベースラインであり、万能な発見エンジンではありません。
実例:K-meansによる顧客セグメンテーション
サブスクリプション企業が、固定期間の利用特徴量を標準化し、アカウント識別子を除去したうえで、複数のシードで k を検証します。安定性、シルエット係数、保留したビジネス成果を評価する一方、プロダクトチームは代表的なアカウントと境界付近のアカウントも確認します。その結果、あるクラスターが観測期間の短い新規顧客にすぎないことが分かり、利用期間を明示的に扱います。K-means が適切だと決めつけず、階層型手法や密度ベース手法とも比較します。この作業は教師なし学習として扱い、ラベルの発見とはみなしません。
セグメントは調査やメッセージング実験に使用し、利用資格や価格の決定には使いません。どの重心からも遠い新規アカウントには「不明」を割り当てます。スケーリング、特徴量、重心、名称をバージョン管理し、再学習後の新しいクラスターは、根拠がある場合にのみ以前のクラスターへ対応付けます。監視ではクラスターの大きさ、距離、成果との関連性を追跡します。機微属性とその代理変数を監査し、クラスターが選択された行動を数学的に分割したものにすぎないのに、自然な性格タイプであるかのように表現することを避けます。
実装の証拠と運用準備
本番での導入判断には、成功したデモだけでなく、想定ユーザー、運用環境、入出力、依存関係、所有者、重要な失敗の影響を定義する必要があります。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立します。通常ケース、境界条件、形式不正や欠損入力、分布シフト、依存障害、誤用、サービスが不十分になる可能性が高いグループや環境をテストします。タスク品質と共にキャリブレーションや不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティを測定します。すべての変換と閾値を記録し、独立したレビューアが結果を再現でき、魅力的なプロトタイプと証拠を区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止の権限を割り当てます。段階的ロールアウトを使用し、安全なフォールバックを保持し、意図的に注入した障害でモニタリングを検証します。運用テレメトリは、入力品質、出力挙動、モデルまたはルールのバージョン、依存の健康状態、人間によるオーバーライド、確認されたアウトカムを不要なセンシティブデータを収集せずに明らかにすべきです。アラート閾値と対応責任者を定義し、導入後に実世界の証拠をレビューします。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目的が変わるたびに再評価します。維持されたシステムは、文書化された復旧手順、インシデント学習、削除・保持手順、そして無効化または置換すべき明確な時点も必要です。
よくある質問
K-means は教師ありですか、教師なしですか?
教師なしです。なぜなら、特徴とクラスタ数は与えられますが、目的ラベルは与えられないからです。
K-means は新しいデータを分類しますか?
モデルを適合させた後、新しい点は最も近い重心に割り当てることができます。これはクラスタ割り当てであり、必ずしも教師ありのクラス予測を意味するわけではありません。
主要参考文献












