AIの基礎
会話型音声認識(CSR)とは何か?

 Unite.AI を Google の優先ソースに追加
会話型音声認識(CSR)は、対話コンテキスト、ターンテイキング信号、話者情報、低遅延処理を利用して、従来の単発文字起こしを超える自動音声認識を実現します。目的は、単語、タイミング、割り込み、過去のターンがすべて重要となるリアルタイム対話を支援することです。
CSRは新興の製品・研究ラベルであり、単一の標準化されたモデルクラスではありません。優れたシステムは、ストリーミングASR とエンドポイント検出、話者処理、コンテキスト言語モデル、対話状態、応答ポリシーを組み合わせ、エンドツーエンドで体験を評価します。
重要ポイント
- ストリーミング認識は暫定的な仮説を出力し、音声が追加されるたびにそれらを修正します。
- エンドポイント検出とターン予測は文字起こし精度とは別の要素です。
- 会話履歴やホットワードは認識精度を向上させますが、過去のエラーを伝播させる可能性もあります。
- 評価項目はレイテンシ、割り込み、話者、アクセント、ノイズ、プライバシー、タスク完了度などであり、単語誤り率だけに頼ってはいけません。
ASR からライブ対話へ
従来のASRは音声をテキストに変換します。会話システムは、いつ聞き取りを開始し、いつターンが完了したか、発話がシステムに向けられているか、そして文字起こしや応答が誤っている場合にどう回復するかを判断しなければなりません。
ストリーミングモデルはフレームを逐次処理し、部分的な文字起こしを生成します。低レイテンシは応答性を向上させますが、早すぎる確定は修正やエラーを増やす可能性があります。アプリケーションは安定したテキストと暫定テキストを使い分けるポリシーを必要とします。
ターンテイキング、オーバーラップ、話者
沈黙時間だけではエンドポイント信号としては弱いです。語彙の完了、プロソディ、タイミング、視線、対話状態などが、相手が発言権を保持しているか譲るかを予測する手がかりになります。バージイン機能により、ユーザーは合成音声を中断してもコンテキストを失わずに済みます。
音声の重なりや話者分離は依然として難しい課題です。システムは話者の不確実性を保持し、誤って別人に発言を割り当てることを防ぎ、修正手段を提供すべきです。特に医療、金融、法務などで使用される記録において重要です。
コンテキスト認識
過去のターンは名前や参照先の曖昧さを解消できます。ホットワードリストはドメイン固有語への認識バイアスを与えます。音声言語モデルは、音声とテキストのコンテキストを共有のプロンプトやアテンション枠組みでエンコードすることがあります。
コンテキストは誤った過去の文字起こしを強化したり、セッション間で情報が漏れる原因にもなります。履歴は現在の目的に限定し、信頼できるメタデータとユーザー音声を分離し、明示的な保持・アクセスルールを伴う transformer コンテキストを使用してください。
評価と責任ある導入
ストリーミング時の単語誤り率、最初のトークンと最終化までのレイテンシ、修正率、エンドポイントエラー、バージイン成功率、話者割り当て、タスク完了度を報告してください。実際のマイク、ノイズ、アクセント、コードスイッチング、障害者音声、感情的な発話もテスト対象とします。
音声データは個人情報や機密情報を特定・漏洩させる可能性があります。同意取得、データ最小化、暗号化、保持期限、人間によるレビューを適用してください。生成された応答はチャットボットの安全制御と連携させる必要があります。正確な文字起こしだけでは、応答が正しい・許可されたものになるわけではありません。
音響入力から会話状態へ
会話型音声システムは音声を取得し、信号調整を行い、音声検出し、単語または意味単位を認識し、必要に応じて話者を識別し、対話状態を更新します。ストリーミングシステムは発話が終了する前に部分的な仮説を生成します。これらの仮説は変化し得るため、下流コンポーネントは暫定結果と最終結果を区別する必要があります。
音声活動検出とエンドポイント検出は、音声の開始とユーザーの終了を判断します。固定された沈黙閾値は、話し方が遅い、背景ノイズがある、考え込みの間がある場合に失敗します。ターンテイキングモデルは単語、プロソディ、視線、対話コンテキストを利用できますが、迅速な応答と話者を途中で遮ることのバランスを取らなければなりません。
話者分離は誰がいつ話したかを答え、話者認識は身元を推定し、音源分離は重なる音声を分離します。これらはリスクが異なる別個のタスクです。会議、医療、カスタマーサービスにおいて、正しい言葉を正しい人物に割り当てることは、文字起こしの単語誤り率と同等に重要になることがあります。
コンテキスト、オーバーラップ、感情、対話復元
会話コンテキストは代名詞、省略、修正、ドメイン用語、過去のターンへの参照を解決します。システムは音響証拠と対話履歴、取得した知識を組み合わせられますが、過去のコンテキストが誤った期待に認識をバイアスさせることもあります。音声証拠と信頼度を保持し、コンテキストが不確実性を黙って上書きしないようにしてください。
自然な対話にはバッキングチャネル、割り込み、言い直し、笑い、コードスイッチング、同時発話が含まれます。応答性の高いエージェントはバージイン処理が必要です。出力を停止または音量を下げ、ユーザーの新たな発話を取得し、割り込みが意図を変えるか判断し、アクションの重複や喪失なく復元します。
プロソディや副言語的信号は強調や不確実性を示すことがありますが、音声から感情、健康、意図を推測するのはエラーが多く文化依存です。こうした推定は慎重に使用し、適切な場面で開示し、検証されていない感情ラベルに基づく重要な判断は行わないでください。
評価、プライバシー、プロダクション設計
単語誤り率は依然として有用ですが、会話評価では話者割り当て、エンティティ精度、意味タスク成功率、部分仮説の安定性、エンドポイントレイテンシ、割り込み成功率、復元、ユーザー修正率も測定すべきです。アクセント、言語、デバイス、ノイズ、オーバーラップ、話し方、ネットワーク状況でセグメント化してください。
ストリーミングアーキテクチャはバッファ上限、バックプレッシャー、再接続、シーケンス番号、明示的な最終化が必要です。モデルと対話のレイテンシ予算は分離し、各ステージを追跡し、劣化したネットワークでもテストしてください。システムがアクションを起こす際は、影響度の高い意図を確認し、再試行を冪等にして、音声の重複や再接続で取引が二重になるのを防ぎます。
音声には話者の身元、内容、環境、傍聴者情報が含まれます。保持期間を最小限にし、転送と保存を暗号化し、アクセスを管理し、削除を定義し、音声と派生した文字起こしや埋め込みを区別してください。録音中であることを示す可視的インジケータを提供し、同意がない場合は代替手段を用意します。ローカルモデルは転送量を減らせますが、許可とライフサイクル管理は依然必要です。
実例:割り込みと修正に対応する音声エージェント
発信者が「火曜日を予約—いや、水曜日の午後に」と言い、エージェントが「火曜日」の後で応答を開始したとします。ストリーミング認識は変化する部分文字起こしを出力し、エンドポイント検出は発話が続くことを検知し、バージインで出力を停止します。対話状態は以前の日付を上書きされたものとしてマークし、二つのリクエストを作らないようにします。エンティティ確認は修正された日付と時間に焦点を当て、システムは最終解釈のために信頼度と証拠を保持します。
アーキテクチャは音声取得、音声検出、ストリーミング認識、話者処理、対話ポリシー、ツール実行、合成を分離します。シーケンス番号と最終化により、遅延した部分結果が最終文字起こしを上書きすることを防ぎます。予約ツールは構造化リクエストを受け取り、認可と空き状況を確認し、冪等キーを使用します。重要な予約は実行前に読み上げて確認され、再接続で静かに再実行されることはありません。
テストは単語とエンティティの精度をエンドポイントレイテンシ、割り込み成功率、修正処理、話者割り当て、タスク完了率、重複アクション率と組み合わせます。シナリオはノイズ、オーバーラップ、アクセント、コードスイッチング、遅い発話、支援デバイス、弱いネットワーク、合成攻撃を網羅します。音声の保持は最小限に抑え、開示し、傍聴者データは明示的に処理し、ユーザーはテキストまたは人間に切り替え可能です。会話インテリジェンスは安全な復元と結果で測定され、文字起こしの正確さだけでは評価しません。
実装チェックリスト
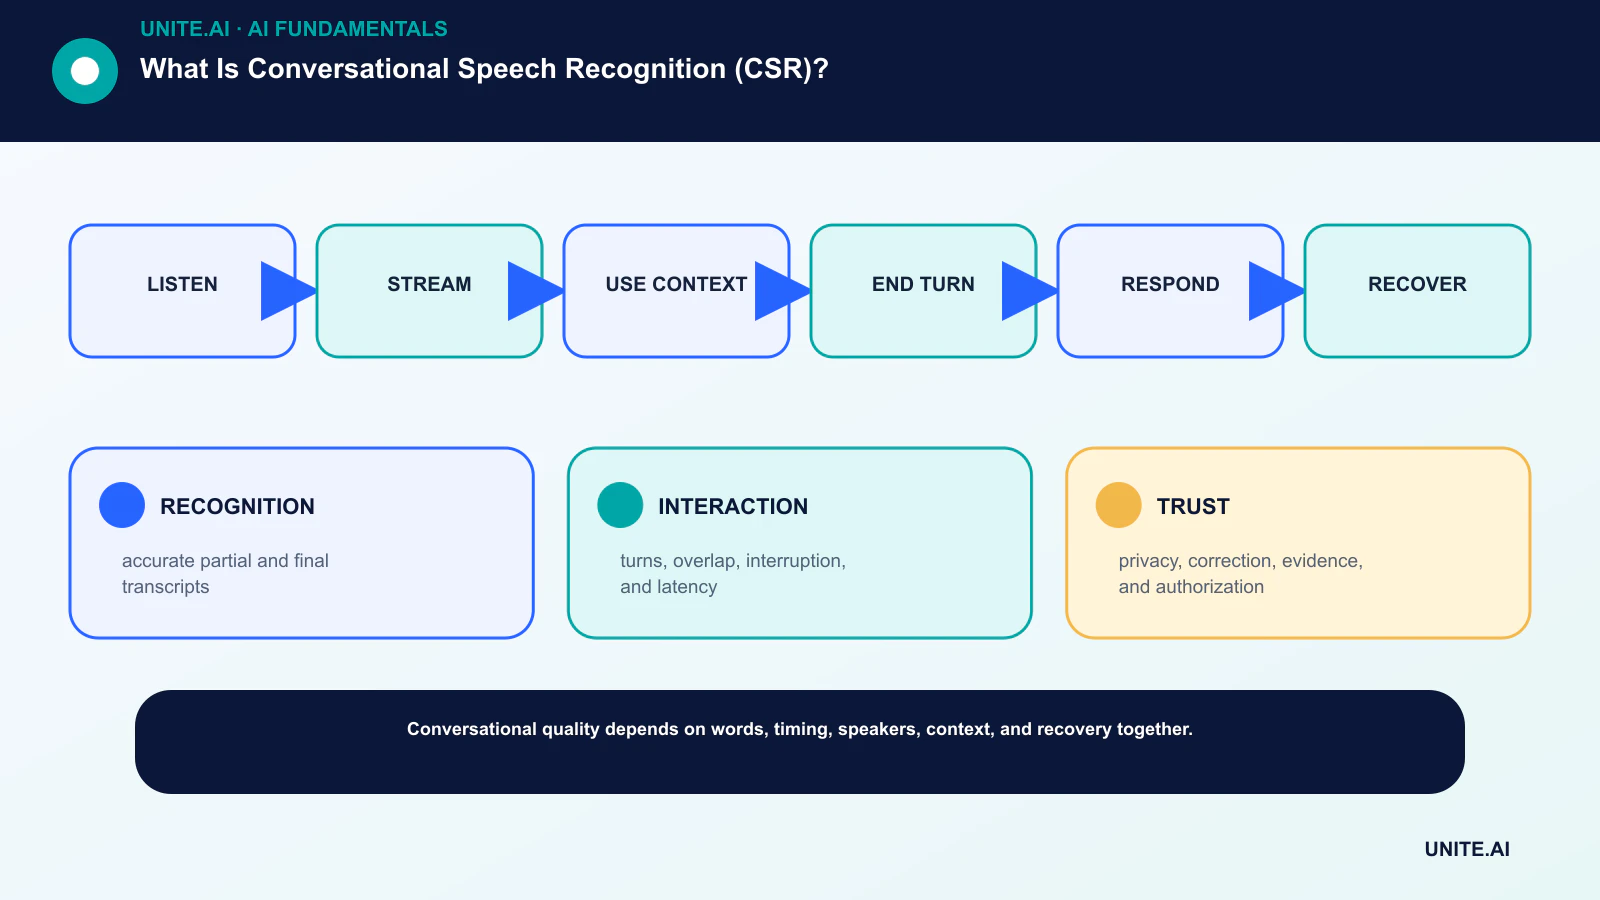
概念を範囲が限定されたテスト可能なワークフローに落とし込みます:聞く → ストリーム → コンテキスト利用 → ターン終了 → 応答 → 復元。責任者を明確にし、データと依存関係を文書化し、シンプルなベースラインを設定し、受入基準と停止基準を定め、代表的な失敗ケースをテストし、スコープ拡大前にモニタリング、ロールバック、レビューを定義します。バージョンと前提条件を記録し、他チームが結果を再現し変更点を把握できるようにします。
リリース前に、構築・運用・セキュリティ・影響を受ける関係者と文書化された準備レビューを実施します。通常ケース、境界条件、依存失敗、誤用をテストし、証拠と未解決リスクを保持します。リリース承認、閾値変更、出力上書き、運用停止ができる人物を定義してください。実データが入ったら判断を再検討します。技術的に成功したパイロットでも、規模拡大での信頼性が保証されるわけではありません。
- 認識: 正確な部分的および最終的な文字起こし。
- 対話: ターン、オーバーラップ、割り込み、レイテンシ。
- 信頼: プライバシー、修正、証拠、認可。
よくある質問
CSR は ASR と異なりますか?
ASR は音声からテキストへの変換コンポーネントです。CSR は ASR に加えて、対話コンテキスト、タイミング、話者・エンドポイント処理、ライブ対話向けのインタラクションポリシーを組み合わせます。
単語誤り率が低いことは、より優れた音声エージェントを保証しますか?
いいえ。システムは正確に文字起こしできても、ユーザーを割り込み、応答が遅く、話者を誤って割り当て、誤った操作を行うことがあります。エンドツーエンドのインタラクション指標が必要です。
主要参考文献