AIの基礎
大規模言語モデル(LLM)とは何か?

 Unite.AI を Google の優先ソースに追加
大規模言語モデル(LLM)は、トークンや関連する言語目的を予測するために、大規模なシーケンスコレクションで訓練されたニューラルネットワークです。現在のほとんどのLLMはトランスフォーマーアーキテクチャを使用し、共通インターフェースを通じて生成、分類、要約、翻訳、検索、変換を行うことができます。
LLMはデータベースでも、確実な推論エンジンでもありません。その出力は、訓練データ、事後訓練、コンテキスト、ツール、デコード方式によって形作られる条件付き予測です。流暢さは、事実誤り、不確実性、バイアス、または安全でない振る舞いと共存することがあります。
重要ポイント
- トークナイゼーションはテキストを離散的な単位に変換し、埋め込みとアテンションが文脈表現を構築します。
- 事前学習は広範なパターンを学習し、ファインチューニングと嗜好手法がタスクの振る舞いを形作ります。
- 検索とツールは最新の証拠やアクションを追加できますが、別途権限と検証が必要です。
- 導入したシステムを品質、根拠性、安全性、レイテンシ、コスト、ドリフトの観点で評価します。
トークン、トランスフォーマー、そして事前学習
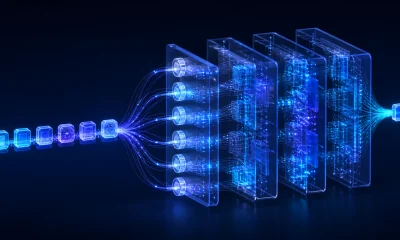
テキストはトークンに分割されます。トランスフォーマーはそれらをベクトルに変換し、アテンションとフィードフォワード層を通じて情報を混合し、次または欠落したトークンに対する確率分布を生成します。
自己教師あり目的は、生のシーケンスから訓練信号を作り出します。パラメータ、データ、計算規模の拡大は、一定範囲で損失を予測可能に改善しますが、データセットの品質、アーキテクチャ、最適化、評価が実際に現れる能力を決定します。
事後学習と推論
インストラクションチューニングはデモンストレーションを使用し、嗜好最適化は出力を人間の判断やポリシーにより近づけます。推論時には、プロンプトと会話履歴がコンテキストを定義し、温度やサンプリング設定が変動性に影響します。
RLHF(人間のフィードバックによる強化学習)や類似手法は、完全な事実チェック機能を組み込むのではなく、振る舞いを形成します。モデルは依然として、説得力はあるが根拠のない回答を生成することがあります。
検索、ツール、エージェント
検索強化生成は外部コレクションから選択されたパッセージを提供します。ツール呼び出しにより、アプリケーションコードはデータベースへのクエリ、計算、検索、またはアクションを実行できます。これらのパターンは、知識と実行をモデルの重みから分離します。
アプリケーションはツール引数を検証し、権限を強制し、引用を保持し、取得したコンテンツを信頼できない入力として扱う必要があります。ベクトル類似検索は検索を支援しますが、パッセージが回答を裏付けることを証明するわけではありません。
制限事項と評価
LLMは幻覚を起こしたり、記憶されたコンテンツを露出したり、悪意ある指示に従ったり、バイアスを再現したり、訓練例に似たタスクで失敗したりする可能性があります。長いコンテキストでも、すべての事実が正しく使用または調整される保証はありません。
代表的なプライベートタスクと文書化されたプロンプト・バージョンで評価します。ソースによる裏付け、拒否率、キャリブレーション、セキュリティ、サブグループの結果、人間の作業負荷、レイテンシ、コストを測定します。リリース後もモデル、データ、ユーザー行動が変化するため、継続的にモニタリングします。
訓練データとモデル開発
事前学習コーパスはウェブページ、書籍、コード、学術資料、会話、ライセンスまたはキュレーションされたソースを組み合わせます。パイプラインは言語を検出し、重複を除去し、品質と安全でないコンテンツをフィルタリングし、個人データを処理し、混合比重を選択します。これらの選択が知識、言語カバレッジ、スタイル、バイアス、記憶性を形作ります。
最適化プロセスはトークンシーケンスのバッチを処理し、勾配降下で予測損失を最小化します。分散訓練はデータ、モデルテンソル、パイプライン段階、またはエキスパートをアクセラレータ間で分割します。チェックポイント、数値安定性、ネットワーク通信、障害復旧が大規模では重要なエンジニアリング課題となります。
訓練中の評価は損失と能力スイートを追跡しますが、ベンチマーク汚染が結果を膨らませることがあります。時間帯や専有タスクをホールドアウトし、重複を検索し、正確なプロンプト、デコード、ツール、スコアリングを報告します。モデルは平均損失を改善しながら、安全性や低リソース言語での退行が起こり得ます。
コンテキストウィンドウ、デコード、そして推論
推論時、キー・バリュ―キャッシュは過去トークンのアテンション射影を保存し、各ステップで再計算する必要がなくなります。キャッシュメモリは層、シーケンス、バッチ、表現とともに増大します。量子化とページングは負荷を軽減しますが、品質やレイテンシを変えることがあります。
貪欲デコードは最も確率の高いトークンを選択し、温度は確率を再スケールし、top‑k と top‑p は候補集合を制限し、ビームサーチは複数シーケンスを追跡します。最適な戦略は、タスクが決定性、多様性、構造化出力、またはシーケンス尤度を重視するかに依存します。生成後は必ずスキーマを検証してください。
長いコンテキストは利用可能な情報量を増やしますが、リコールや推論が保証されるわけではありません。位置情報、妨害要素、矛盾、プロンプト構造が使用に影響します。検索は証拠セットを小さく選択でき、要約は履歴を圧縮しますが、詳細が失われるリスクがあります。コンテキスト長と位置による性能を測定してください。
適応、デプロイ、そして経済性
フルファインチューニングはすべてのパラメータを更新し、パラメータ効率的手法はアダプタや低ランク行列を更新し、継続的事前学習はドメイン分布に適応し、インストラクションと嗜好チューニングは応答を形作ります。頻繁に変わる事実には検索が適し、振る舞いとタスク形式にはチューニングが適します。これらの手法は組み合わせ可能です。
デプロイの選択肢にはホスト型API、マネージドエンドポイント、自己ホスト型オープンウェイト、デバイス上モデル、ハイブリッドがあります。データ取扱い、バージョン管理、レイテンシ、スループット、リージョン、可用性、モデルの移植性、サポート、総コストを比較してください。自己ホスティングはセキュリティ、スケーリング、アップデート、悪用監視の責任を移転します。
トークンあたりのコストは不完全です。弱いモデルは再試行、長いプロンプト、より多くのレビュー、または高価なエラーを要することがあります。必要な品質とリスクレベルで成功裏に完了したタスクあたりのコストを測定します。キャッシュ、バッチ処理、より小さなルーティングモデル、決定的コードは、全体ワークフローを改善する場合に活用してください。
実例:エンタープライズ文書にLLMを基盤付けする
文書アシスタントは、権限を考慮したコーパス、安定した文書識別子、バージョンと有効日、解析可能な構造、そして回答可能・回答不可能・曖昧・矛盾する質問の評価セットから開始すべきです。検索はチャンクとメタデータをインデックス化しますが、チャンクサイズとオーバーラップは文書構造に合わせる必要があります。検索品質は生成前に独立して測定されるため、流暢なモデルが証拠の欠如を隠すことはできません。
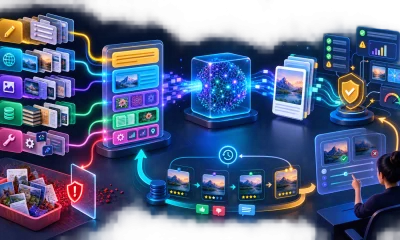
実行時にはユーザーを認証し、アクセス権で検索をフィルタし、証拠を取得・再ランク付けし、境界付きプロンプトを構築し、引用付き回答を生成し、必要な出力を検証します。モデルはソースが矛盾する場合や回答を裏付けない場合にその旨を述べるべきです。ツール使用や外部アクションは別途承認が必要です。取得した文書に埋め込まれた指示に対しては、コンテンツをデータとして扱い、上位システムポリシーより優先しないよう保護してください。
検索リコール、引用精度、回答正確性、根拠性、拒否率、レイテンシ、コストを役割と文書タイプ別に評価します。テストごとにモデル、プロンプト、インデックス、パーサ、コーパスのバージョンを追跡します。本番環境では、証拠IDとフィードバックをプライベートテキストを露出せずに記録し、コンテンツ変更後に新たに回答不可能な質問を監視し、安全なフォールバックを維持します。LLMインターフェースは記録管理、アクセス制御、責任ある専門家レビューの代替にはなりません。
容量計画では、プロンプトと出力の長さ分布、同時ユーザー数、キャッシュ動作、ツールレイテンシ、再試行率をモデル化すべきです。ストリーミングは知覚レイテンシを改善しますが、モデレーションとキャンセルが複雑になります。なぜなら、安全でないまたは誤ったコンテンツが全体応答がチェックされる前にユーザーに届く可能性があるからです。トークンとツールの予算を設定し、テナントを分離し、プロバイダー資格情報を保護し、モデルバージョン間のフェイルオーバーを演習して、ユーザーが依存する振る舞いが静かに変わらないようにします。
実装チェックリスト
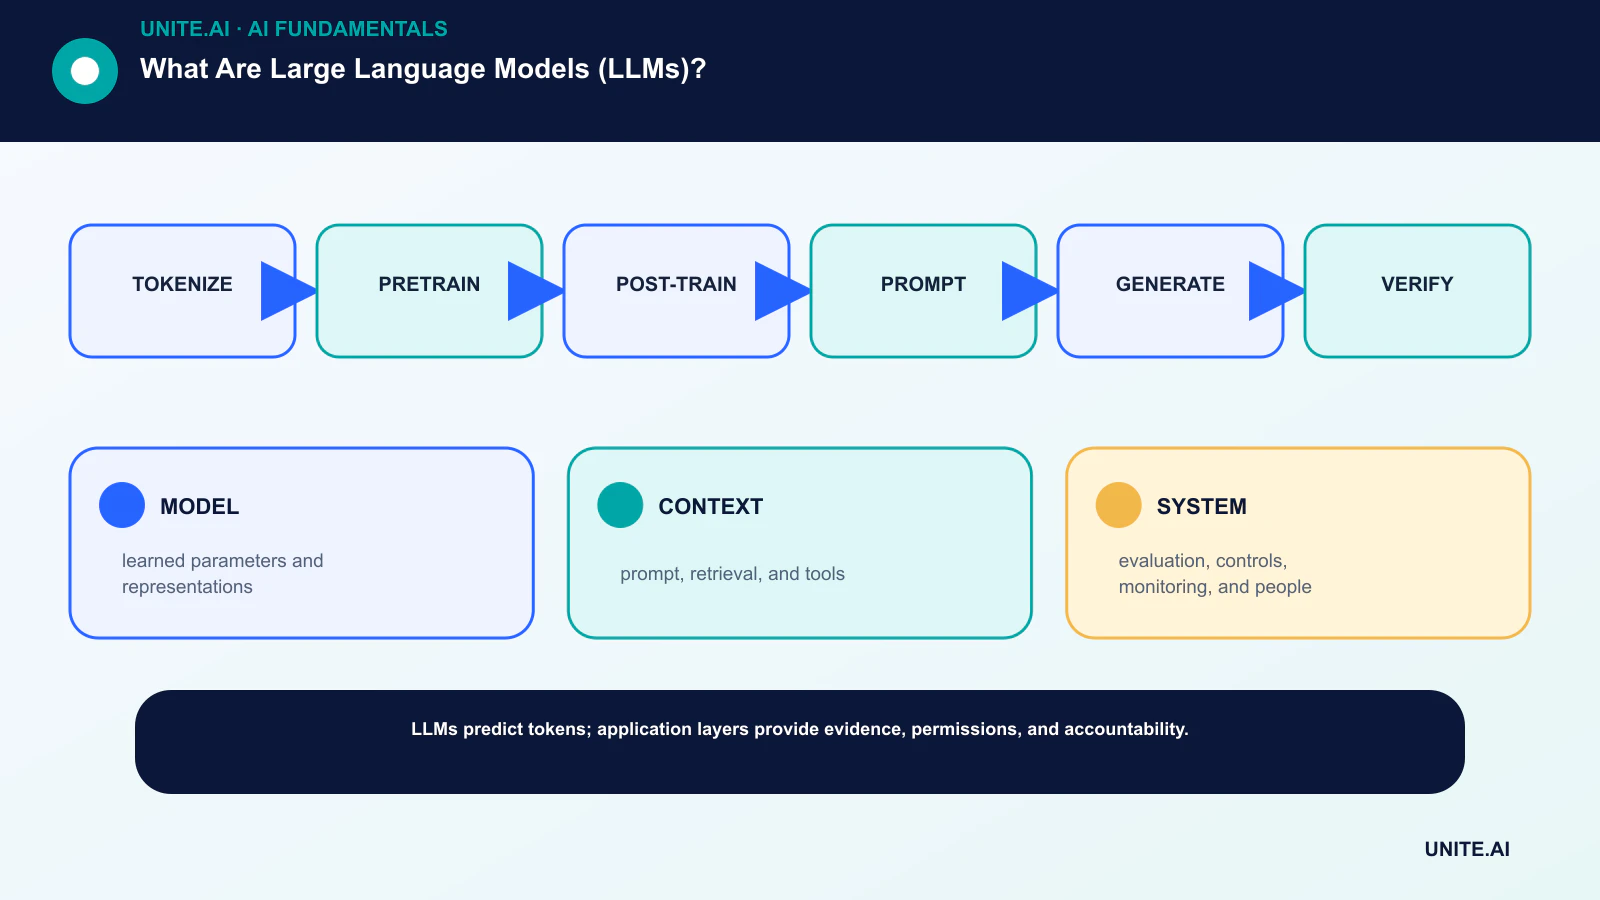
概念を境界付きでテスト可能なワークフローに落とし込みます:トークナイズ → 事前学習 → 事後学習 → プロンプト → 生成 → 検証。責任者を指名し、データと依存関係を文書化し、シンプルなベースラインを確立し、受入基準と停止基準を設定し、代表的な失敗ケースをテストし、スコープ拡大前にモニタリング、ロールバック、レビューを定義します。バージョンと前提条件を記録し、別チームが結果を再現し、何が変わったかを理解できるようにします。
リリース前に、構築・運用・セキュリティ・影響を受ける関係者と共に文書化された就緒レビューを実施します。通常ケース、境界条件、依存失敗、誤用をテストし、証拠と未解決リスクを保存します。誰がリリースを承認し、閾値を変更し、出力を上書きし、または運用を停止できるかを定義します。実データが到着したら判断を再検討してください。技術的に成功したパイロットは、規模拡大時の信頼できる性能を保証しません。
- MODEL: 学習されたパラメータと表現。
- CONTEXT: プロンプト、検索、ツール。
- SYSTEM: 評価、制御、モニタリング、そして担当者。
よくある質問
LLMはなぜ「大規模」なのですか?
普遍的なパラメータ閾値は存在しません。「大規模」は、従来の言語モデルと比較したスケールを指し、パラメータ数、訓練データ量、計算リソース、利用範囲などを含みます。
LLMは言語を理解しますか?
LLMは有用な内部表現を構築し、複雑な振る舞いを示しますが、「理解する」という語には複数の意味があります。性能は流暢さから推測するのではなく、タスクごとに実証すべきです。
主要参考文献