
AIの基礎
チャットボットの構築方法:アーキテクチャ、データ、安全性、評価

 Unite.AI を Google の優先ソースに追加
チャットボットは、メッセージを受信し、ユーザーのニーズを判断し、テキストまたは音声で応答を返すアプリケーションです。最新のシステムは、単一のモデルに依存するのではなく、ルール、検索、分類器、トランスフォーマー、ツール、そして大規模言語モデルを組み合わせることがあります。
有用なチャットボットを構築することは、製品とシステムの課題です。対話層は信頼できる知識やビジネスアクションと接続する必要があり、身元確認、権限、ログ記録、評価、フォールバック、そして人間へのエスカレーションがボットの許容範囲を制約します。
重要なポイント
- まずは限定的なユーザータスクと測定可能な成功基準から始める。
- 言語生成を検索、ツール、権限、ビジネスルールから分離する。
- 曖昧さ、割り込み、拒否、回復を含む完全な会話をテストする。
- プロンプトとモデル出力は信頼できないデータとして扱い、運用を監視し、エスカレーション経路を保持する。
モデルを選ぶ前に仕事を定義する
ユーザーが誰で、何を達成しようとしているか、システムがアクセスできるデータ、確認が必要なアクションを記述します。FAQボット、注文ステータスアシスタント、アカウント管理エージェントは、リスクプロファイルが大きく異なります。
AI を使用しないベースラインと代表的な会話の受容セットを作成します。タスク完了率、回答のサポート、レイテンシ、放棄率、エスカレーション、そして有害なエラーのコストを測定します。流暢なデモは、ワークフローが信頼できることの証拠ではありません。
レイヤードアーキテクチャを使用する
典型的なパイプラインは、チャネルアダプタ、セッション状態、入力検証、インテントまたはルーティングロジック、検索、応答またはポリシーモデル、ツールアダプタ、そして可観測性を含みます。検索は承認済み文書に基づいて回答を根拠付けられ、ツールは明示的なスキーマを通じて制御されたアクションを実行します。
決定論的なチェックは言語モデルの外部に保ちます。認証、認可、在庫制限、返金、そして取り消し不可能なアクションはアプリケーションコードで実施すべきです。プロンプトエンジニアリングは振る舞いを形成できますが、アクセス制御システムではありません。
対話、知識、回復を一体的に設計する
優れた会話は、不完全なリクエスト、訂正、複数のインテント、そして過去のターンへの参照を処理します。タスクに必要なコンテキストだけを保存し、保持状態を可視化し、ユーザーの発言と承認システムが返す信頼できる事実を区別します。
信頼度や証拠が不十分な場合、ボットは焦点を絞った質問を行うか、安全な代替案を提示するか、簡潔な要約とともに人間に転送すべきです。回復はコア体験の一部であり、リリース後に追加される例外ケースではありません。
システム全体を評価・運用する
検索品質、ツール選択、引数の正確性、ポリシー遵守、プロンプトインジェクション耐性、プライバシー漏洩、エンドツーエンドの結果をテストします。レッドチームによる敵対的入力を行い、悪意ある文書がシステム指示を静かに上書きできないことを検証します。
プロンプト、インデックス、モデル、ポリシー、ツールのバージョン管理を行います。プライバシー制御付きでサンプリングした会話をレビューし、ドリフトや障害クラスターを監視し、ロールバックを維持します。この運用規律はチャットボット開発をAIOps とインシデント対応に結びつけます。
コアチャットボットコンポーネントの詳細
チャネル層はウェブチャット、モバイルアプリ、メッセージングプラットフォーム、または音声からの入力を正規化します。セッション層はメッセージを認証済みまたは匿名の会話に紐付け、期限切れを強制し、タスクに必要な状態だけを保存します。入力制御はサイズとファイルタイプを制限し、安全でないペイロードを検出し、下流システムが実行すべきでないマークアップを除去します。
ルーターはリクエストが決定論的フロー、検索、生成、または人間キューのどれに属するかを判断します。ラベルセットが安定している場合、従来のインテント分類器は依然有用です。言語モデルは柔軟ですが較正が難しいです。ハイブリッドルーターは、規制対象や高ボリュームのタスクをテスト済みワークフローに割り当て、オープンエンドな説明には汎用モデルを使用できます。
応答層は証拠と状態を別々に保持すべきです。生成された文は取得したパッセージを引用できますが、どのソースとバージョンがそれを支えているかをアプリケーションが保持しなければなりません。会話メモリはユーザーの好みと検証済みアカウントデータを区別し、過去のユーザーメッセージが新たな権限を付与することを決して許容しません。
検索、ツール、トランザクション
検索品質はベクトル検索の前から始まります。文書は所有権、アクセスラベル、正規バージョン、役立つチャンク、削除日が必要です。クエリの書き換え、キーワード検索、埋め込み、フィルタ、再ランク付けを組み合わせることができます。評価は、必要な証拠が取得されたか、無関係なパッセージが除外されたか、回答が実際に証拠に基づいているかを測定すべきです。
ツールはモデルの提案を型付けされたアプリケーションコードへのリクエストに変換します。各ツールは限定的な目的、明示的なスキーマ、サーバー側検証、最小権限の認証情報、タイムアウト、可能な限りの冪等性、そして明確な結果が必要です。モデルは、生のデータベースクエリや任意の URL を構築すべきではなく、代わりに限定されたビジネス操作を公開すべきです。
トランザクションはコミット時に確認が必要です。受取人、金額、住所、日付、またはアクセス変更といった重要項目をユーザーに提示し、過去の「はい」を新たなアクションの承認として扱わないようにします。マルチステップの作業では、モデル外にステートマシンを保持し、リトライやメッセージの順序変更で必須のゲートを迂回できないようにします。
実践的な構築と評価計画
まず20〜50の代表的なタスクから始め、失敗、曖昧、スコープ外のリクエストも含めます。期待されるアクション、証拠、エスカレーション、禁止行為をマークします。最もシンプルで実行可能なフローを実装し、測定された成果が向上する場合にのみ検索や生成を追加します。これにより、インターフェースが複雑になる前に再利用可能な回帰テストスイートが作成されます。
コンポーネントと会話を個別に評価します。検索指標、ツール呼び出しの正確性、ポリシー検査、応答サポートは特定の失敗を診断し、タスク完了率とユーザーの労力はシステム全体の品質を示します。以前の詳細を修正したり、フローを中断したり、トピックを切り替えたり、必要情報を隠したり、依存関係の失敗を引き起こすマルチターンテストを使用します。
本番展開はユーザーグループ、タスク、権限別に段階的に行うべきです。サポートされていない主張、繰り返しの確認、ツールの拒否、エスカレーション、レイテンシ、放棄を監視します。プライバシーに配慮したサンプルをレビューし、各ツールの緊急無効化パスを維持し、インシデントの知見を活用してプロンプト、データ、コード、テストセットを同時に更新します。
実例:プロトタイプから本番までのサポートチャットボット
小売業者が注文や返品に関する質問に答えるチャットボットを欲していると仮定します。まず、サポート対象のインテント、エスカレーション条件、承認済み知識、認証ルール、禁止アクションを定義します。曖昧なリクエスト、スペルミス、多言語入力、怒りのユーザー、プロンプトインジェクション、回答なしの質問などを含む、個人情報を除去した過去の質問からテストセットを構築します。検索ベースラインは、生成応答がポリシーや注文ステータスを主張できる前に証拠を返すべきです。
ランタイムはインテントを分類し、ポリシーのパッセージを取得し、アカウントデータが必要な場合にのみ本人確認を要求し、限定的な注文 API を呼び出し、回答を作成し、引用を添付できます。各ツール呼び出しは明示的なスキーマ、認可チェック、タイムアウト、リトライポリシー、冪等性キーが必要です。モデルは生のデータベースクエリを構築したり、独自に権限を決定したりすべきではありません。キャンセルや返金といった高影響アクションは確認が必要で、定義された上限を超える場合は人間の承認が必要です。
インテントの正確性、回答の正しさ、証拠の裏付け、拒否の品質、成功した抑制、エスカレーションの精度、レイテンシ、解決された会話あたりのコストを評価します。平均ではなくインテントとユーザーグループ別に結果をレビューします。本番環境では、同意を考慮したトレース、ツール結果、取得した文書バージョン、ユーザー修正をログに残します。段階的に展開し、既存チャネルと比較し、エラー、悪用、依存性の閾値を超えた場合は機能を無効化します。
実装チェックリスト
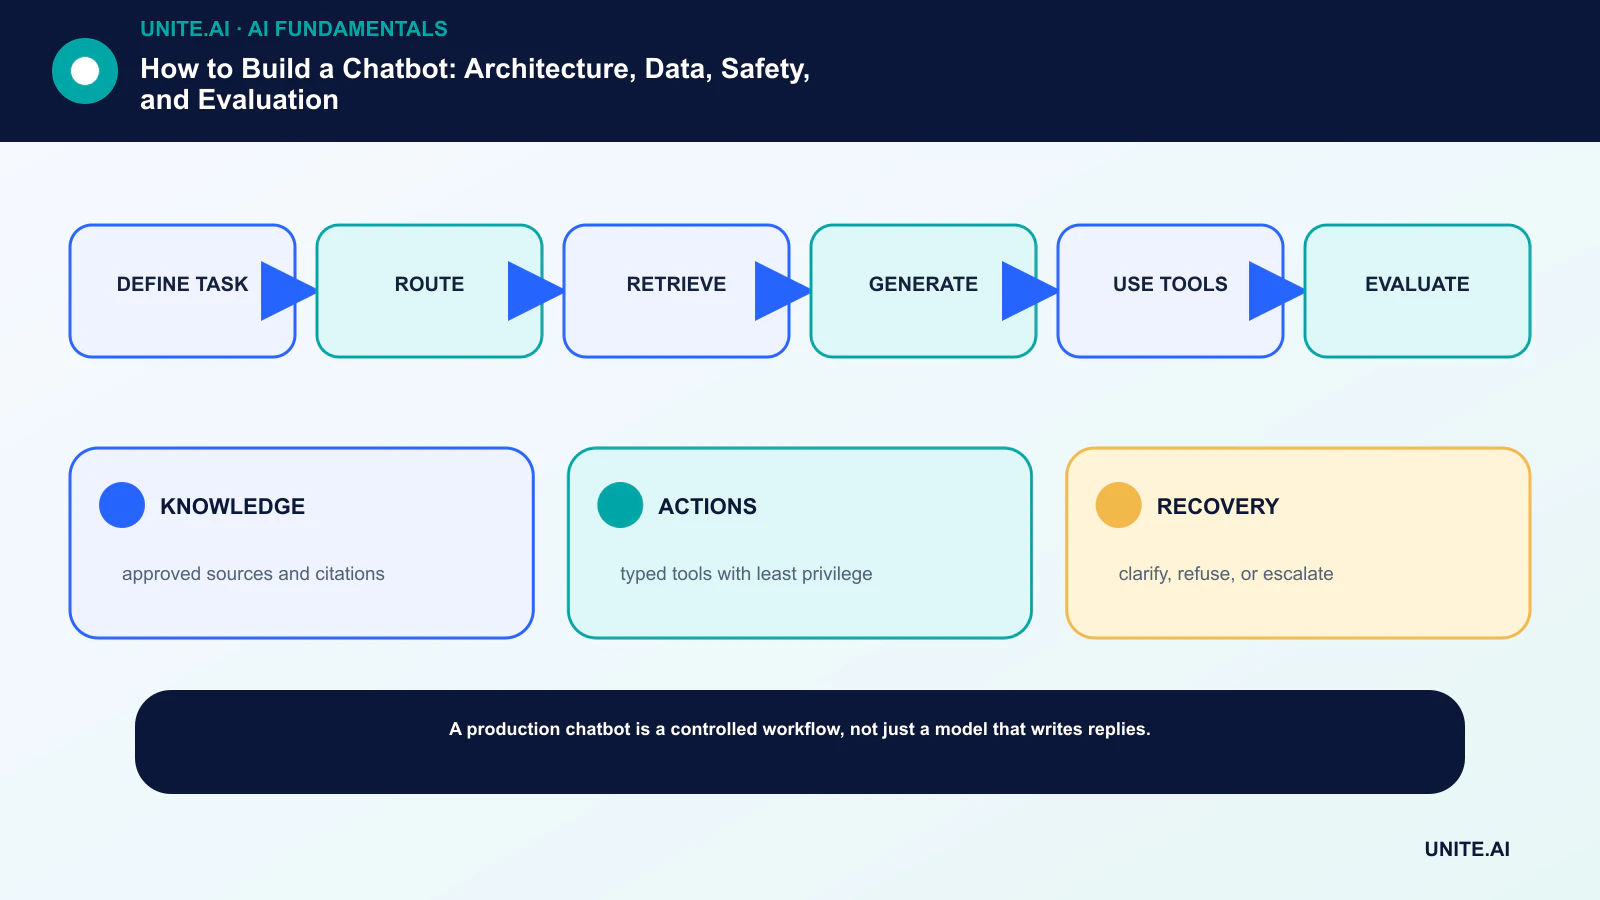
概念を限定的でテスト可能なワークフローに変換します: タスク → ルーティング → 検索 → 生成 → ツール使用 → 評価 を定義します。責任者を指名し、データと依存関係を文書化し、シンプルなベースラインを確立し、受容基準と停止基準を設定し、代表的な失敗をテストし、スコープ拡大前にモニタリング、ロールバック、レビューを定義します。バージョンと前提条件を記録し、別チームが結果を再現し、変更点を理解できるようにします。
リリース前に、構築・運用・セキュリティ・影響を受ける関係者と文書化された準備状況レビューを実施します。通常ケース、境界条件、依存関係の失敗、誤用をテストし、証拠と未解決リスクを保持します。リリース承認、閾値変更、出力上書き、運用停止ができる人物を定義します。実データが到着したら判断を再検討します。技術的に成功したパイロットでも、規模拡大で信頼できるパフォーマンスが保証されるわけではありません。
- KNOWLEDGE: 承認された情報源と引用。
- ACTIONS: 最小権限の型付きツール。
- RECOVERY: 明確化、拒否、またはエスカレーション。
よくある質問
チャットボットは大規模言語モデルが必要ですか?
いいえ。ルール、検索、フォーム、そして小規模な分類器は、限定的なタスクに対してより安全でコストも低く抑えられます。柔軟な言語理解や生成が測定可能な価値を生む場合にのみ、LLM が有用です。
リリース前に何をテストすべきですか?
代表的なタスク、サポートされていないリクエスト、曖昧な表現、ツールの失敗、プライバシー境界、敵対的プロンプト、人間へのハンドオフ、レイテンシ、そしてすべての結果的なアクションの正確性です。
主要参考文献












