AIの基礎
機構的解釈性とは何か?研究者がAIモデルを分析する方法

 Unite.AI を Google の優先ソースに追加
機構的解釈性は、ニューラルネットワーク内部で学習された構成要素がどのように因果的に振る舞いを生み出すかを研究します。入力と出力の相関だけでなく、研究者は特徴、アテンションヘッド、ニューロン、回路について仮説を立て、介入してその仮説を検証します。
この分野では、小規模・中規模モデルの特定の振る舞いに対して詳細な説明が得られていますが、最先端モデル全体を完全かつ忠実に説明することはまだ達成できていません。自動生成された説明や魅力的な可視化は有用な出発点になり得ますが、証拠ではありません。
主なポイント
- 特徴は表現されたパターンであり、回路は計算を実装すると提案される相互作用するコンポーネントです。
- 活性化パッチング、アブレーション、因果トレースは、コンポーネントが振る舞いを変えるかどうかをテストします。
- 重ね合わせとは、1つのニューロンが多数の特徴に関与できることを意味し、スパースオートエンコーダは別の特徴基底を試みます。
- 解釈手法は、真実の基準、反証可能なテスト、カバレッジ、そして代替説明との比較評価が必要です。
表現からメカニズムへ
プロービングは、活性化から情報を復号できるかどうかを問います。帰属解析は、どの入力やコンポーネントが重要かを推定します。機構的研究は、内部計算を提案し、介入が期待される中間および最終的な振る舞いを変えるかどうかを検証することで、さらに踏み込んだ分析を行います。
この点で説明可能なAIと関連しますが、範囲はより狭いです。1つの決定に対する事後的説明が、必ずしもモデル内部の逆設計されたアルゴリズムであるとは限りません。
回路と因果的介入
研究者は、タスクに関連するアテンションヘッドや特徴を特定し、アブレーションしたり、別の実行からの活性化をパッチしたり、情報が層を横断してどのように伝搬するかをトレースしたりします。優れた仮説は新しい例での振る舞いを予測し、コントロールに耐えます。
介入は分布外の状態を生み出す可能性があるため、振る舞いの変化が直ちに自然な計算を示すわけではありません。1つの例示的プロンプトに頼るのではなく、複数の手法、適切なコントロール、定量的な効果を用いるべきです。
重ね合わせとスパース特徴
ニューラルネットワークは、特徴を重ね合わせることで個々の次元以上の特徴を表現できます。そのため、1つのニューロンが複数の無関係なパターンに対して活性化し、ニューロン単位のラベルが誤解を招くことがあります。
スパースオートエンコーダは、モデルの活性化からより大規模な特徴辞書を学習します。これによりパターンの分離性が向上する可能性がありますが、選択されたスパース性、学習データ、再構成誤差、そして自動ラベルが回復される内容に影響します。ニューラルネットワークの特徴は依然として因果的検証が必要です。
安全性、デバッグ、限界
機構的ツールは、記憶された事実やバイアス、欺瞞的戦略、失敗回路を発見し、編集やモニタリングを支援することがあります。しかし、同じツールでは分散的、稀少、または文脈依存の計算を見逃すことがあります。
発見はスコープが限定された証拠として扱うべきです: モデルのバージョン、タスク、データセット、層、介入、効果、そして不確実性。解釈を行動評価、レッドチーミング、そして責任あるAIガバナンスに結び付け、包括的な安全証明として使用しないでください。
表現、回路、因果的証拠
機構的解釈性は、内部計算がどのようにモデルの振る舞いを生み出すかを研究します。研究者は活性化、重み、アテンション、そして中間特徴を検査し、表現や回路に関する仮説を立てます。表現は必ずしも単一のニューロンに格納されるわけではなく、方向、層、トークン、文脈依存の組み合わせに分散していることがあります。
スパースオートエンコーダは、密な活性化を選択的に活性化するより多くの特徴集合に分解しようとします。特徴ラベルは観測された例に対する人間の解釈であり、真実の基準ではありません。再構成誤差、スパース性、特徴の分割、吸収、そして死んだ特徴が、分解が明らかにするものと見落とすものに影響します。
相関だけでは機構的主張には不十分です。活性化パッチング、アブレーション、因果トレース、ステアリング、そして対象となる重みの介入は、コンポーネントが予測通りに振る舞いを変えるかどうかをテストします。介入は分布外状態を生むこともあるため、結果にはコントロール、用量反応解析、代替説明、そしてプロンプトやモデルを跨いだ再現性が必要です。
厳密な解釈ワークフロー
まず、正確に測定された振る舞いと、競合する仮説を区別できるデータセットから始めます。関連する層、位置、コンポーネント、または特徴を特定し、候補メカニズムを検査し、介入し、提案された回路が新たなケースを予測できるかテストします。探索的な例と検証的評価を分離し、選択バイアスを減らします。
自動化ツールはニューロン、特徴、ヘッド、パスをランク付けでき、言語モデルは説明文を提案できます。自動化はカバレッジを拡大しますが、説得力のあるストーリーを捏造することもあります。説明は保持された活性化例と因果予測でスコアリングし、不確実性を記録し、モデルバージョン、トークナイザー、プロンプト、コードと共に成果物を再現可能にします。
メカニズムは多義的、冗長、非線形、そして分散的であることがあります。1つのコンポーネントを除去しても他が補完することがあり、特徴は複数の振る舞いに関与することがあります。否定的な発見は有益です: キュレーションされた例外で失敗する見かけ上の回路は、説明を曖昧にして救済するのではなく、絞り込むか棄却すべきです。
応用、限界、そして安全性の主張
解釈性は、幻覚、バイアス、記憶、ジャイルブレイク行動、予期せぬ汎化のデバッグ、モデル比較、科学的仮説の生成に役立ちます。また、モニタリングや介入のための特徴を特定することも可能です。これらの活用にはタスク固有の検証が必要で、有用な研究可視化が自動的に信頼できる本番制御になるわけではありません。
検出された特徴が存在しないことは、能力や意図が存在しないことを証明するものではなく、可読な特徴があるからといってモデルがその回答で使用したことを証明するわけでもありません。ツールは計算の投影を限られたカバレッジで観測します。安全性の主張は、検出感度、偽陽性、分布、敵対者、既知の盲点を明示すべきです。
解釈性は行動評価、レッドチーミング、データガバナンス、アクセス制御、モニタリング、インシデント対応と併用してください。可能であれば手法と反例を公開しましょう。分野は急速に進展していますが、現行技術は最先端モデルの推論を完全かつ忠実に説明したり、一般的な整合性保証を提供したりするには至っていません。
実例:提案されたモデル回路のテスト
モデルが文中の間接目的語を解決するために一連のアテンションヘッドと特徴を利用しているように見えるとします。研究者は名前、位置、妨害要素、反例を変化させた制御データセットを定義し、振る舞いを測定します。活性化の検査で候補コンポーネントが特定されますが、仮説は介入前に作成されます: 各コンポーネントがどの情報を保持し、どこへ移動し、変更すると出力がどのように変わるか。
活性化パッチングとアブレーションは、保持された例に対して必要性と十分性をテストします。期待通りに予測トークンを変えるターゲット編集はメカニズムを支持しますが、全体的な性能低下は支持しません。コントロールとして無関係な位置やコンポーネントをパッチし、介入の大きさを変え、代替回路と比較します。チームは説明が失敗した否定的事例を公開し、相関だけから人間が読める目的を割り当てることを避けます。
安全性の応用を主張するには、手法が現実的なプロンプトと敵対的適応下で既知の感度で関連する振る舞いを検出できなければなりません。特徴モニタは偽陽性、回避、モデル更新、因果的関連性で評価されます。解釈的証拠はデバッグや追加テストの指針となりますが、実施は外部の制御と行動モニタリングに委ねられます。説得力のある回路図は証拠を伴う科学的仮説であり、モデル全体の完全な説明や未観測振る舞いの保証ではありません。
実装チェックリスト
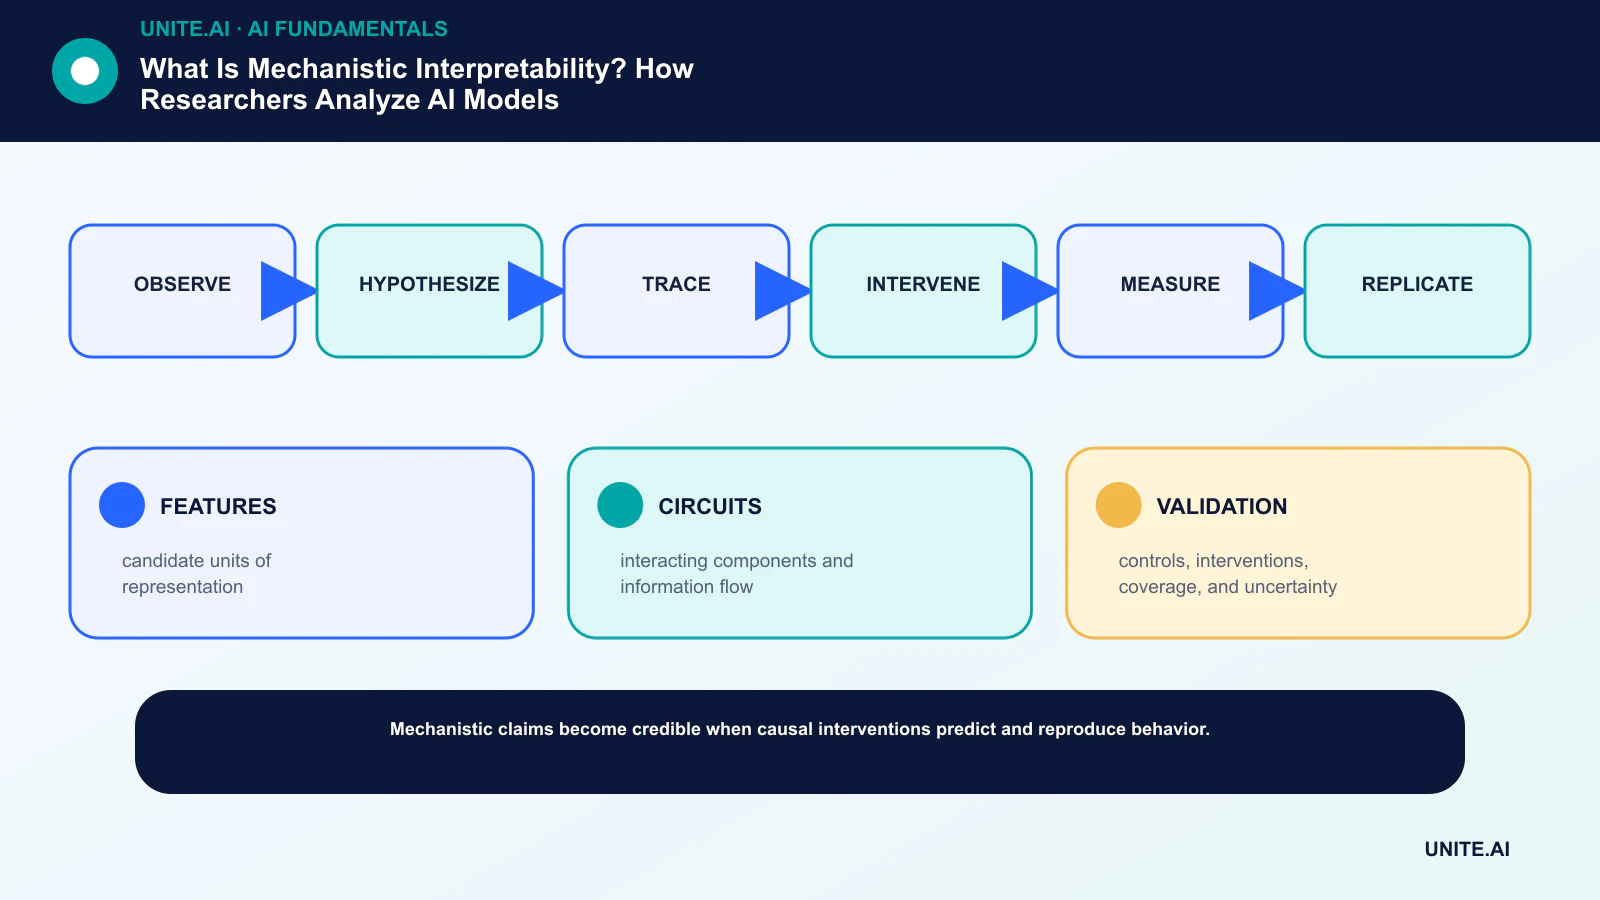
概念を限定的でテスト可能なワークフローに変換します: 観察 → 仮説 → トレース → 介入 → 計測 → 再現。責任者を指名し、データと依存関係を文書化し、シンプルなベースラインを設定し、受容基準と停止基準を定め、代表的な失敗をテストし、スコープ拡大前にモニタリング、ロールバック、レビューを定義します。バージョンと前提条件を記録し、別チームが結果を再現し変更点を把握できるようにします。
リリース前に、構築・運用・保護・影響を受ける関係者と文書化された準備レビューを実施します。通常ケース、境界条件、依存失敗、誤用をテストし、証拠と未解決リスクを保存します。リリース承認、閾値変更、出力上書き、運用停止ができる人物を定義します。実データが入った後に判断を再検討してください。技術的に成功したパイロットが大規模での信頼性を保証するわけではありません。
- FEATURES: 表現の候補単位。
- CIRCUITS: 相互作用するコンポーネントと情報フロー。
- VALIDATION: コントロール、介入、カバレッジ、そして不確実性。
よくある質問
機構的解釈性はモデルの重みを読むことと同じですか?
いいえ。生の重みは自明ではありません。研究者は活性化、特徴、コンポーネント、介入を分析し、因果的仮説を構築・検証します。
スパースオートエンコーダはLLMを完全に説明できますか?
いいえ。スパースオートエンコーダは候補となる特徴基底を提供し、回路解析を支援できますが、カバレッジ、忠実性、再構成、ラベリング、スケーラビリティは未解決の課題です。
主要参考文献