
AIの基礎
教師あり学習 vs 教師なし学習

 Unite.AI を Google の優先ソースに追加
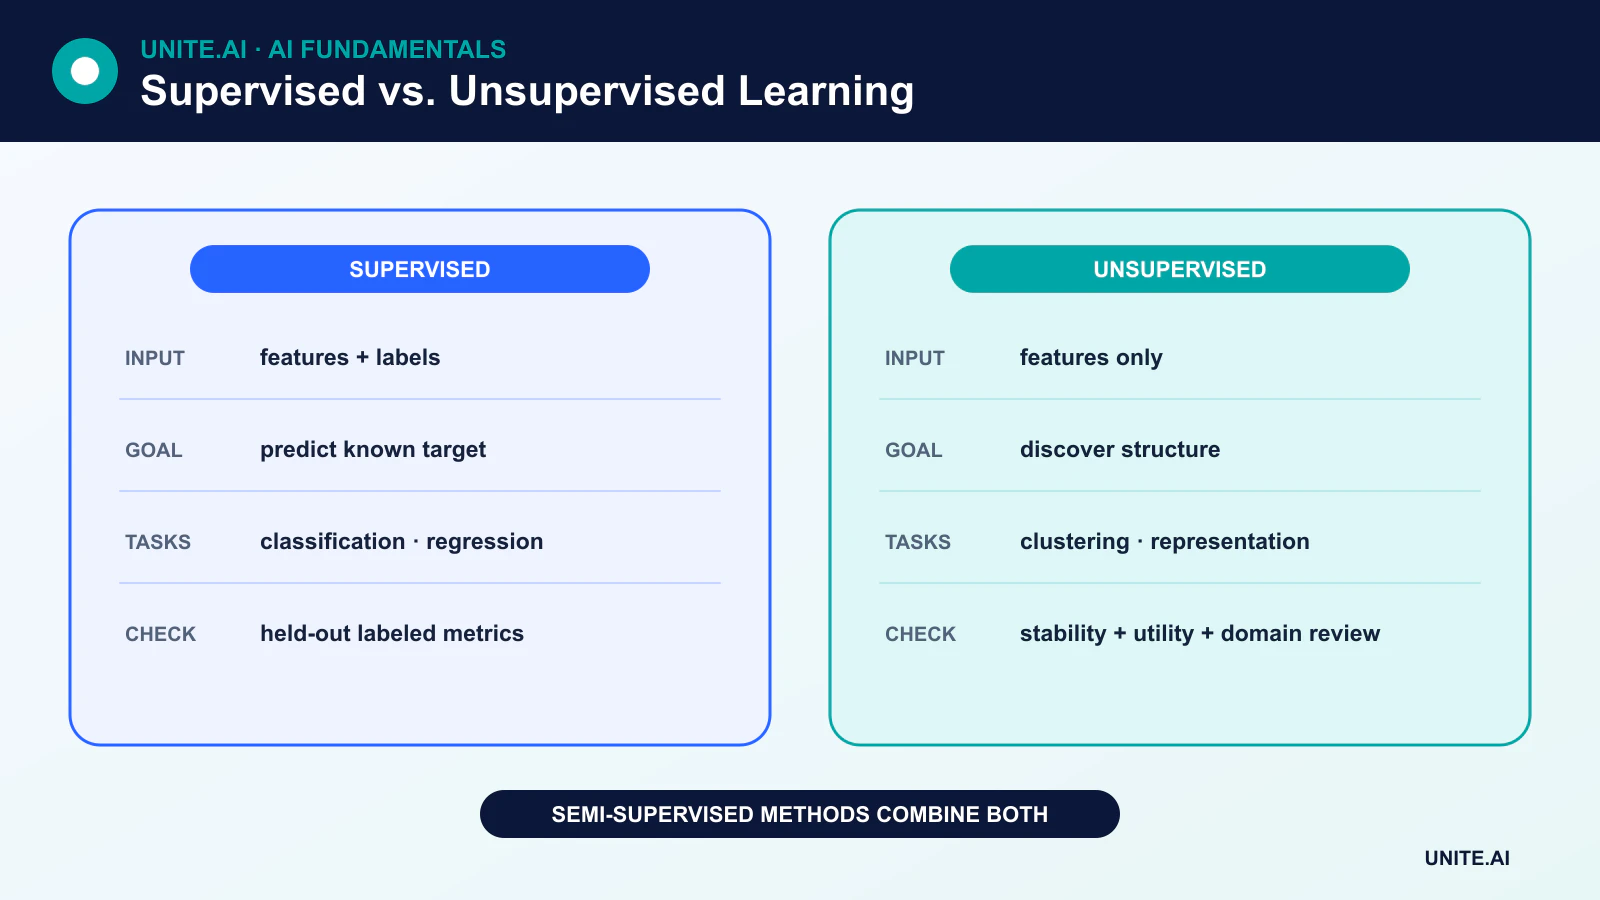
教師あり学習は、目標となる回答とペアになった例から学習します。教師なし学習は、目標ラベルなしでデータの構造を探ります。違いは、どちらの手法がより賢い・正確かということではなく、利用可能な学習シグナルの種類と、システムが解決しようとする課題にあります。
これらは機械学習の二大パラダイムですが、現代のシステムは半教師あり学習、自己教師あり学習、強化学習も活用しています。
主なポイント
- 教師あり学習は既知のターゲットを予測し、教師なし学習はパターンや表現を発見します。
- 分類と回帰は教師ありタスクであり、クラスタリング、密度推定、そして多くの次元削減手法は教師なしです。
- 教師なしの出力は自動的に実世界のクラスになるわけではなく、評価が難しいことがあります。
- 計算コストと精度はアルゴリズム、データ、タスク、評価方法に依存し、パラダイムだけで決まるわけではありません。
教師あり学習の仕組み
教師ありデータセットは特徴 X とターゲット y を含みます。トレーニングではモデルを調整し、予測がターゲットに近づくようにします。評価は、保持しておいたラベル付きサンプルを用いて、汎化性能を推定します。
分類
分類はカテゴリを予測します: スパムか非スパム、複数のうちの1つの文書トピック、または画像中の1つまたは複数のオブジェクトなどです。関連指標には適合率、再現率、F1、キャリブレーション、コスト感度指標があります。クラスが希少な場合、精度は誤解を招くことがあり、混同行列でどのクラスが混同されているかが分かります。
回帰
回帰は需要、期間、温度などの連続値を予測します。線形回帰は1つまたは多数の特徴を使用でき、2変数間の関係に限定されません。回帰の指標には平均絶対誤差、二乗平均平方根誤差、タスク固有のコストがあります。
代表的な教師ありアルゴリズム
教師あり手法には線形・ロジスティックモデル、決定木、ランダムフォレスト、勾配ブースティング、サポートベクターマシン、K近傍法、そしてニューラルネットワークが含まれます。
ロジスティック回帰はスコアまたは確率を出力し、選択した閾値でクラスに変換できます。決定木の葉は特徴空間の領域に基づく予測を保持し、必ずしも単一の学習サンプルに対応するわけではありません。K近傍法は近傍のラベル付き学習例から予測し、適切な学習/検証/テスト設計が依然として必要です。
教師なし学習の仕組み
教師なし学習はターゲット列なしで特徴を受け取ります。その目的は間接的に定義され、例えばクラスタ内距離の最小化、入力の再構成、データ密度の推定、あるいは少数の次元で可能な限り分散を保持することなどがあります。
クラスタリング
K-meansはポイントを指定した数のクラスタに割り当て、クラスタ中心を更新してクラスタ内二乗距離を減らします。このアルゴリズムは特定の距離と特徴表現の下で幾何学的なグループを発見しますが、これらのグループが自動的に意味のある顧客タイプ、診断、あるいは他のドメインラベルに対応するわけではありません。
次元削減
次元削減はデータをより少ない変数で表現します。主成分分析は線形射影下で可能な限り分散を保持する直交方向を見つけます。他の手法は異なる構造概念を保持し、全く異なる可視化を生成することがあります。
異常検知と密度推定
教師なし手法はデータが密集している領域を推定し、異常な観測をフラグ付けできます。異常スコアは詐欺、故障、悪意ある行動を証明するものではなく、選択された表現とモデルに基づく偏差を示すものです。
教師なし学習の評価方法
教師なしの「精度」には普遍的な概念はありません。実務者はシルエットスコアなどの内部指標を用いたり、サンプル間の安定性を比較したり、下流タスクでの有用性をテストしたり、ドメイン専門家に発見された構造が有意かどうかを問い合わせたりします。評価用の真のラベルが存在すれば、外部クラスタリング指標を使用してもトレーニングプロセスを教師あり学習に変える必要はありません。
二元比較を超えて
半教師あり学習
半教師あり学習は小規模なラベル付きデータと大規模なラベルなしデータを組み合わせます。擬似ラベリング、一貫性正則化、グラフベース手法が例です。ラベルなしデータは、支援できる程度にターゲット分布に近似している必要があります。
自己教師あり学習
自己教師あり学習は入力自体からターゲットを生成します。例えばマスクされたトークンの予測や変換されたビューのマッチングなどです。これは、トランスフォーマーを含む、現代の言語、ビジョン、マルチモーダルモデルの基盤となっています。
強化学習
強化学習は、相互作用で生成される報酬を通じて意思決定を最適化します。これはラベル付き予測や静的パターン探索とは異なります。
適切なアプローチの選び方
まず、システムが提供すべき決定や洞察から始めます。信頼できるターゲットが存在し、予測が目的であれば教師あり学習が自然です。目的が探索、表現、またはグルーピングであれば教師なし手法が適します。ラベルが不足している場合、自己教師ありまたは半教師ありの事前学習を行い、その後教師ありで評価する方が効果的です。
いずれの場合も、データリーク、バイアスのあるサンプリング、弱い代理指標、分布シフトがアルゴリズム選択を支配することがあります。目的が誤っているだけで、技術的に正しいモデルでも失敗する可能性があります。
学習シグナル、目的、代表的手法
教師あり学習は、ターゲットラベルまたは値とペアになった例を使用し、予測誤差を最小化します。分類、回帰、ランキング、構造化予測は出力と損失が異なります。教師なし学習は、クラスタリング、密度推定、次元削減、表現学習、生成モデルなどを通じて、ターゲットラベルなしで構造を探索します。自己教師あり学習はデータ自体から予測ターゲットを作り、半教師あり学習は小規模なラベル付きデータと大規模なラベルなしデータを組み合わせます。これらのカテゴリは学習シグナルを表し、同一のニューラルアーキテクチャが複数のパラダイムで訓練可能です。
ラベルは目的を明示しますが、アノテーションコスト、ノイズ、ポリシー上の前提、時間的遅延を伴います。ラベルなしデータは収集が容易ですが、どの発見された構造が有用かをアルゴリズムに示すことはできません。クラスタは意味のあるカテゴリではなく、照明条件、文書長、取得元などを反映することがあります。評価は独立して定義すべきです: 教師ありモデルは保持したラベル付き結果を使用し、教師なしモデルは安定性、再構成、尤度、検索、下流タスクでの有用性、または専門家による検証が必要です。視覚的な分離だけでは有効な構造の証明にはなりません。
パラダイム選択と一般的な誤りの防止
安定したターゲットと代表的なラベルが存在する場合は教師あり学習を使用します。要約、新規性検出、圧縮、仮説生成などの探索的目的では教師なし手法を用いますが、出力は暫定的に扱います。生データが豊富で下流タスクが表現を共有する場合、自己教師ありの事前学習は有用です。半教師あり手法は、ラベルなしデータとクラス構造に関する前提が成り立つ場合にのみ有効です。単純なベースラインと比較し、収集・ラベリング・レビュー・計算・エラーの総コストを考慮すべきで、ラベルなしが自動的に低コストであると仮定しないでください。
リークを防ぐために、ラベルや拡張、擬似ラベルを作成する前に関連エンティティを分離します。クラスバランス、アノテーションの合意、クラスタの安定性、崩壊、ドリフトを監視します。擬似ラベルは初期の誤りを強化する可能性があり、クラスタリングはセンシティブな属性を符号化することがあります。事前学習された表現は元データのバイアスを転送することがあります。人間のレビューは境界ケースとその影響に焦点を当てるべきです。実運用では、学習シグナルの作成方法と陳腐化時期を文書化します。パラダイムは監督がシステムにどこで入るかを決定し、人間の選択や価値観の有無を決めるものではありません。
実例:サポートトピックの発見とラベリング
ある企業は、まず匿名化されたサポートメッセージに対して教師なしの埋め込みとクラスタリングを用いてテーマを探索します。アナリストは代表的な例と境界例を検査し、いくつかのクラスタが問題ではなくメッセージの長さやチャネルを反映していることを発見します。次に、未知クラス、アノテーションガイダンス、合意度測定を含む教師ありの分類体系を構築します。その分類器は、キーワードや近傍ベースラインと比較して、後続の期間、言語、製品で評価されます。
ラベルなしの新規メッセージはドリフトの検出を支援しますが、分類器を自動的に再訓練はしません。レビュアはアクティブラーニングを通じて不確実かつ新興のケースを選択的にラベル付けし、品質チェックと封印された評価セットを設けます。モニタリングはトピックの出現頻度、信頼度、意見の不一致、ルーティング結果を追跡します。新製品がリリースされる際は、分類体系と下流チームのキャパシティを同時に更新します。このワークフローは、仮説生成に教師なし手法を、運用上のルーティングに教師ありエビデンスを利用します。
実装の根拠と運用準備
本番導入の判断は、成功したデモだけでは不十分です。対象ユーザー、運用環境、入力・出力、依存関係、所有者、重要な障害ごとの影響を定義します。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立します。通常ケース、境界条件、破損または欠損入力、分布シフト、依存障害、誤用、そしてサービスが不足しやすいグループや環境をテストします。タスク品質をキャリブレーションや不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティと共に測定します。すべての変換と閾値を記録し、独立したレビューアが結果を再現でき、魅力的なプロトタイプと証拠を区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止に関する権限を割り当てます。段階的ロールアウトを実施し、安全なフォールバックを保持し、意図的に注入した障害でモニタリングを検証します。運用テレメトリは、入力品質、出力挙動、モデルまたはルールのバージョン、依存の健全性、人間のオーバーライド、確認された結果を示すべきで、不要な機微データは収集しません。アラート閾値と対応責任者を定義し、デプロイ後に実世界のエビデンスをレビューします。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目的が変わるたびに再評価します。維持されたシステムは、復旧手順、インシデントからの学習、削除・保持手順、そして無効化または置換すべき明確なタイミングを文書化する必要があります。
主要参考文献












