
AIの基礎
KNN(K-Nearest Neighbors)とは何か?

 Unite.AI を Google の優先ソースに追加
K最近傍法(KNN)は、クエリ点に最も近いラベル付きトレーニング例から結果を予測します。分類の場合、近傍がクラスに投票します。回帰の場合、対象値の平均やその他の方法で結合されます。
KNNはインスタンスベースの、一般化しない手法です: 主にトレーニング例とオプションの検索インデックスを保存します。これにより、トレーニング、検証、テストの分割が不要になるわけではありません。保持データでの評価は、k、距離指標、特徴処理、投票ルールを選択する際に不可欠です。
重要なポイント
- KNNはローカルに予測を行い、データセットを最初にクラスタに分割しません。
- 距離がどの例を近傍とみなすかを決めるため、特徴量のスケーリングは重要です。
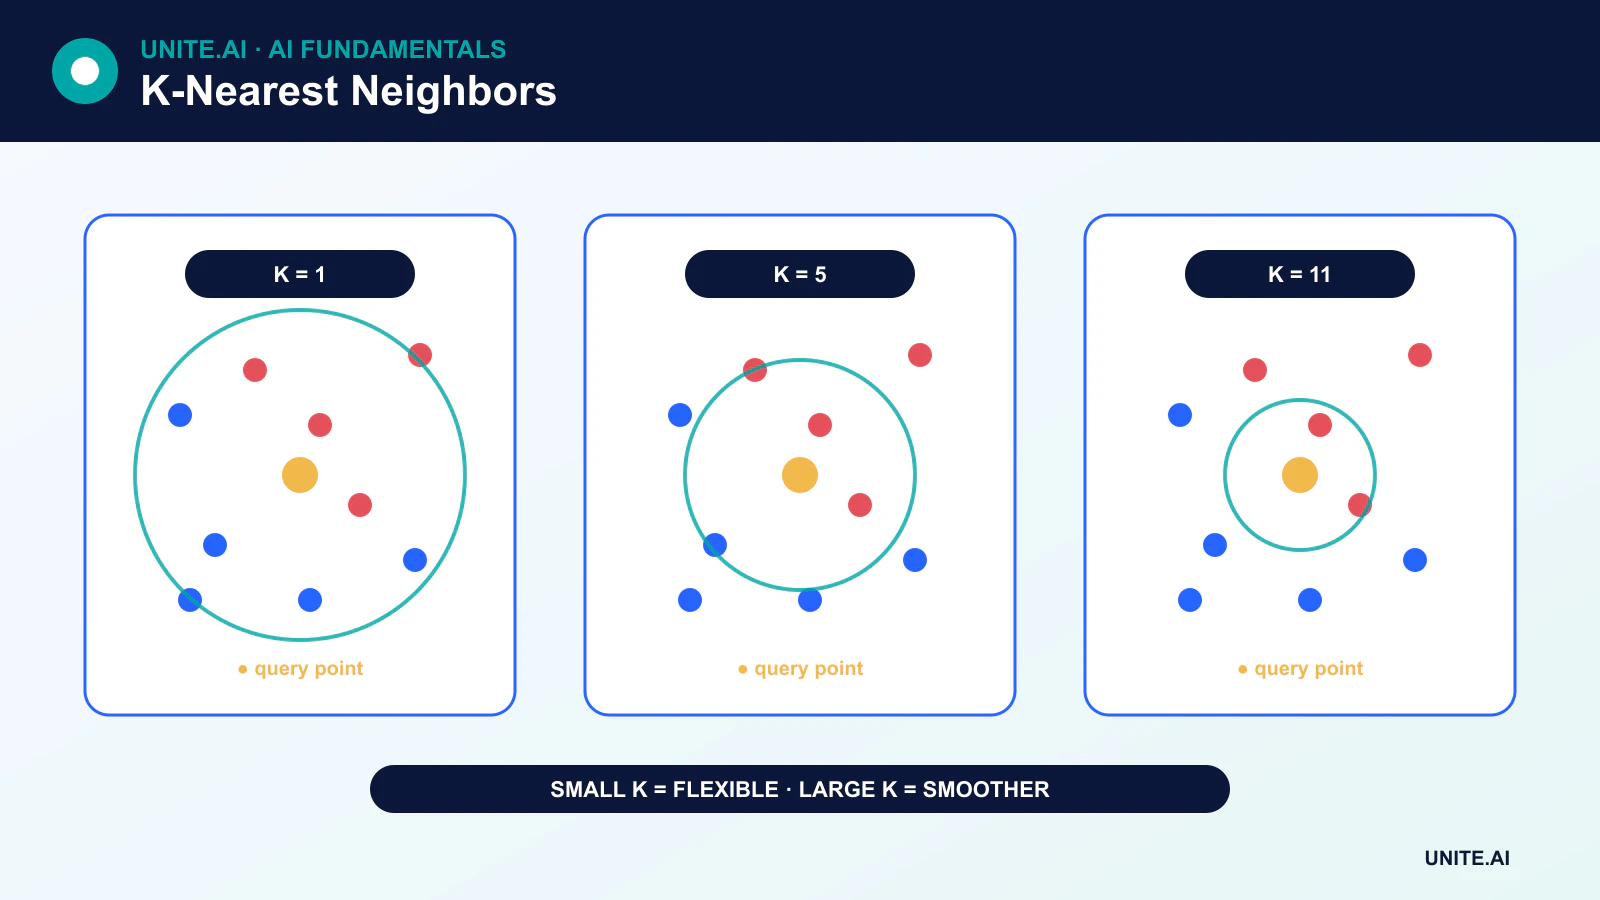
- 小さなkはノイズが多くなりやすく、大きなkは局所構造を平滑化しすぎる可能性があります。
- 高次元、無関係な特徴、クラス不均衡、検索速度の遅さが性能を制限することがあります。
KNN分類の仕組み
- クエリとトレーニング例を同じ特徴空間で表現します。
- クエリからトレーニング例への距離を計算します。
- 最も近いk例を選択します。
- 多数派クラスを予測するか、距離重み付き投票を使用します。
距離重み付き投票は、より近い近傍に大きな影響力を与えます。同点の場合は文書化されたルールが必要で、距離が等しいがラベルが異なる近傍は、順序や実装の詳細に結果が依存することがあります。
KNN回帰
回帰の場合、予測は一般に近傍のターゲットの平均です。距離重み付けにより、遠くの観測の影響を減らすことができます。局所ターゲットに外れ値が含まれる場合、中央値やロバストな集約が有用です。
距離指標
連続特徴にはユークリッド距離が一般的で、マンハッタン距離は絶対差の合計、コサイン距離は大きさではなく方向に注目します。その他の指標は二値、カテゴリ、地理、シーケンス、または学習された埋め込みデータに適用されます。
KNNを「非パラメトリック」と呼ぶのは、決定境界に固定された有限次元の関数形を仮定しないことを意味します。それでも、選択された表現と指標が近接点同士を関連付けることを前提としています。
スケーリングが重要な理由
ある特徴が0〜1の範囲で、別の特徴が0〜100,000の範囲の場合、通常のユークリッド距離は後者に支配されます。標準化、正規化、またはドメイン固有の変換はトレーニング分割で適合させ、検証、テスト、実運用データに適用すべきです。
無関係な特徴も近傍を歪めます。特徴選択、次元削減、または学習された表現が役立ちますが、各選択はデータリークなしで検証しなければなりません。
k の選択
k = 1 の場合、モデルはノイズや誤ラベル例に追随しやすくなります。k が大きくなるにつれて、予測は滑らかになり、単一の点に対する感度が低くなります。k が過度に大きくなると、遠くのクラスや領域が支配的になり、モデルは過小適合します。
トレーニングデータで交差検証を行い、k を選択します。二値分類では、奇数のk が同点を減らしますが、完全に排除はできません。クラスが不均衡な場合、クラス重み、層化分割、閾値の選択、適切な指標が重要です。
次元の呪い
高次元空間では、サンプルが疎になるため距離の情報量が低下し、最近傍と最遠距離が相対的に似通ってきます。意味のある局所近傍を保つには膨大なデータが必要になることがあります。これが次元の呪いです。
次元削減やタスク固有の埋め込みが役立ちますが、埋め込みの幾何学は目的とする類似性の概念に対して検証すべきです。
検索性能
ブルートフォース検索は新しい点をすべての保存例と比較します。KD ツリーやボールツリーは一部の正確検索を高速化しますが、次元が高くなると効果は減少します。近似最近傍インデックスは、わずかなリコールの低下と引き換えに大幅な速度とメモリの向上を提供します。この考え方はベクトル類似検索の基盤でもあります。
強みと制限
KNNはシンプルで、不規則な決定境界をサポートし、直感的な例ベースの説明を提供します。一方で、膨大なメモリを必要とし、機密性の高いトレーニング例が露出したり、予測が遅くなったり、距離が意味を持たない場合に性能が低下したりします。これは有用なベースラインであり、デフォルトでほとんどの問題で高精度というわけではありません。
距離、近傍、ハイパーパラメータの挙動
K最近傍法はトレーニング例を保存し、選択された距離下で最も近い k 個から予測します。分類では多数決または距離重み付き投票を使用し、回帰では近傍のターゲットを平均します。スケーリングは重要で、範囲の大きい特徴がユークリッド距離を支配する可能性があります。カテゴリ、スパース、シーケンス、地理データはハミング距離、コサイン距離、編集距離、球面距離、または学習距離が必要になることがあります。指標は類似性に関するモデリング仮定であり、実際の近接ケースの意味に対して検証すべきです。
小さな k は柔軟で高分散な境界とノイズへの感度を生み出し、大きな k は予測を平滑化し、少数派の構造を消すことがあります。奇数の k は二値の同点をいくつか回避しますが、一般的な規則ではありません。k、距離、重み付け、特徴セット、前処理は交差検証内で選択します。クラス不均衡は局所多数決が稀な結果を無視する原因となるため、クラス別リコールと近傍構成を確認してください。高次元では距離が集中しやすく、無関係な特徴が近傍を劣化させます。特徴選択、次元削減、学習埋め込みが有効です。
インデックス、不確実性、運用上の考慮事項
単純な推論はクエリをすべてのトレーニング点と比較します。KD ツリーやボールツリーは低次元で有効で、近似最近傍インデックスは正確性と引き換えに速度とスケールを向上させます。近傍検索のリコールは予測品質とは別に測定します。メモリは保存された特徴、ラベル、インデックス構造を含みます。更新は概念的には簡単ですが、インデックスの再構築、バージョン整合性、削除の伝搬が必要になることがあります。近傍や距離を返すことで機密トレーニング例が露出する可能性があるため、保護が必要です。
KNNは予測を理解しやすくする例を提示できますが、近さが因果関係や公平性を意味するわけではありません。近傍が希薄または矛盾する場合は、距離、投票マージン、棄権ルールを提供してください。クエリ距離、近傍ラベル、特徴ドリフト、レイテンシ、確定結果を監視します。前処理とインデックスのバージョンを同期させ、変更後に正確検索と近似検索の結果をテストしてください。距離が意味を持つ場合、KNNは有効なローカルベースラインおよび検索手法ですが、利用可能な特徴で類似性を表現できない場合は苦戦します。
実例:製品代替のためのKNN
小売業者は製品を標準化された数値属性、カテゴリ互換性、学習されたテキスト埋め込みで表現し、マーチャンダイザーがレビューする重み付き距離を定義します。K と重みはランダムなアイテム行ではなく、後続の製品リリースを用いて選択します。評価は関連する代替品のリコール、非互換推奨、距離、カテゴリカバレッジ、稀少アイテムの結果を確認します。人気ベースラインは局所的な類似性が価値を加えるかどうかを示します。
近似インデックスは正確な近傍と比較してリコールとレイテンシをベンチマークします。近い互換アイテムがないクエリは、強制的に近傍を返すのではなく、提案なしとします。製品削除や属性修正はバージョン管理された更新を通じてインデックスに反映されます。モニタリングは距離分布、空結果、上書き、商業的結果を追跡し、売上と実際の互換性を混同しません。機密性の高いサプライヤー条件は説明から除外され、返される例は類似性の証拠であり、製品が等価であるという主張ではありません。
実装の証拠と運用上の準備状況
本番環境での導入は、成功したデモだけでは不十分です。想定ユーザー、運用環境、入力、出力、依存関係、所有者、重要な障害ごとの影響を定義します。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立します。通常ケース、境界条件、形式不正や欠損入力、分布シフト、依存障害、誤用、サービスが行き届きにくいグループや環境をテストします。タスク品質を較正や不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティと共に測定します。すべての変換と閾値を記録し、独立したレビュアーが結果を再現し、魅力的なプロトタイプと証拠を区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止の権限を割り当てます。段階的ロールアウトを使用し、安全なフォールバックを保持し、意図的に障害を注入してモニタリングを検証します。運用テレメトリは、入力品質、出力挙動、モデルまたはルールのバージョン、依存状態、人間の上書き、確定結果を示すべきで、不要な機密データは収集しません。アラート閾値と対応責任者を定義し、デプロイ後に実世界の証拠をレビューし、オフライン性能が持続すると仮定しないでください。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目的が変わるたびに再評価します。維持されたシステムは、文書化された復旧手順、インシデント学習、削除・保持手順、そして無効化または置換すべき明確なタイミングも必要です。
よくある質問
KNNにはトレーニングフェーズがありますか?
パラメータのフィッティングはほとんどありませんが、開発プロセスはあります: 前処理はトレーニングデータから学習され、インデックスが構築されることがあり、k、指標、重み、特徴は検証で選択されます。
KNNはK-meansと同じですか?
いいえ。KNNは主に教師ありのローカル予測手法です。K-meansは、K がクラスタ中心の数である教師なしクラスタリングアルゴリズムです。
主要参考文献












