
AIの基礎
ディープラーニングとは何か?

 Unite.AI を Google の優先ソースに追加
ディープラーニングは、複数の処理層を持つニューラルネットワークを利用してデータの有用な表現を学習する機械学習手法のファミリーです。これらのモデルは、言語、画像、音声、レコメンデーション、科学的予測、生成AIなど、多くの最新システムを支えています。
「deep(深い)」という語は、入力と出力の間の変換回数を指すもので、機械がより深い理解を持つことを意味するわけではありません。ディープモデルは、訓練目的に有用な数値関係を学習しますが、その性能は新しいデータでテストする必要があります。
要点
- ディープラーニングは機械学習のサブセットです。
- 層は、学習されたパラメータ、非線形活性化、正規化、その他の操作を用いてテンソルを変換します。
- 逆伝播は勾配を計算し、オプティマイザはその勾配を用いて重みやバイアスなどの学習可能パラメータを更新します。
- CNN、リカレントネットワーク、トランスフォーマー、オートエンコーダ、拡散モデルはそれぞれ異なる構造と強みを持ちます。
ディープニューラルネットワークの学習方法
ニューラルネットワークはデータをテンソル(数値の多次元配列)として受け取ります。画像テンソルはピクセルチャネルをエンコードし、言語モデルはトークンを表すベクトルを使用します。各層は微分可能な変換を行い、その結果を次の層へ渡します。
基本的な全結合層では、モデルは入力の重み付き和を計算し、学習可能なバイアスを加え、そして活性化関数を適用します:
output = activation(Wx + b)
活性化関数は非線形性を導入します。これがなければ、普通の線形層を積み重ねても線形変換しか表現できません。ReLU とその変種は隠れ層で一般的に使用され、出力の活性化はタスクに依存します。
訓練は通常、以下の4つのステップで行われます:
- 順方向伝播で予測を生成します。
- 損失関数は予測と目的との違いを測定します。
- 逆伝播は連鎖律を適用して、損失に対する各学習可能パラメータの勾配を計算します。
- 確率的勾配降下法やAdamWなどのオプティマイザがパラメータを更新します。
これらのステップを多数のバッチにわたって繰り返すことでモデルは改善されますが、訓練時の損失が低いからといって実世界での信頼性が保証されるわけではありません。検証、正則化、代表的なデータ、モニタリングは依然として重要です。
主要なディープラーニングアーキテクチャ
多層パーセプトロン
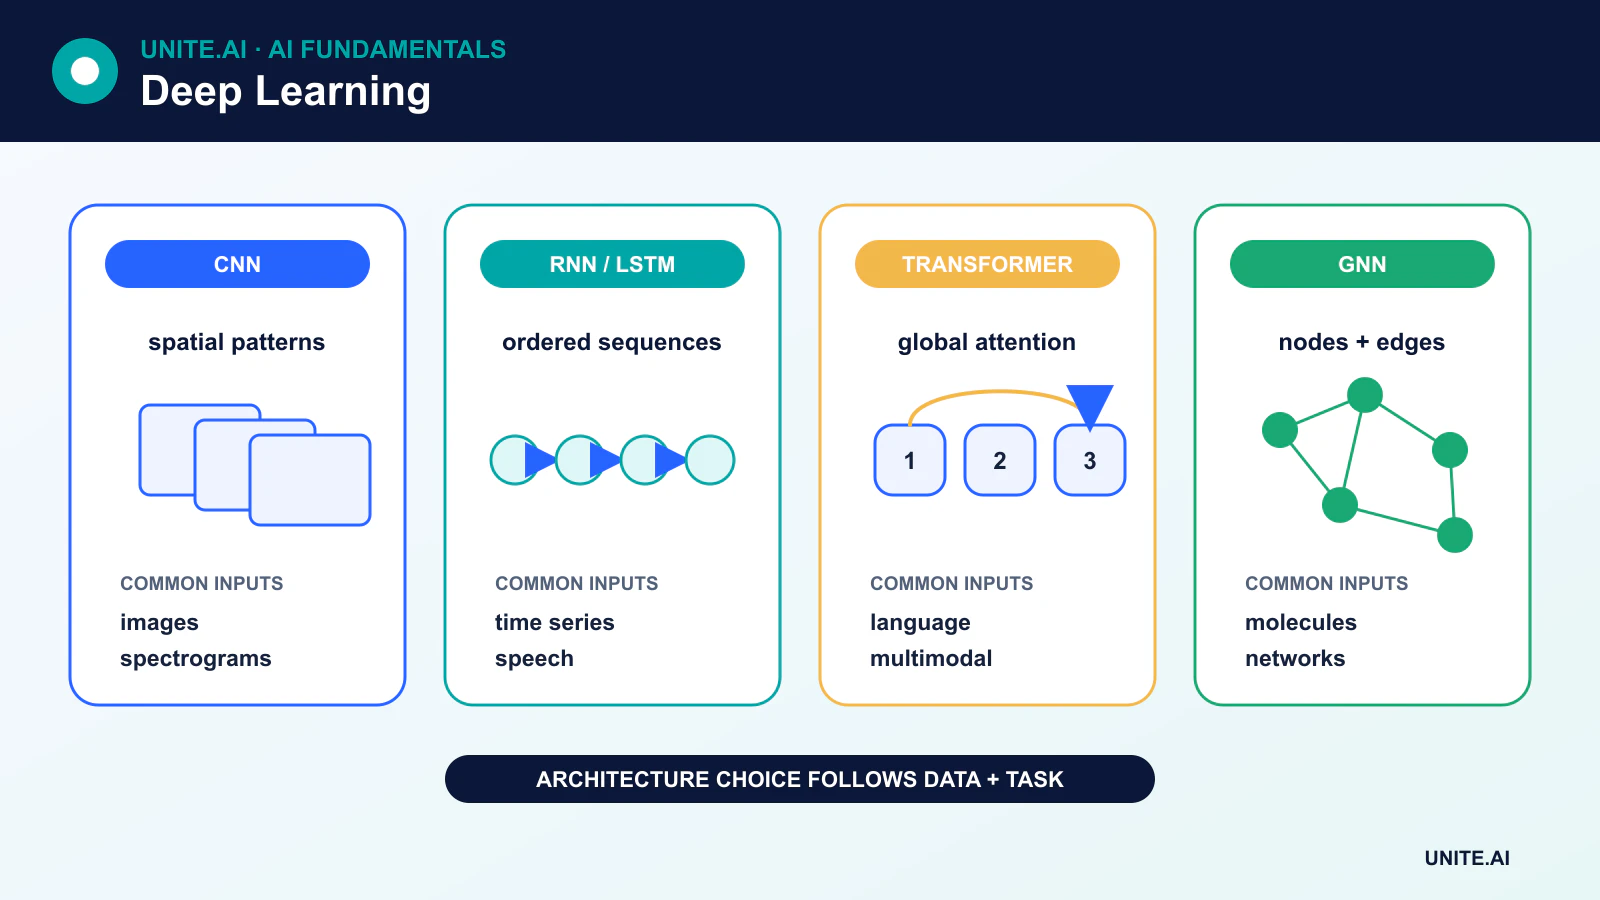
多層パーセプトロン(MLP)は、前層のすべての入力に依存する全結合層を使用します。MLPは表形式の特徴や大規模システムの構成要素として有用ですが、画像の局所性やシーケンス順序に関する前提は組み込んでいません。
畳み込みニューラルネットワーク
畳み込みニューラルネットワーク(CNN)は、学習されたフィルタを局所領域に適用します。重み共有により、画像やスペクトログラムといった格子構造に対して効率的です。CNNは視覚タスクやエッジデプロイメントで依然として重要ですが、ビジョントランスフォーマーやハイブリッドモデルも広く利用されています。
リカレントネットワーク、LSTM、GRU
リカレントニューラルネットワーク(RNN)は、シーケンスが処理される間に隠れ状態を更新します。LSTM とゲート付きリカレントユニット(GRU)は情報を保持し、基本的なRNNが長い依存関係で苦労する勾配消失問題を軽減します。すべての長文コンテキストの制限を排除するわけではありませんが、ストリーミング信号、時系列データ、コンパクトなシーケンシャルモデルに有用です。
トランスフォーマー
トランスフォーマーは、注意機構を用いてシーケンスや集合の要素間の関係をモデル化します。多数の位置を並列に処理できる能力により、ほとんどの大規模言語システムでリカレントを置き換え、現在では画像、音声、動画、タンパク質、マルチモーダルデータも処理できるトランスフォーマーの変種が存在します。
オートエンコーダと生成モデル
オートエンコーダは入力を表現に圧縮し、そこから入力を再構築します。これにより自己教師ありの再構築目的が生まれますが、ラベルなしデータを自動的にラベル付きサンプルに変換するわけではありません。
敵対的生成ネットワーク(GAN)は、生成器と識別器を競合させて学習します。拡散モデルは、徐々にノイズを加える過程を逆に学習します。自己回帰型トランスフォーマーは、トークンやユニットを一度に一つずつ生成します。これらの手法は、訓練のダイナミクス、制御性、計算要件がそれぞれ異なります。
なぜ深さが有効で、なぜアーキテクチャが重要か
複数の層により、モデルは単純な変換を組み合わせてより複雑な変換を構成できます。視覚領域では、学習された特徴が局所的なテクスチャからタスク固有のパターンへと進化することがあります。言語領域では、注意層が文脈依存のトークン表現を構築します。これらの記述は有用な直感であり、各層が必ず学習すべき固定的なルールではありません。
最新のネットワークは、残差接続、正規化、慎重な初期化、正則化、最適化されたハードウェアにも依存しています。単に層やパラメータを増やすだけでは、モデルの訓練が困難になったり、速度が遅くなったり、過学習しやすくなります。モデル規模の拡大は、データ、目的、最適化、デプロイ環境がそれを支える場合にのみ有効です。
訓練と推論の違い
訓練はパラメータを調整し、通常は計算コストが高い段階です。推論は訓練済みモデルを実行して出力を生成します。大規模モデルでは推論も依然として高コストになるため、チームは量子化、蒸留、バッチ処理、キャッシュ、スパース化、そしてニューラルプロセッシングユニット(NPU)などの専用ハードウェアを利用します。
制限と責任ある利用
ディープモデルはバイアスを引き継いだり、機密情報を記憶したり、分布シフト下で失敗したり、説得力のあるが誤った出力を生成したりする可能性があります。また、解釈が難しく、訓練コストも高くなります。評価はベンチマークの平均値だけでなく、クラスやサブグループレベルの性能、ロバスト性、キャリブレーション、セキュリティ、レイテンシ、エネルギー使用、失敗の影響などを網羅すべきです。
表現、最適化、アーキテクチャの選択
ディープネットワークは、パラメータ化された層を通じて連続的な表現を学習します。線形変換は入力を混合し、非線形活性化はネットワークが複雑な関数を近似できるようにします。正規化と残差接続は最適化を支援し、注意、畳み込み、リカレント、または状態空間演算は異なる構造的前提を符号化します。深さは変換回数を増やすもので、必ずしも知能を保証するわけではありません。アーキテクチャはタスクのモダリティ、データ量、レイテンシ、メモリ、そして不変性を反映すべきです。データが限られ、局所的な空間構造が支配的な場合、より小さな畳み込みモデルがトランスフォーマーよりも優れることがあります。
訓練では損失を計算し、逆伝播で微分し、確率的勾配降下法やAdamなどのオプティマイザでパラメータを更新します。バッチサイズ、学習率、スケジュール、初期化、正則化、数値精度は相互に影響します。訓練および検証損失の曲線は、アンダーフィッティング、オーバーフィッティング、不安定性、情報漏れを区別するのに役立ちますが、実世界での有用性を保証するものではありません。独立した評価データ、分散が重要な複数回の実行、アブレーション、シンプルなベースラインとの比較を使用してください。大量のパラメータはデータガバナンス、計算計画、再現可能な設定の必要性も高めます。
ディープモデルの安全かつ効率的な提供
デプロイは、ホスト型エンドポイント、専用アクセラレータ、ブラウザ、スマートフォン、組み込みデバイスなどを利用できます。エクスポートやコンパイルにより演算子が融合されたり、重みや活性化が量子化されたり、数値挙動が変化したりするため、訓練チェックポイントだけでなく、デプロイされた成果物を検証する必要があります。コールドスタート、安定レイテンシ、スループット、メモリ、電力、品質を、現実的なバッチサイズとシーケンス長で測定します。圧縮手法(プルーニング、蒸留、量子化、低ランク適応)は、サイズや速度と精度・エンジニアリングの複雑さをトレードオフし、機密クラスやエッジケースで評価しなければなりません。
ディープモデルは、分布シフト、敵対的入力、偽相関、十分に表現されていないグループに対して自信を持って失敗することがあります。入力・出力の分布、タスク結果、キャリブレーション、リソース使用、依存バージョンを監視します。アクセス制御、署名済みアーティファクト、保護された訓練データ、レッドチーミング、脅威モデルに適したレートリミットを使用してください。サリエンシーマップや注意マップといった説明は診断的証拠であり、因果関係の証明ではありません。これらを行動テスト、反事実、人的レビュー、インシデント対応、自動決定への明示的制限と組み合わせます。
実例:画像欠陥検出器の訓練
工場はカメラ、シフト、素材、既知の欠陥クラスごとに製品画像を収集し、生産バッチ単位で分割して近似重複品がパーティションを跨がないようにします。小規模な畳み込みベースラインと事前学習済みディープネットワークを比較します。データ拡張は、欠陥を消さずに検証済みの照明や視点の変化を再現します。評価は欠陥ごとのリコール、偽拒否率、キャリブレーション、推論レイテンシ、ぼやけ、グレア、カメラ交換、希少な素材色に対するロバスト性を報告します。
エクスポートされたモデルと正確なリサイズ、カラー、正規化コードは、ライン上のハードウェアで持続的なスループットと熱挙動をテストします。信頼度が低いケースは検査員に回され、独立したルールが安全クリティカルなセンサー障害時にラインを停止させます。画像は許可された範囲でのみ保持され、モデルアーティファクトは署名されます。モニタリングは予測と後続の検査結果や生産ロットを結び付けます。新しいカメラや素材が導入された場合、未レビューのラベルからの無音オンライン学習ではなく、制御された再評価がトリガーされます。
実装証拠と運用準備性
本番導入の判断は、成功したデモだけでは不十分です。想定ユーザー、運用環境、入力・出力、依存関係、所有者、重要な障害ごとの影響を定義します。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立します。通常ケース、境界条件、形式が不正または欠損した入力、分布シフト、依存障害、誤用、そしてサービスが行き届きにくいグループや環境をテストします。タスク品質をキャリブレーションや不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティと共に測定します。すべての変換と閾値を記録し、独立したレビューアが結果を再現でき、魅力的なプロトタイプと証拠を区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止の権限を割り当てます。段階的ロールアウトを使用し、安全なフォールバックを保持し、意図的に注入した障害でモニタリングを検証します。運用テレメトリは、不要な機密データを収集せずに、入力品質、出力挙動、モデルまたはルールのバージョン、依存の健全性、人間のオーバーライド、確定した結果を明らかにすべきです。アラート閾値と対応責任者を定義し、デプロイ後に実世界の証拠をレビューし、オフライン性能が継続すると仮定しないでください。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目的が変わるたびに再評価します。維持されたシステムは、文書化された復旧手順、インシデント学習、削除・保持手順、そして無効化または置換すべき明確なタイミングも必要です。
主要参考文献












