AIの基礎
Few-Shot学習とは何か?

 Unite.AI を Google の優先ソースに追加
Few-shot learningは、モデルが少数のラベル付き例だけで新しいタスクやクラスに適応できる方法を研究します。従来のベンチマークでは、エピソードがサポートセット(例:5クラスで各クラスあたり1または5例)を提供し、モデルに未見のクエリを分類させます。
この用語は、パラメータを更新せずにプロンプト内に少数のデモンストレーションを与えるインコンテキスト学習にも使われます。これらの設定は少数例での目標を共有しますが、適応メカニズムが異なり、評価設計も異なります。
主なポイント
- N-way K-shotは、Nクラスと各クラスあたりK個のラベル付きサポート例を表します。
- メトリック学習手法は、クエリとサポート例の学習された表現を比較します。
- メタラーニングは多数のタスクにわたって最適化し、新しいタスクを迅速に学習できるようにします。
- 少数の例はラベルエラー、情報漏洩、クラスの曖昧さや不確実性を増幅するため、ベースラインと信頼度の報告が重要です。
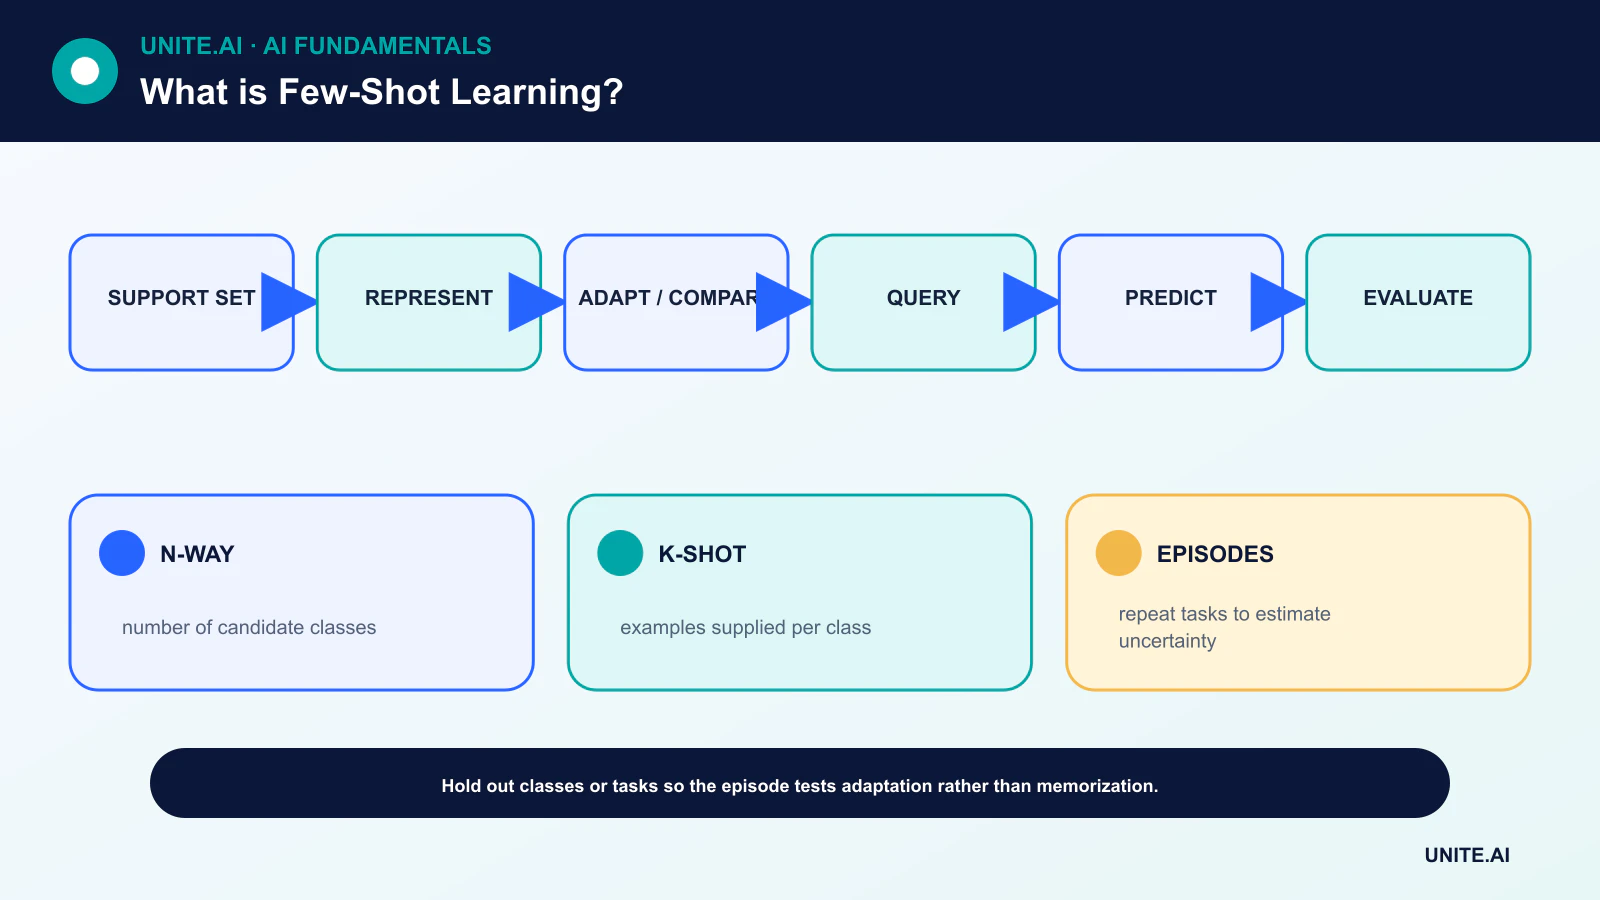
エピソード、サポートセット、クエリセット
Few-shotエピソードは、評価に使用されるクエリセットから小さなラベル付きサポートセットを分離します。メタトレーニング中、モデルは多数のエピソードを経験します。堅牢な評価は、全クラス、タスク、またはドメインを保持し、テストエピソードが記憶ではなく適応を測定するようにします。
1つのサンプルだけでなく、多数のエピソードにわたる精度分布を報告してください。シンプルな最近傍法や線形ベースラインと比較します。高度な手法でも、十分に訓練された表現と基本的な分類器に勝てなければ、その複雑さは正当化できません。
メトリック学習とプロトタイプ
Matching Networksや関連手法は、サポート例とクエリ例をベクトル空間に埋め込み、近接するベクトルは同じラベルを持つべきとします。Prototypical Networksは各クラスのサポート埋め込みを平均し、そのクラスプロトタイプからの距離に基づいてクエリを分類します。
これにより、Few-shot学習は表現の質と結びつきます。事前学習済みのdeep-learningモデルは既に関連特徴をうまく整理している可能性がありますが、表現が合わないとすべての距離が誤解を招くことがあります。
最適化ベースのメタラーニング
Model-Agnostic Meta-Learning(MAML)は、少数の勾配ステップで適応できるパラメータを探索します。他の手法はオプティマイザ、初期化、またはパラメータ更新ルールを学習します。外部ループはタスク間で適応後の性能を評価します。
メタラーニングは、トレーニングタスクとターゲットタスク間で有用な構造が共有されていると仮定します。ターゲット分布が大きく異なる場合、迅速な適応は失敗する可能性があります。検証では、ショット数、クラス、ドメイン、タスク難易度を変化させ、単一のベンチマークを普遍的とみなさないようにすべきです。
転移学習とデータレベルの戦略
Transfer learningはしばしば最も実用的な出発点です: 事前学習済みエンコーダを凍結し、小さなヘッドを訓練し、十分なデータがあれば選択的にファインチューニングします。データ拡張は不変性を導入できますが、非現実的な合成例はバイアスを増幅したりショートカットを作り出す可能性があります。
アクティブラーニングはラベル付けすべき例を優先順位付けでき、半教師あり学習は追加の未ラベルデータを利用できます。これらは相補的な戦略であり、Few-shot学習の同義語ではありません。
Few-shotプロンプトは異なる
A transformerは、コンテキストに配置されたデモンストレーションからパターンを推測できます。永続的なパラメータ更新は不要です。順序、表現、ラベルのバランスは出力に大きく影響し、例はコンテキストウィンドウの大部分を占めることがあります。
代表的な評価セットを使用し、すべてのプロンプトとデモンストレーションをバージョン管理し、ゼロショット、Few-shot、ファインチューニングの代替手法をテストしてください。ごく小さなサポートセットでは、特に稀少ケースや安全性が重要なケースに対して、全体的な主張を裏付けることはできません。
Few-shot学習のパラダイムとタスク構築
Few-shot学習は、極少数のラベル付き例からタスクを実行することを目指します。メトリックベースの手法では、エンコーダが例を空間にマッピングし、最近傍のプロトタイプや近傍がクラスを表します。最適化ベースのメタラーニングは、迅速な適応のために初期化または更新ルールを学習します。転移学習は、事前学習済みモデルを小さなターゲットセットでファインチューニングします。インコンテキスト学習は、重みを更新せずにプロンプト内に例を提供します。これらのメカニズムは異なるため、主張ではパラメータが変化するか、事前学習の有無、例の選択方法を明示すべきです。
評価は、主張された汎化性に従って、トレーニングとテストのクラス、タスク、対象、またはドメインを分離すべきです。N-way K-shotエピソードはNクラスと各クラスあたりK個のサポート例、さらにスコアリング用のクエリ例を含みます。繰り返しエピソードでサポート選択の分散を推定します。プロンプトの場合、例の順序、ラベル表現、フォーマット、デモンストレーションの類似性が結果に大きく影響します。同一の表現とデータ予算で、ゼロショット、最近傍、線形プローブ、通常のファインチューニングベースラインと比較してください。
データ品質、不確実性、負の転移
少数の例では、誤ラベルや異常ケースが過大な影響を与えます。アノテーションルールを定義し、各サポート項目を検査し、未知または棄権の結果を保持してください。データ拡張や合成例は、タスクを保持し現実的なバリエーションを加える場合にのみ有効です。事前学習モデルはソースドメインからショートカットやバイアスを転送することがあります。ドメイン外ケース、稀少グループ、サポート例を1つ除外した際の感度をテストします。タスクやランダムシードを跨いだ信頼区間を報告し、好都合なプロンプトだけを示さないでください。
アクティブラーニングは情報価値の高いケースにラベルを要求でき、半教師あり手法は追加の前提の下で未ラベルデータを利用します。リトリーバルは関連デモンストレーションを動的に選択できますが、テストラベルの漏洩を防ぐ必要があります。適応は急速に過学習しやすいため、更新を制限し、正則化を用い、別の例で検証してください。高リスクタスクでは、少数のラベルだけで自律的な判断を正当化することは稀です。十分な結果証拠が得られるまで、モデルを優先順位付けやレビュー支援に活用してください。
本番運用
ベースモデル、埋め込みまたはプロンプトテンプレート、デモンストレーション、ラベルスキーマ、適応パラメータをバージョン管理します。プロンプトや勾配が機密情報を露出する可能性があるため、例を保護してください。クラスや言語が変化するにつれて性能を監視し、自動自己ラベリングではなく、統制されたレビューを通じてサポート例を更新します。Few-shot学習は、事前構造を活用してラベル付きターゲットの必要量を削減しますが、代表的な評価や慎重なタスク定義、ドメイン専門知識、または新タスクが既存の前提外にある場合の安全なフォールバックの必要性を排除するものではありません。
実例:新製品のFew-shot分類
サポートチームは、各問題につき5つのレビュー済み例しかない製品のルーティングラベルが必要です。事前学習済み埋め込みにおける最近傍プロトタイプ、線形ヘッド、パラメータ効率的ファインチューニング、インコンテキストプロンプトを比較します。製品ファミリー、顧客、後続メッセージはメタトレーニングやモデル選択から除外されます。サポートセットを繰り返しサンプリングし、クラスリコール、キャリブレーション、分散、1つの誤ラベルデモへの感度を報告します。
信頼度が低い、またはサポートされていないメッセージは一般サポートへ振り分けられ、レビュー担当者が統制されたキューでラベルを修正します。例は匿名化され、バージョン管理され、最終テストセットからは決して選択されません。モニタリングは新語彙、クラス比率、修正、意見の不一致を追跡します。十分なラベルが蓄積したら、Few-shotシステムを従来の教師あり学習と比較します。迅速なセットアップは有用ですが、性能が不安定なまま、または新製品が従来のタスクファミリーと大きく異なる場合は自動化を正当化できません。
実装証拠と運用準備
本番での導入判断は、成功したデモだけでは不十分です。対象ユーザー、運用環境、入力・出力、依存関係、所有者、重要な失敗ごとの影響を定義します。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立してください。通常ケース、境界条件、形式不正や欠損入力、分布シフト、依存障害、誤用、そして支援が不足しがちなグループや環境をテストします。タスク品質をキャリブレーションや不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティと共に測定します。すべての変換と閾値を記録し、独立したレビューアが結果を再現でき、魅力的なプロトタイプと証拠を区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止の権限を割り当てます。段階的ロールアウトを採用し、安全なフォールバックを保持し、意図的に障害を注入してモニタリングを検証します。運用テレメトリは、入力品質、出力挙動、モデルまたはルールのバージョン、依存状態、人間のオーバーライド、確認された結果を示すべきで、不要な機密データは収集しません。アラート閾値と対応責任者を定義し、展開後に実世界の証拠をレビューし、オフライン性能が持続すると仮定しないでください。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目標が変わるたびに再評価します。維持されたシステムは、復旧手順、インシデント学習、削除・保持手順、そして無効化または置換すべき明確なポイントを文書化する必要があります。
よくある質問
One-shot学習はFew-shot学習と同じですか?
One-shot学習は、クラスまたはタスクごとに1つのラベル付きサポート例がある特殊なケースです。Zero-shot学習はラベル付きターゲット例を使用しません。
Few-shot学習はデータの必要性をなくしますか?
いいえ。事前学習データ、関連タスク、表現、前提への依存がシフトします。ターゲットラベルは少数で、学習履歴全体は通常大量です。
主要参考文献