
AIの基礎
転移学習とは何か?

 Unite.AI を Google の優先ソースに追加
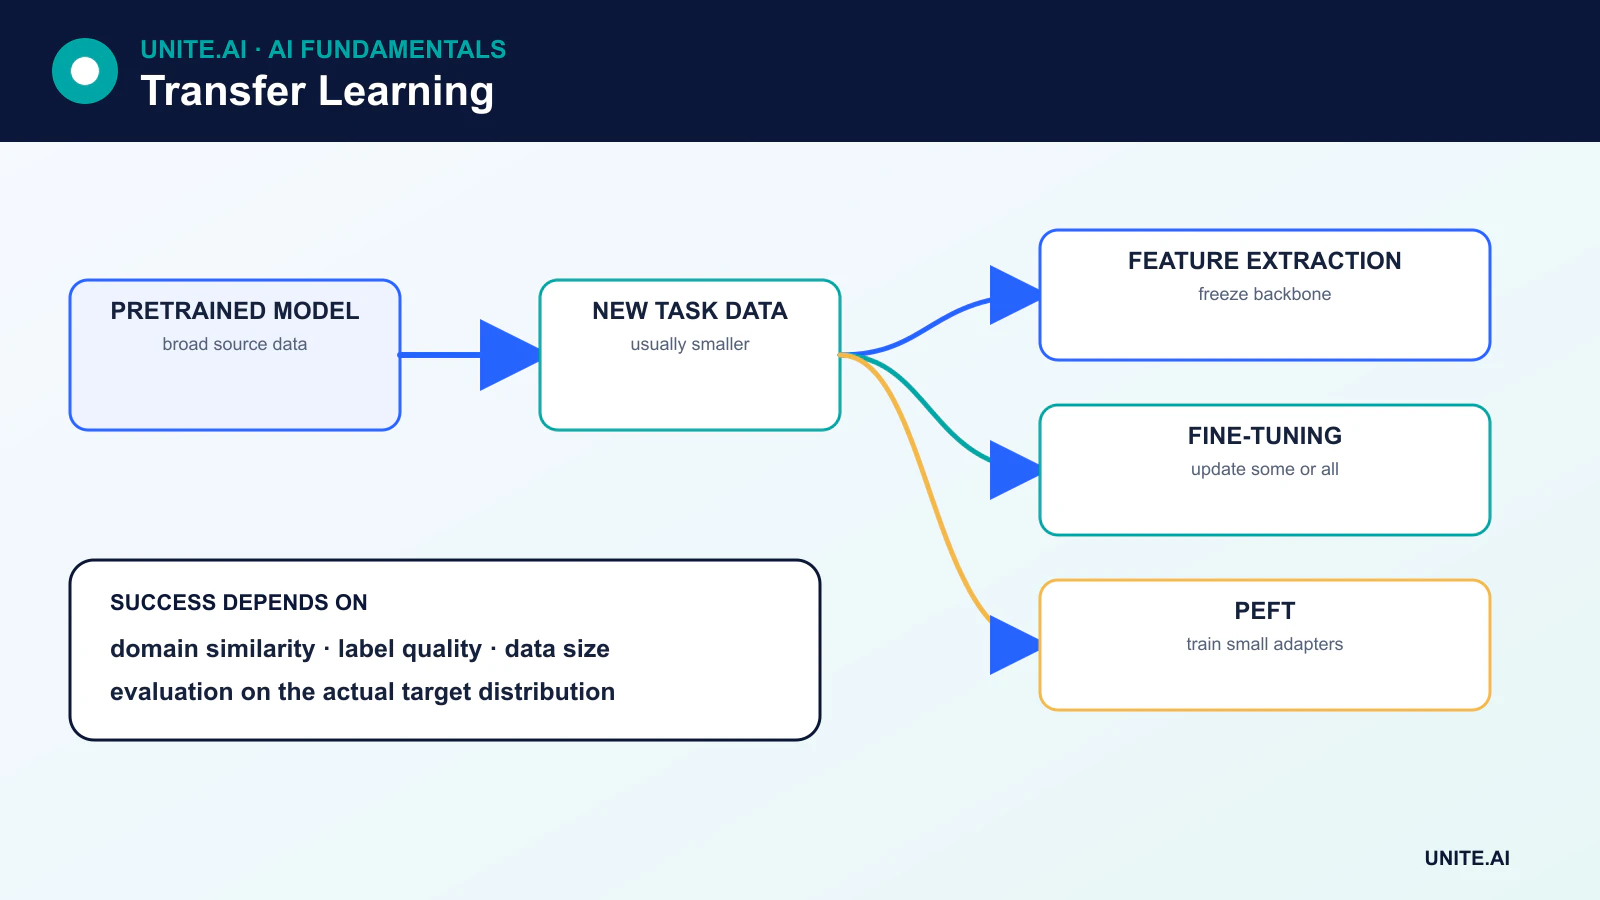
転移学習は、ある問題で学んだ知識を再利用して、関連する問題の学習を改善します。すべてのパラメータをランダムに初期化する代わりに、実務者は事前学習済みモデルまたは表現から開始し、対象タスクに適応させます。
このアプローチは、対象データセットが小規模であったり、ラベリングにコストがかかる場合、または事前学習に必要な計算リソースが対象チームの予算を超える場合に特に有用です。モデルをゼロから訓練することは転移学習の代替手段であり、転移学習の一種ではありません。
主なポイント
- 特徴抽出は、事前学習済みのベースを凍結したままにし、新しいタスク固有のヘッドを訓練します。
- ファインチューニングは、対象ドメインのデータを用いて、事前学習済みパラメータの一部または全部を更新します。
- アダプタやLoRAなどのパラメータ効率的手法は、モデルのごく一部のみを更新します。
- ソースドメインとターゲットドメインが異なる、ライセンスが衝突する、またはソースモデルに不適切なバイアスが含まれる場合、転移は失敗することがあります。
転移学習が機能する理由
モデルは、学習に用いたデータだけでなく、より広範に有用な表現を学習することがよくあります。画像モデルの初期層は再利用可能な局所パターンを捉え、言語モデルは自己教師あり予測から構文、意味、広範な関連性を学習します。対象タスクは、限られた例からすべてを再学習するのではなく、これらの表現を活用して構築できます。
その効果は、ソースタスクとターゲットタスクの類似度、事前学習の規模と品質、そしてモデルの適応方法に依存します。再利用が保証されているわけではなく、転移された特徴が無関係であったり、むしろ有害になることもあります。
特徴抽出
特徴抽出では、事前学習済みのベースを凍結し、パラメータが変化しないようにします。その出力は新しい分類器、回帰器、またはその他のタスク固有ヘッドへの入力となります。訓練されるのは新しいヘッドだけです。
この手法は高速でデータ効率が高く、有用な事前学習表現が破壊されるリスクを低減します。しかし、対象ドメインが事前学習と大きく異なる場合、過小適合になることもあります。バッチ正規化などの層は、保存された統計情報や訓練時の挙動が凍結された多くの重みがあっても適応に影響を与えるため、特別な注意が必要です。
ファインチューニング
ファインチューニングは、対象データ上で事前学習済みパラメータを更新します。一般的なワークフローは次のとおりです。
- 事前学習済みモデルをロードし、出力ヘッドを置き換えるか追加する。
- ベースを凍結し、新しいヘッドを訓練する。
- 選択した層(またはモデル全体)の凍結を解除し、より小さな学習率で続行する。
- 過学習、忘却、対象ドメインでの性能を検証する。
最終層だけをチューニングすべきという普遍的な規則はありません。最適な選択は、アーキテクチャ、対象データの規模、ドメインの類似度、正規化層、メモリ、計算資源に依存します。フルファインチューニングはより大きな容量を提供しますが、より多くのリソースを必要とし、破滅的な忘却を引き起こす可能性があります。
パラメータ効率的ファインチューニング
大規模なトランスフォーマーはフルファインチューニングを高コストにします。パラメータ効率的ファインチューニング(PEFT)は、ベースモデルの大部分を凍結したまま、少数のパラメータを変更または追加します。
- アダプタは、ネットワークに小さな学習可能モジュールを挿入します。
- LoRAは、重みの更新を低ランク行列で表現し、学習可能パラメータとオプティマイザのメモリ使用量を削減します。
- プロンプトおよびプレフィックスチューニングは、連続的なタスク固有入力または内部プレフィックスを学習します。
PEFTは、1つのベースモデルに多数のタスク適応を格納できますが、推論時の提供、アダプタの互換性、統合された重みの管理には依然として慎重なエンジニアリングが必要です。
データタイプを超えた転移学習
画像分類器は、通常、大規模画像データセットで事前学習されたモデルから開始します。言語システムは基盤モデルから始まり、教師ありファインチューニング、好みの最適化、検索、あるいはツール利用を通じて適応させます。音声、オーディオ、タンパク質、マルチモーダルモデルも同様のパターンに従います。
転移は、元のモデルを変更せずに行うことも可能です。凍結されたモデルは、下流の分類器やベクトル類似検索システム、あるいは検索パイプラインのための埋め込みを生成できます。
ドメインシフトとネガティブ転移
ドメインシフトは、対象入力がソースデータと異なる場合に発生します。例えば、医療画像モデルは、事前学習に含まれなかった機器、患者層、取得プロトコルに直面することがあります。ネガティブ転移とは、再利用により対象タスクの性能が、適切なゼロからのベースラインよりも悪化することを指します。
チームは適応戦略を比較し、意味のあるサブグループを評価し、対象ドメインのテストセットを保持すべきです。ソースタスクとの適合性が低い場合、より小さなドメイン固有モデルが大規模な汎用モデルを上回ることがあります。
ライセンス、出所、セキュリティ
ダウンロード可能なモデルが自動的に安全にデプロイできるわけではありません。ライセンス、許可された利用範囲、学習データの開示情報、モデルカードの制限、依存関係のチェーンを確認してください。モデルはバイアスを再現したり、機密データを記憶したり、悪意のあるシリアライズコードを含む可能性があります。信頼できるフォーマットを使用し、アーティファクトをスキャンし、信頼できない重みは分離された環境でロードしてください。
転移学習を使用すべき時期
関連する事前学習モデルが存在し、対象データが限られている場合、転移学習は強力なデフォルト選択です。ドメインが高度に専門的であったり、ライセンスが合わなかったり、モデルサイズがデプロイ上限を超える場合、またはシンプルなタスクが大規模な事前学習表現から恩恵を受けない場合は、ゼロからの訓練が好まれることがあります。判断はモデル規模だけで推測せず、実証的に検証すべきです。
何が転移でき、どのように適応させるか
転移学習は、ソースタスクまたはデータセットで学習した表現を対象タスクに再利用します。視覚領域では、初期の特徴がエッジやテクスチャを捉えることが多く、言語領域では、事前学習モデルがトークンやコンテキスト間の統計的パターンをエンコードします。ソース表現が対象に関連する情報を含む場合に転移は機能しますが、ドメイン、ラベル、モダリティ、取得方法の違いがネガティブ転移を引き起こすことがあります。事前学習ベースラインから開始し、学習ライセンスとドキュメントを確認し、ゼロから小規模な対象固有モデルを訓練する場合と比較してください。
特徴抽出はバックボーンを凍結し新しいヘッドを訓練します。部分的ファインチューニングは選択した層の凍結を解除し、フルファインチューニングはモデル全体を更新します。パラメータ効率的手法はアダプタや低ランク更新を追加し、学習可能パラメータは削減しますが、必ずしも推論時のメモリが削減されるわけではありません。事前学習重みには低い学習率を使用し、正規化の挙動を保持し、必要に応じてスケジュール、正則化、リハーサル、制約付き更新で破滅的忘却を防ぎます。対象の検証データ上でチェックポイントを選択し、種(シード)を複数試すべきです。小規模な対象データセットは高い分散を生むためです。
データ、評価、デプロイのトレードオフ
対象データは、デプロイ条件や重要なサブグループを代表すべきであり、単に便利なラベル付けサンプルであってはなりません。被験者、ソース、時間、場所で分割し、関連する例がパーティションを跨がないようにします。インドメインとシフト条件の両方でテストします。凍結、部分チューニング、フルチューニングの各バリアントを品質、キャリブレーション、訓練コスト、レイテンシ、ロバスト性で比較します。平均スコアの向上が、ソースバイアスから受け継がれた稀少クラスでの性能低下を隠すことがあります。ソース固有のショートカット、語彙ギャップ、センサー差異に関する失敗例をレビューしてください。
ベースモデル、重み、トークナイザまたは前処理、アダプタ、データ、ライセンスを一つの依存関係グラフとして追跡します。ホスト型ベースモデルは挙動を変えることがあり、オープンウェイトはサプライチェーンやパッチ適用の責任を生じさせます。統合またはエクスポートされた成果物を検証し、信頼できないソースからのモデルファイルをスキャンしてください。運用時には対象ドリフトと性能を監視し、適応版とベース版の両方をロールバックできるようにします。転移は必要な対象データ量を削減しますが、ラベリング、評価、プライバシー、ドメイン専門知識を不要にするわけではありません。
実例:ビジョンモデルを新しい診療所に適応させる
ある診療所は、診断レビュー前に画像品質を分類するために、事前学習済みの画像エンコーダを適応させます。ソースモデルのライセンスと対象モダリティを確認し、ローカルのデバイスと取得条件を収集し、患者単位で分割します。凍結特徴、アダプタ、部分的、フルファインチューニングの各バリアントを小規模なローカルベースラインと比較します。指標はクラスリコール、キャリブレーション、サブグループの挙動、計算コスト、デバイス・サイト・稀少アーティファクトへの感度を含みます。
適応されたモデルは診断を行わず、信頼度が低いまたはサポート外の画像を技術者に振り分けます。エクスポート検証によりローカル前処理と数値的等価性が確認されます。モデル、アダプタ、デバイス、データセットのバージョンは記録にリンクされます。モニタリングは新しいスキャナ、プロトコル変更、出力ドリフトを検出し、定期的にレビューされたサンプルで実際の性能を推定します。ソースモデルのアップグレードは新たな依存関係として扱われ、検証が必要です。転移学習は古いエビデンスを自動的に再利用する正当化にはなりません。
実装エビデンスと運用準備
本番環境での導入判断は、成功したデモだけでは不十分です。想定ユーザー、運用環境、入力、出力、依存関係、所有者、重要な失敗ごとの影響を定義します。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立します。通常ケース、境界条件、形式不正や欠損入力、分布シフト、依存障害、誤用、そして支援が不足しがちなグループや環境をテストします。タスク品質をキャリブレーションや不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティと共に測定します。すべての変換と閾値を記録し、独立したレビューアが結果を再現し、魅力的なプロトタイプとエビデンスを区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止の権限を割り当てます。段階的ロールアウトを使用し、安全なフォールバックを保持し、意図的に注入した障害でモニタリングを検証します。運用テレメトリは、入力品質、出力挙動、モデルまたはルールのバージョン、依存関係の健全性、人間によるオーバーライド、確認された結果を示すべきで、不要な機密データは収集しません。アラート閾値と対応責任者を定義し、デプロイ後に実世界のエビデンスをレビューし、オフライン性能が継続すると仮定しないでください。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目的が変わるたびに再評価します。維持されたシステムは、文書化された復旧手順、インシデント学習、削除・保持手順、そして無効化または置換すべき明確なポイントも必要です。
主要参考文献











