
AIの基礎
メタラーニングとは何か?

 Unite.AI を Google の優先ソースに追加
メタラーニングは、タスクの分布にわたってシステムを訓練し、限られたデータや計算で新しい関連タスクに適応できるようにします。しばしば「学習することを学ぶ」と要約されますが、技術的な目的はより正確に言えば、以前のタスクでの経験が後のタスクへの適応を改善するように学習者を最適化することです。
メタラーニングはfew-shot learning(少数ショット学習)やtransfer learning(転移学習)と重なる部分がありますが、これらの用語は互換性がありません。few-shotは対象データの量を指し、transferは再利用を指し、メタラーニングはタスク間の適応を訓練の一部として明示的に組み込みます。
主なポイント
- メタトレーニングは多数のタスクを使用し、単なる多数の独立したサンプルだけではありません。
- N-way K-shot エピソードは N クラスと、各クラスにつき K 個のラベル付きサポート例を含みます。
- 勾配ベース、メトリックベース、メモリベース、学習型オプティマイザの各手法は異なる方法で適応します。
- 性能はメタトレーニングタスクが対象タスクにどれだけ似ているかに大きく依存します。
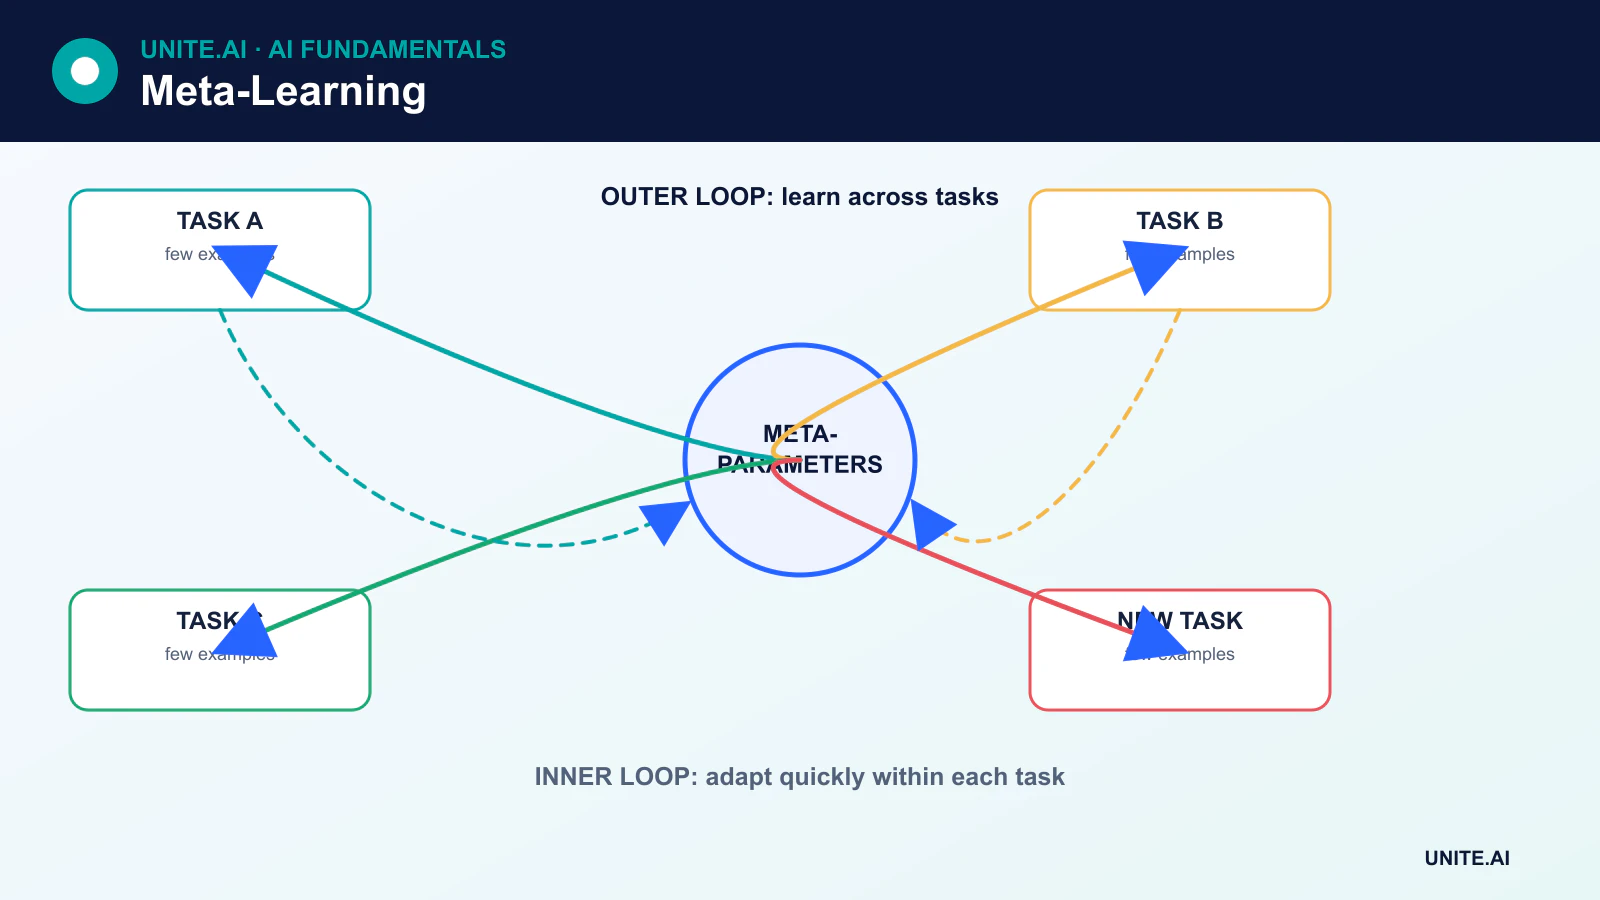
タスク、サポートセット、クエリセット
メタラーニングのデータセットはタスク単位で構成されます。few-shot分類では、エピソードは5-way 1-shot: 5つのクラス、各クラスにつき1つのラベル付きサポート例、そして適応を評価するための追加のクエリ例となります。5-way 5-shot タスクは、5つのクラスそれぞれに5つのサポート例があるので、合計5例というわけではありません。
メタトレーニング中、学習者はサポートセット上で繰り返し適応し、クエリセットで評価されます。外側の目的は、タスク全体で将来のクエリ性能を向上させることです。メタバリデーションは別タスクで選択肢を調整し、メタテストは実際に未見のタスクやクラスを評価します。
勾配ベースのメタラーニング
Model-Agnostic Meta-Learning(MAML)は、少数の勾配ステップで新しいタスクで良好な性能を得られる初期化パラメータを学習します。内部ループはサポートデータを用いてモデルパラメータを適応させ、外部ループはサンプリングされたタスク全体のクエリ損失を用いて共有初期化を更新します。
MAMLは分類に限らず、モデルとタスクが微分可能であれば回帰や強化学習にも適用できます。Reptile は、完全な MAML のメタ勾配を計算せずに、パラメータをタスク適応解へと移動させるシンプルな一次近似手法を提供します。
メトリックベースのメタラーニング
メトリックベースの手法は、同じクラスの例が近く、異なるクラスが離れるような埋め込み空間を学習します。プロトタイプネットワークはサポート埋め込みを平均してクラスごとに1つのプロトタイプを作成し、クエリはそれらプロトタイプとの距離で分類されます。
Matching ネットワークや Siamese 形式のネットワークは、類似性メカニズムを利用します。これらの手法は、モデルが「目標メトリックにヒットしたか」を単に確認するだけでなく、学習された距離や表現自体が予測手順の一部となります。
メモリベースの手法と学習型オプティマイザ
メモリベースのシステムは、リカレントまたは注意機構を用いて現在のタスクに関する情報を保持します。学習型オプティマイザは勾配や学習信号を入力として受け取り、別のモデルの更新方法を学習します。これらの手法は適応規則を発見できる一方で、パラメータや計算コストが増加し、過学習のリスクも高まります。
メタラーニングとインコンテキスト学習
大規模なトランスフォーマーは、プロンプトに与えられた例から重みを更新せずに出力を適応させることができます。これをインコンテキスト学習と呼びます。メタラーニングの振る舞いに似ていますが、学習データがタスク推論を促すことはあっても、インコンテキスト学習者が古典的なエピソード型メタラーニング目的で自動的に訓練されるわけではありません。
メタラーニングが有用な領域
主な応用例として、パーソナライズ、ロボティクス、データが限られた認識、測定回数が少ない科学的タスク、そして新環境への迅速な適応が挙げられます。多数の関連ソースタスクが利用可能である一方、対象タスクのデータが乏しい場合にメタラーニングは特に魅力的です。
制限事項
メタラーニングは、適応を最適化プロセスの内部に組み込むため、計算コストが高くなることがあります。結果はタスク構成、サポート/クエリの情報漏洩、アーキテクチャ、ドメインシフトに敏感です。狭く均質なタスクで訓練されたモデルは、その分布外での適応が乏しい可能性があります。
比較には従来の転移学習やマルチタスクのベースラインを含めるべきです。強力な事前学習表現に標準的なファインチューニングを組み合わせる方が、専用のメタラーニングアルゴリズムよりもシンプルで効果的な場合があります。
タスク、適応、そして内外最適化構造
メタラーニングはタスクの分布上で訓練し、学習者が限られたデータや更新で新しいタスクに適応できるようにします。各エピソードはタスクをサンプリングし、例を適応に用いるサポートセットと評価に用いるクエリセットに分割し、エピソード間で共有知識を更新します。メトリックベースの手法は埋め込みと比較規則を学習し、最適化ベースの手法は初期化や更新挙動を学習し、メモリ・モデルベースの手法はタスク例に条件付けます。タスク分布は実際の訓練データであり、将来の適応問題に似ている必要があります。
モデル非依存型メタラーニングでは、内部ループがサポート例上でパラメータを適応させ、外部ループが適応後のクエリ例での性能を最適化します。高次勾配はコストが高くなることがあり、一次近似は忠実度とコストのトレードオフです。プロトタイプネットワークは各クラスをサポートセットの中心で表現し、距離に基づいて分類します。これらの手法は、クラスの幾何学、適応ステップ、エピソード構成が実運用を反映していることを前提とします。固定ラベルや取得アーティファクト、ソースデータセット間の重複を利用して、手法が実際よりも速く学習しているように見えることがあります。
評価、ベースライン、実世界の制限
真に未見タスクへの適応を測定するために、訓練・バリデーション・テストタスクを分離し、単なるサンプルではなくタスク単位で評価します。ショット数や適応ステップ数に応じた精度または損失、タスク間の信頼区間、計算量、メモリ使用量、サポートセット構成への感度を報告します。転移学習、事前学習モデルのファインチューニング、最近傍法、すべてのソースデータを共同で訓練したモデルと比較します。ベースラインが同等のバックボーン、データ拡張、チューニングを受けると、見かけ上のメタラーニングの利得は縮小することが多いです。
実運用では、新しいタスクがメタトレーニング分布の外にあることを検知する手段が必要です。品質の低い、またはラベルが誤ったサポート例は、迅速かつ自信過剰な失敗を引き起こす可能性があります。更新幅を制限し、適応モデルを検証し、フォールバックを保持し、適応データを汚染から保護します。ベースモデル、タスクサンプラー、エピソードシード、適応コードを追跡します。メタラーニングは小規模データ問題の繰り返しファミリーに有用ですが、任意の例から一般的な学習能力を創出するわけでも、ドメイン固有の評価の必要性を排除するわけでもありません。
実例: 機械間のfew-shot適応
あるメーカーは、各機種をタスクとして扱い、検証済みの保守結果を持つ多数の機械に対して異常表現をメタトレーニングします。テスト対象の機械はタスク訓練から完全に除外されます。新しい機械に対しては、任意の数分のデータではなく、正常な稼働モードをカバーする少量のサポートセットを使用します。メタラーニングは、同じサポート例と計算資源を用いた事前学習済みの凍結エンコーダ、最近傍法、従来のファインチューニングと比較されます。
評価は多数のサポート選択を繰り返し、イベント再現率、誤報、適応時間、分散を報告します。新しい機械のセンサー構成やダイナミクスがタスク分布外の場合、システムは応答を控えます。適応更新は上限を設け、保守に影響を与える前にレビューされます。サポートラベルと機械の識別情報は汚染から保護され、すべての適応モデルはベースバージョンと例を保持します。実際的なタスクシフト下で、シンプルな転移学習を常に上回る場合にのみ、迅速な適応が受け入れられます。
実装証拠と運用準備性
本番導入の判断は、単なる成功デモだけでは不十分です。想定ユーザー、運用環境、入力・出力、依存関係、所有者、重要な障害ごとの影響を明確に定義します。チューニング前に再現可能なベースラインとバージョン管理された評価セットを構築します。通常ケース、境界条件、形式不正や欠損入力、分布シフト、依存障害、誤用、そして支援が不足しがちなグループや環境をテストします。タスク品質をキャリブレーションや不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティと共に測定します。すべての変換と閾値を記録し、独立したレビューアが結果を再現し、魅力的なプロトタイプと証拠を区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止の権限を割り当てます。段階的ロールアウトを採用し、安全なフォールバックを保持し、意図的に失敗を注入して監視を検証します。運用テレメトリは、入力品質、出力挙動、モデルまたはルールのバージョン、依存性の健全性、人間によるオーバーライド、確認済み結果を示すべきで、不要な機密データは収集しません。アラート閾値と対応責任者を定義し、オフライン性能が持続すると仮定せず、デプロイ後に実世界の証拠をレビューします。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目的が変わるたびに再評価します。維持されたシステムは、文書化された復旧手順、インシデント学習、削除・保持手順、そして無効化または置換すべき明確なタイミングも必要です。
よくある質問
few-shot プロンプトはメタラーニングですか?
few-shot プロンプトはインコンテキスト適応手法です。タスク間の学習に関連する振る舞いを示すことがありますが、サポート/クエリエピソードや明示的なメタ最適化ループで自動的に訓練されるわけではありません。
メタラーニングの最大リスクは何ですか?
メタトレーニングタスクと対象タスクの不一致は、ベンチマーク上では迅速な適応が優れているように見えても、実運用では失敗する原因となります。タスクの分割やソースの出所は、通常の訓練/テスト分割と同様に厳密に監査する必要があります。
主要参考文献











