
AIの基礎
勾配降下法とは何か?

 Unite.AI を Google の優先ソースに追加
勾配降下法は、目的関数を減少させるためにモデルのパラメータを調整する最適化手法です。ニューラルネットワークの学習では、目的は通常、サンプル上で計算される損失です。勾配は局所的に最も急激に増加する方向を示すので、勾配降下法はその逆方向へステップを踏みます。
勾配は局所的な感度を示しますが、その大きさはモデルがどれだけ速く「学習」しているかの直接的な指標ではありません。実際の進捗は学習率、曲率、ノイズ、パラメータ化、オプティマイザの状態、データにも依存します。
重要なポイント
- 逆伝播は勾配を計算し、勾配降下法はそれをパラメータ更新に利用します。
- ミニバッチ最適化は、ディープラーニングにおける標準的な実践手法です。
- 学習率は更新のスケールを制御し、必ずしも各ステップ後に減衰するわけではなく、スケジュールに従うことがあります。
- モメンタム、AdamW、クリッピング、正規化はそれぞれ異なる最適化課題に対処します。
基本的な更新則
パラメータベクトル θ、学習率 η、損失 L:
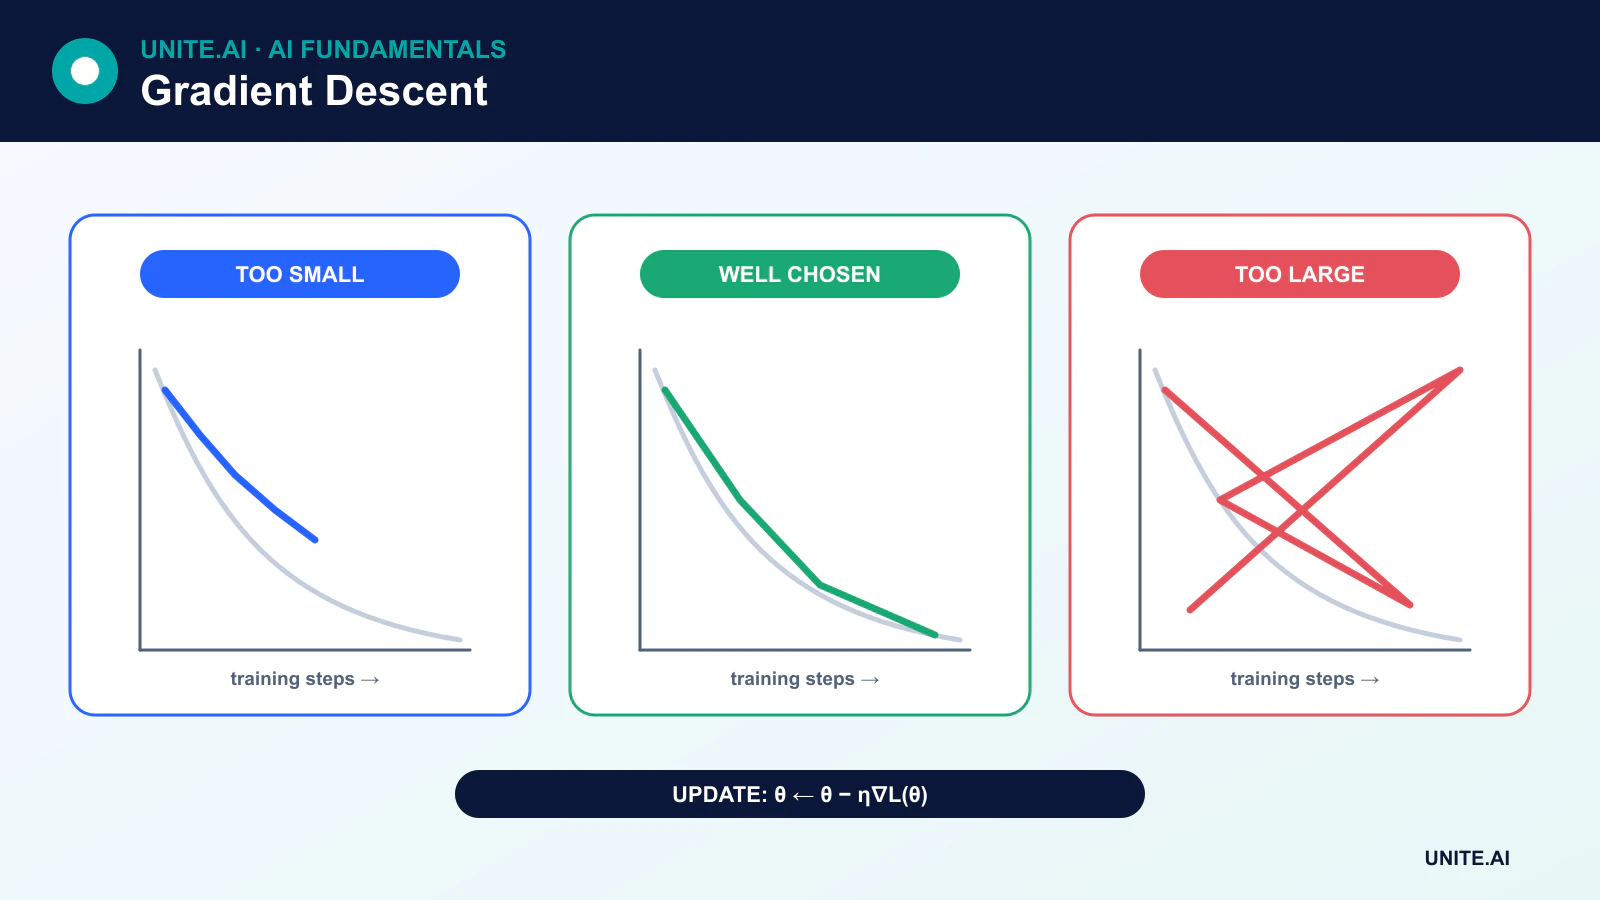
θ ← θ - η∇L(θ)
勾配 ∇L(θ) は各パラメータに対する偏微分を1つずつ含みます。これを減算することで局所的に下り坂へ移動します。定常点では勾配がゼロですが、最小点、最大点、鞍点、あるいは平坦な領域である可能性があります。ディープラーニングの損失曲面は非凸であるため、学習が一意のグローバル最小値やゼロ損失を必ず見つけられるわけではありません。
バッチ、確率的、ミニバッチ手法
バッチ勾配降下法
バッチ勾配降下法は、各更新ごとに全トレーニングセットを用いて勾配を計算します。この推定は安定していますが、時間とメモリのコストが高く、1回の更新では最新のアクセラレータを十分に活用できないことがあります。
確率的勾配降下法
厳密な確率的勾配降下法は、各更新でランダムに選択された1つのサンプルを使用します。勾配はノイズを含むため損失曲面の探索に役立ちますが、単一サンプルの操作は並列ハードウェア上で非効率になることがあります。
ミニバッチ勾配降下法
ミニバッチ学習は、サンプルのサブセットから勾配を推定します。統計的ノイズと効率的な行列演算のバランスを取り、ディープラーニングで一般的に用いられます。バッチサイズはメモリ、スループット、勾配ノイズ、正規化、場合によっては汎化性能に影響します。
学習率の選択
学習率が大きすぎると有用な領域を飛び越えて発散する可能性があります。逆に小さすぎると学習が実用的でないほど遅くなったり、平坦な領域で停滞したりします。最適なスケールはオプティマイザ、バッチサイズ、モデル、初期化、目的関数に依存します。
スケジュールは徐々にウォームアップしたり、マイルストーンで減衰したり、余弦曲線に従ったり、検証の進捗に応じて変化させることができます。学習率は各更新後に必ず単調に減少する必要はありません。ウォームリスタートやサイクルスケジュールは、学習の一部で意図的に学習率を上げます。
モメンタム
モメンタムは過去の勾配の指数移動平均を保持します。一定方向への進行を加速し、急峻で狭い方向での振動を抑制します。Nesterov 方式のモメンタムは、モメンタム方向に先行して勾配を評価または近似します。
適応型オプティマイザ
RMSProp は二乗勾配の移動平均を用いて更新をスケーリングします。Adam はモメンタムに似た一次モーメントと二次モーメントのスケーリングを組み合わせます。AdamW は重み減衰を適応的勾配更新から切り離し、トランスフォーマーで広く使用されています。
適応型オプティマイザは初期の学習を容易にすることが多いですが、すべてのモデルや最終的な汎化目標に対して自動的に優れているわけではありません。オプティマイザの比較にはスケジュールを合わせ、慎重なチューニングが必要です。
勾配クリッピングと蓄積
勾配クリッピングは勾配のノルムや値を上限で制限し、特にリカレントや不安定な学習における勾配爆発の影響を軽減します。勾配蓄積は、更新前に複数の小バッチの勾配を加算し、メモリが制限されている場合に大きな有効バッチを近似します。
最適化のモニタリング
トレーニングと検証の損失、タスク指標、学習率、勾配ノルム、パラメータノルム、数値エラーを追跡します。トレーニング損失が減少しても検証性能が悪化する場合、これは過学習を示すものであり、最適化が自動的に継続すべき成功とは言えません。
最適化は与えられた目的関数を最小化します。低い損失がデータや指標、実世界での振る舞いが適切であることを証明するわけではありません。情報漏洩、ラベルの質の低さ、目的関数の不整合は、最適化はされていても有害なモデルを生み出す可能性があります。
最適化の幾何学と更新則
勾配降下法は損失の勾配と反対方向にパラメータを更新します。フルバッチ降下は各ステップで全トレーニング例を使用し、確率的降下は1つ、ミニバッチ手法はサブセットから勾配を推定し、ディープラーニングを支配しています。学習率はステップのスケールを決定します。小さすぎると計算が無駄になり停滞し、大きすぎると振動や発散を招きます。モメンタムは方向を蓄積し、Adam などの適応手法は勾配モーメントを用いて座標をスケーリングします。これらの暗黙のバイアスの違いにより、訓練損失は似ても汎化性能が異なるモデルが生まれます。
ニューラルネットワークの損失曲面は、平坦領域と鋭い領域、鞍点、対称性、条件の悪い方向を含みます。特徴量のスケーリング、正規化、初期化、残差接続、事前条件付けはオプティマイザが見る幾何学を変化させます。スケジュールはウォームアップ、減衰、サイクル、またはプラトーへの反応が可能です。一部の適応型オプティマイザでは、重み減衰は単なる L2 ペナルティの追加とは異なります。バッチサイズはノイズ、メモリ、並列性、学習率のレジームに影響するため、オプティマイザ比較にはトレーニング予算を合わせ、慎重にチューニングする必要があります。
診断、再現性、停止基準
トレーニングと検証の損失、タスク指標、勾配・パラメータノルム、学習率、スループット、数値警告を追跡します。発散は破損したバッチ、無効なラベル、不安定な混合精度、または不適切な損失集約から生じることがあります。プラトーは容量不足、活性化の飽和、特徴量の質の低さ、過剰な正則化、スケジュールの問題を示すことがあります。過学習にはデータ、データ拡張、正則化、早期停止が必要であり、オプティマイザが失敗したという主張ではありません。代表的なエラーを検査し、学習の複雑さを上げる前にシンプルなベースラインと比較します。
再現性にはシード、データ順序、コード、設定、ハードウェア・ライブラリのバージョンが必要ですが、一部のアクセラレータカーネルは非決定的です。オプティマイザとスケジューラの状態を含むチェックポイントを保存し、トレーニングを一貫して再開できるようにします。事前に決めた検証基準でチェックポイントを選択し、未使用のテストセットを確保します。分散学習では有効バッチサイズ、勾配平均、失敗したワーカーの取り扱いを確認します。最適化は利用可能なデータ上で選択された目的関数を最小化しますが、確率の校正、因果推論、公平性、安全性、実世界での有用性を保証するものではありません。
実例:言語モデル向けオプティマイザのチューニング
あるチームはトークナイザ、データ順序、モデル、実効バッチ、トレーニングトークン予算を固定し、妥当な学習率スケジュール下でモメンタム付きSGDとAdamWを比較します。ウォームアップ、減衰、重み減衰、クリッピング、精度が記録されます。各候補は複数のシードで実行し、検証は保持した時間スライスとタスク評価を使用します。スループットとエネルギーは損失と共に報告され、わずかに優れたオプティマイザが過度なコストで選ばれることを防ぎます。
診断により不安定性が特定のデータシャード、過大なステップサイズ、アンダーフロー、またはモデル構造に起因するかが明らかになります。チェックポイントはオプティマイザとスケジューラの状態を保持し、テストで再開されます。最終的な選択は最低のトレーニング損失ではなく、検証品質とロバスト性に基づきます。選択後にシールドされたテストセットが一度実行されます。プロダクションでの推論は別途校正・モニタリングされ、事前学習時のオプティマイザの成功が安全または真実性を保証するわけではありません。
実装の証拠と運用準備
プロダクションでの導入判断は、成功したデモだけでは不十分です。対象ユーザー、運用環境、入力・出力、依存関係、所有者、重要な障害ごとの影響を定義します。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立します。通常ケース、境界条件、欠損または不正な入力、分布シフト、依存障害、誤用、そして支援が不足しがちなユーザー層や環境をテストします。タスク品質を校正や不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティと共に測定します。すべての変換と閾値を記録し、独立したレビューアが結果を再現し、魅力的なプロトタイプと証拠を区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止の権限を割り当てます。段階的ロールアウトを使用し、安全なフォールバックを保持し、意図的に失敗を注入してモニタリングを検証します。運用テレメトリは、不要な機密データを収集せずに入力品質、出力挙動、モデルまたはルールのバージョン、依存性の健全性、人間の介入、確定した結果を示すべきです。アラート閾値と対応責任者を定義し、デプロイ後に実世界の証拠をレビューし、オフライン性能が継続すると仮定しないでください。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目的が変わるたびに再評価します。維持されるシステムは、文書化された復旧手順、インシデントからの学習、削除・保持手順、そして無効化または置換すべき明確なポイントも必要です。
よくある質問
勾配降下法は常にグローバル最小値に到達しますか?
いいえ。凸目的関数に対しては、適切な条件下で強い保証が得られますが、ディープネットワークの目的関数は非凸であり、実用的なオプティマイザは唯一のグローバル最小値を見つけたことを証明するよりも、実用的な解を探すことが一般的です。
なぜゼロ勾配は誤解を招くことがあるのですか?
ゼロまたは極小の勾配は、最小点、最大点、鞍点、飽和、あるいは平坦なプラトーを示す可能性があります。トレーニングの診断では、損失の履歴、曲率、パラメータのスケール、検証性能を考慮する必要があります。
主な参考文献












