
AIの基礎
線形回帰とは何ですか?

 Unite.AI を Google の優先ソースに追加
線形回帰は、連続的な目的変数を1つ以上の入力特徴量の線形結合としてモデル化します。予測、推定、そしてより複雑なモデルが有意な価値を付加するかどうかを理解するための透明なベースラインとして使用されます。
「独立変数」および「従属変数」という語は、モデル内での役割を示すものであり、因果関係が証明されたものではありません。回帰は、交絡や選択バイアス、逆因果、測定誤差が関係を説明している場合でも、関連性を特定することができます。
主なポイント
- 目的変数 y は入力特徴量 X からモデル化されます;この記事の旧バージョンでは、ある式の説明でこれらのラベルが逆転していました。
- 最小二乗法は残差の二乗和を最小化します。
- 残差の診断と仮定は推論と不確実性において重要です。
- リッジ回帰とラッソ正則化は、予測変数が多数ある場合や相関がある場合に有用です。
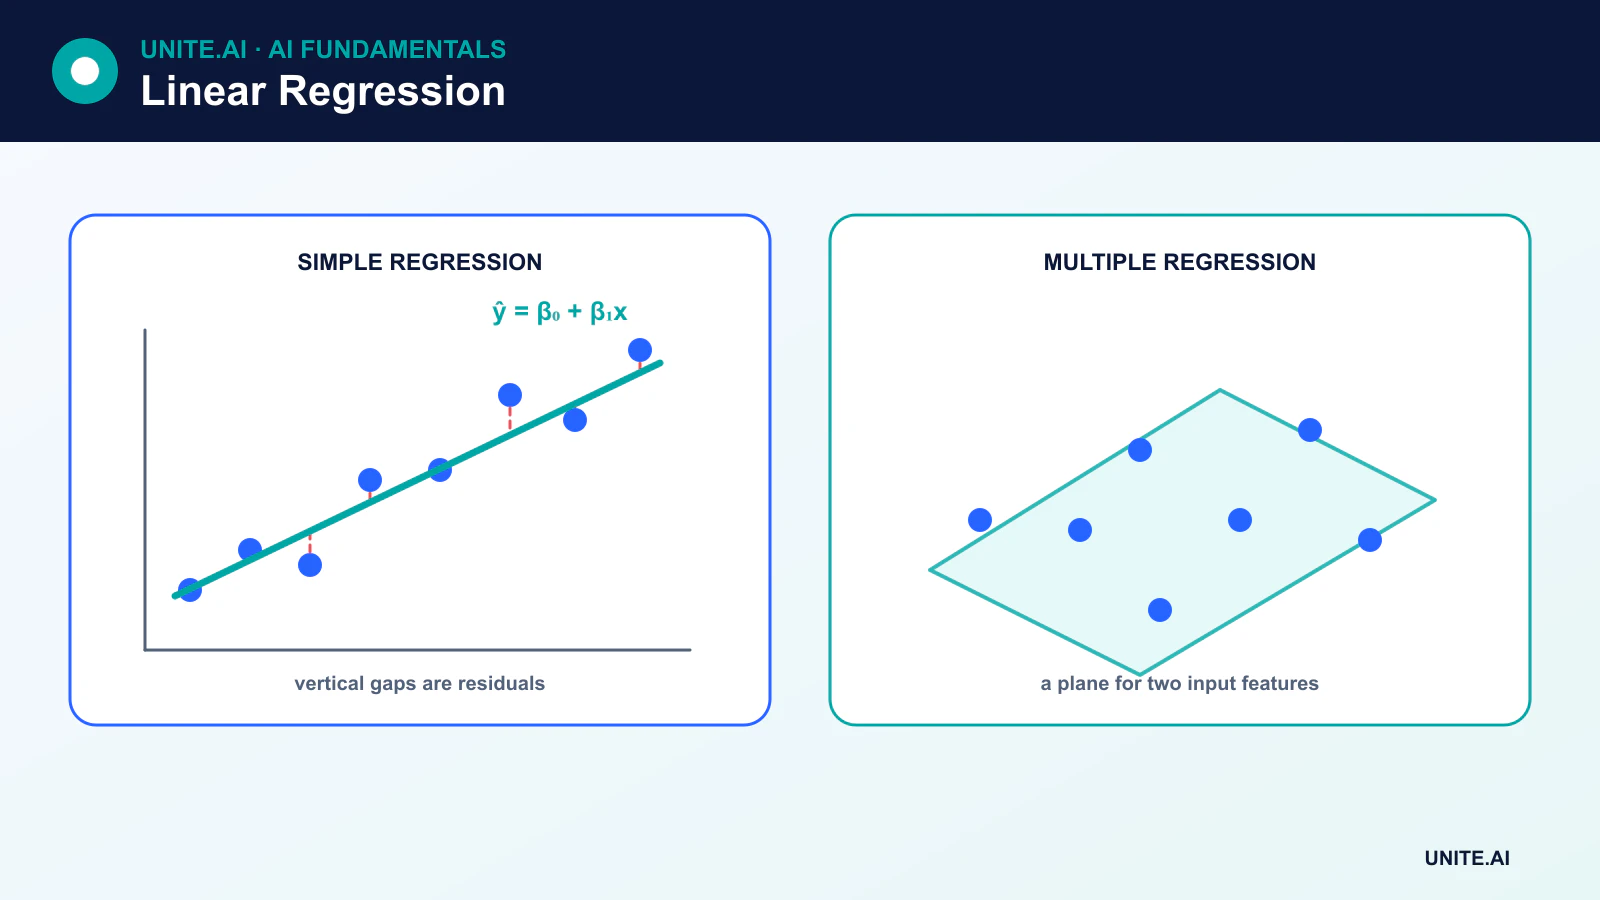
単回帰
特徴量が1つの場合、モデルは次のようになります:
ŷ = β₀ + β₁x
β₀ は切片、β₁ は傾きです。観測 i の残差は yᵢ - ŷᵢ です。最小二乗法(OLS)は残差の二乗和を最小化する係数を選択します。
傾きは、当てはめたモデルにおいて特徴量が1単位変化したときに目的変数が期待される変化量を推定します。研究デザインや仮定が因果同定を支持しない限り、因果効果として記述すべきではありません。
重回帰
p 個の特徴量がある場合:
ŷ = β₀ + β₁x₁ + β₂x₂ + … + βₚxₚ
各係数は、他の含まれる特徴量が一定であることを条件に解釈されます。重回帰は、エンコーディングや多項式項、交互作用を通じてカテゴリ変数を組み込むことができます。変換された特徴量(例:x²)が含まれていても、係数に対して線形であるため「線形」モデルと呼ばれます。
仮定と診断
予測においては、モデルがどれだけ汎化できるかが核心の質問です。古典的な係数検定や信頼区間を行う際には、以下の追加的な仮定が重要になります:
- 線形性: 条件付き平均が選択された線形形態で表されること。
- 独立性または正しくモデル化された誤差: 繰り返し、グループ化、空間的、または時系列の観測では、別の誤差構造が必要になることがあります。
- 誤差分散の一定性: 異分散性は標準誤差や不確実性の推定に影響します。
- 多重共線性の制限: 強く相関した予測変数は個々の係数を不安定にします。
- 残差の分布: 正規性は小サンプルの推論に関係しますが、すべての特徴量が正規分布である必要はありません。
残差プロット、レバレッジや影響度の指標、そしてドメインのレビューにより、外れ値、非線形性、分散の変化、またはフィットを支配する観測を特定できます。
予測の評価
- 平均絶対誤差(MAE)は絶対残差の平均サイズです。
- 平均二乗誤差(MSE)は大きな誤差により重みを付けます。
- 二乗平均平方根誤差(RMSE)は二乗誤差を目的変数の単位に戻します。
- R²は評価データにおける残差変動と一定のベースラインを比較します。
R²は精度を示す指標ではなく、因果関係を証明するものでもなく、保持データ上では負の値になることもあります。検証は実際の予測設定に合わせるべきで、必要に応じて時間やグループを考慮した分割を行う必要があります。
リッジ、ラッソ、エラスティックネット
リッジ回帰は係数を縮小し、相関する予測変数を安定化させるL2ペナルティを加えます。ラッソはL1ペナルティを加え、係数をゼロに設定できることがあります。エラスティックネットは両者を組み合わせた手法です。これらのペナルティを比較する前に、特徴量は通常、スケーリングを揃える必要があります。
正則化は分散を低減する代償としてバイアスを導入し、過学習を減らすことができます。ペナルティの強さは最終テストセットではなく、検証によって選択されます。
線形回帰が不適切なケース
関係が強く非線形である、誤差が過去の値に依存する、目的変数の分布が特殊なモデリングを必要とする、または少数の外れ値が二乗損失を支配する場合、線形モデルは失敗することがあります。決定木、一般化線形モデル、時系列モデル、ロバスト回帰、あるいは非線形手法の方が適合することがあります。
たとえ複雑なモデルが優れていても、線形回帰は価値あるベースラインとして残ります。大規模システムがそれを安定的に上回れない場合、追加された複雑さは正当化できないかもしれません。
モデルの仮定、推定、診断
線形回帰は、数値的アウトカムの条件付き平均を切片と重み付けされた予測変数の和としてモデル化します。最小二乗法は二乗残差を最小化する係数を選択します。係数は、指定されたモデルの下で他の変数を一定に保ったまま、予測変数が1単位変化したときの期待されるアウトカムの変化を示します。因果同定の仮定や研究デザインがそれを正当化しない限り、これは単なる関連です。単位、コーディング、変換、交互作用、参照カテゴリが解釈を決定するため、データ辞書がない係数は不完全です。
古典的推論は、特定の検定や区間のために関数形、独立誤差、一定分散、誤差分布に関する仮定に依存します。残差対適合値プロットは非線形性や異分散性を明らかにし、Q–Qプロットは裾の挙動を評価します。レバレッジと影響度の診断は推定に強く影響する観測を特定します。相関した予測変数は不確実性を膨らませ、予測が十分でも個々の係数を不安定にします。データポイントを削除する代わりに、ロバスト標準誤差、変換、スプライン、階層構造、あるいは別のモデルが必要になることがあります。
正則化、評価、そして責任ある利用
リッジ回帰はL2ペナルティで係数を縮小し、ラッソはL1ペナルティで一部の係数をゼロに設定できます。エラスティックネットはそれらを組み合わせます。ペナルティのスケールを揃える必要がある場合は予測変数を標準化し、検証またはクロスバリデーションで強さを選択します。平均絶対誤差、二乗平均平方根誤差、残差分布、範囲ごとのキャリブレーション、そして不確実性を、利用状況を反映した時間またはグループ分割で評価します。平均ベースラインや非線形代替手法と比較しますが、透明性と安定性が重要な場合は線形モデルを維持します。
観測された予測変数の範囲を超えて外挿すると、証拠なしに当てはめた直線に従うことになり、危険です。実運用では特徴量の範囲、欠損、残差、サブグループの誤差を監視します。予測区間は個々のアウトカムの不確実性を示し、平均の信頼区間よりも幅が広く、いずれも仮定が必要です。効果推定が目的の場合、因果バイアスを導入する変数の制御は避けてください。線形回帰は定義された関係に対する精密なツールであり、世界が線形であることや係数が介入を表すという普遍的な保証ではありません。
実例:配達時間の推定
物流チームは、距離、サービスレベル、地域、曜日、既知の天候から配達時間をモデル化します。非線形の残差パターンを検査し、線形方程式を文字通りの物理法則として扱うのではなく、正当なスプラインや交互作用を追加します。キャリアとルートのグループで検証フォールドを定義します。平均絶対誤差、裾誤差、区間カバレッジ、体系的バイアスが報告されます。キャンセルされた配達や到着後に記録されたデータは除外するか、明示的にモデル化します。
係数は単位で文書化され、相関する予測変数下での不安定性がチェックされます。モデルは検証済みの距離と地域の範囲を超える外挿を拒否します。予測区間が推定値に付随し、下流のスケジューリングはその不確実性を利用します。監視はネットワーク変更後の特徴量範囲、残差、区間カバレッジ、バイアスを追跡します。キャリアや天候に関する因果的主張は予測係数からは行われず、運用実験やより強固な同定が介入を支持するために必要です。
実装の証拠と運用準備性
本番導入の判断は、成功したデモだけでは不十分です。対象ユーザー、運用環境、入力、出力、依存関係、所有者、そして重要な障害ごとの影響を定義します。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立します。通常ケース、境界条件、形式不正や欠損入力、分布シフト、依存障害、誤用、そしてサービスが行き届きにくいグループや環境をテストします。タスク品質をキャリブレーションや不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティと共に測定します。すべての変換と閾値を記録し、独立したレビューアが結果を再現し、魅力的なプロトタイプと証拠を区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止の権限を割り当てます。段階的ロールアウトを使用し、安全なフォールバックを保持し、意図的に障害を注入して監視を検証します。運用テレメトリは、入力品質、出力挙動、モデルまたはルールのバージョン、依存の健全性、人間によるオーバーライド、確認された結果を、不要な機密データを収集せずに明らかにすべきです。アラート閾値と対応責任者を定義し、オフラインの性能が持続すると仮定せずに、デプロイ後の実世界の証拠をレビューします。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目標が変わるたびに再評価します。維持されたシステムは、復旧手順、インシデント学習、削除・保持手順、そして無効化または置換すべき明確なタイミングも文書化する必要があります。
よくある質問
線形回帰は入力変数が1つだけ必要ですか?
いいえ。単回帰は予測変数が1つですが、重回帰は多数の数値的特徴量、エンコードされたカテゴリ変数、変換された特徴量、そして交互作用特徴量を使用できます。
線形回帰は因果関係を証明できますか?
いいえ。因果的解釈には、妥当な研究デザインと交絡、選択、測定、介入に関する仮定が必要です。予測係数だけでは、当てはめたモデルにおける関連性を示すに過ぎません。
主要参考文献












